Harness-Zero: Harness Distillation via Agent-as-Harness ↗
Haoran Ye, Yuxing Lu, Haonan Dong, Zhaochen Su, Guojie Song
arXiv preprint (2026-09-21) · v1
- 문제: specialized harness의 trajectory는 student에게 없는 tool·정보에 의존해 그대로 학습시키기 어렵다.
- 방법: reviewer가 실행 전 student 응답을 target-native 행동으로 교정하고 accepted trajectory로 SFT한다.
- 결과: domain별 학습 student의 평균 성능이 개선되며, 배포에는 최소 target harness가 남는다.
문제와 배경
배경과 읽는 관점
좋은 harness가 성능을 올려도 배포할 때마다 그 전용 tool과 실행 제어를 유지해야 할 수 있다. 그 행동을 weights에 옮기려 해도 teacher에게만 있는 tool이나 정보가 trajectory에 섞이면 student가 그대로 따라 할 수 없다. 이 논문은 실행 절차의 개선을 더 단순한 배포 환경에서 재현 가능한 학습 데이터로 바꾸는 문제를 다룬다.
기존 접근과 연구 질문
Harness는 LLM에 tool·memory·skill·middleware를 제공한다. 잘 만든 harness는 성능을 올리지만, domain과 model이 바뀌면 다른 harness가 필요할 수 있다. 저자들은 이 개선을 외부 코드에만 남겨 두지 말고 모델 weights로 되돌릴 수 있는지 묻는다(§1).
단순한 trajectory distillation에는 두 장애물이 있다. Teacher가 student에게 없는 전용 tool을 사용했을 수 있고, teacher의 추가 guidance가 student-visible history에는 없을 수 있다. 이 trajectory를 그대로 모방하면 배포 환경에서 실행 불가능한 호출이나 근거 없는 행동을 배울 수 있다(§1, §3).
따라서 핵심은 teacher가 혼자 더 좋은 답을 만드는 것이 아니라, 현재 student가 처한 상태에서 target action space로 수행 가능한 다음 행동을 만들어 주는 것이다.
따라서 teacher의 성공 예시를 많이 모으는 것만으로 충분하지 않다. Student가 실제로 볼 수 있는 history와 실행할 수 있는 action 안에서 도움이 되는 다음 응답을 구성해야 한다. 이 글에서는 실행 전 교정, 학습 데이터에 남는 정보, 배포에서 제거되는 구성요소를 순서대로 살펴본다.
핵심 아이디어
먼저 직관으로 이해하기
Student가 제안한 행동을 실행하기 직전에 reviewer가 검토하고, 필요하면 target harness로 실행 가능한 행동으로 바꾼다. 실제로 실행한 accepted response와 관측만 student trajectory에 남긴 뒤 이를 학습한다. Reviewer가 가진 guidance의 효과를 배포 가능한 행동으로 번역하는 과정이다.
전체 구조: Figure 1 — Harness-Zero.
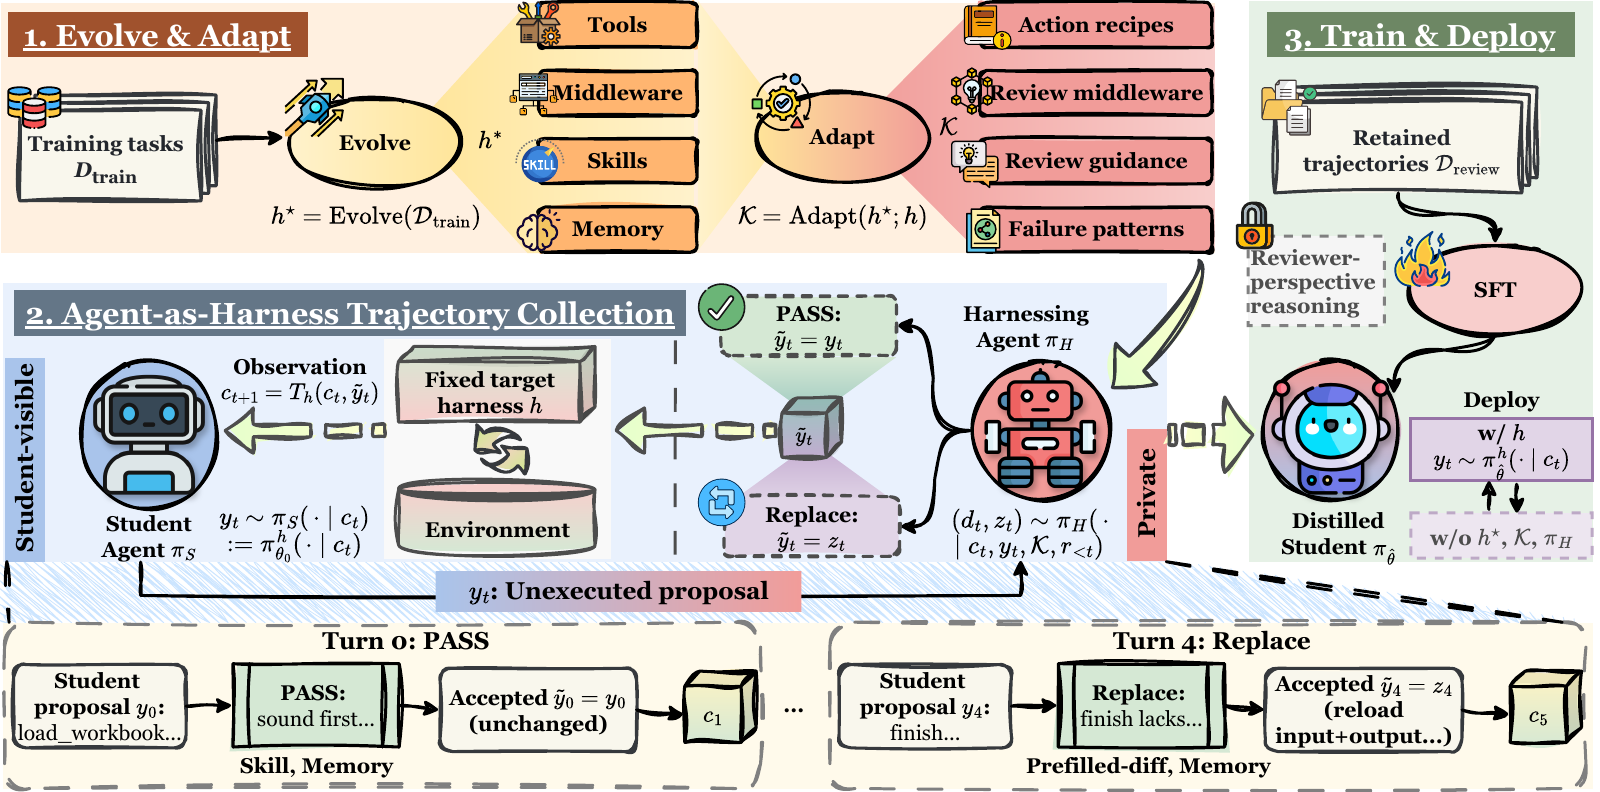
| 기호·구성 | 역할 |
|---|---|
h | 배포에도 사용하는 고정 target harness |
h★ | Training task에서 진화시킨 domain별 student-side harness |
K | h★를 reviewer용 private reference로 변환한 guidance |
Student πS | h 안에서 다음 응답을 제안 |
Harnessing agent πH | K와 student-visible history를 보고 pass 또는 replace 결정 |
Evolve → adapt
Training task의 실패를 분석해 tools·middleware·skills·memory를 수정하는 세 차례의 evolution을 수행한다. Domain마다 하나의 shared harness를 만든다. 개선된 harness의 전용 tool은 reviewer에게 target-native 동작을 구성하는 명세로, middleware는 private alert·review 기준으로, skills·memory는 진단·교정 guidance로 바꾼다(§3.1, App. A–B).
예를 들어 학생에게 없는 smiles_check라는 전용 호출을 모방시키는 대신, target의 Bash에서 RDKit을 실행해 분자를 검사하는 응답을 만들 수 있다. 절차의 의도를 유지하되 실행 수단은 target harness에 맞춘다.
Agent-as-harness
매 turn의 student 응답은 환경 실행 전에 reviewer에게 전달된다(§3.2).
- Student가 현재 context에서 응답
y를 제안한다. - Reviewer가
K를 읽고 proposal을 pass 또는 replace한다. - Accepted response
ỹ만h로 실행한다. - 실행된 응답과 관측 결과가 다음 student context에 들어간다.
- 같은 reviewer session이 rollout 전체를 따라간다.
Rejected draft와 private review 대화는 student trajectory에 넣지 않는다. Reviewer는 정상 proposal을 통과시키고, 바꿀 때는 필요한 최소한의 coherent correction을 만들도록 지시받는다(App. C).
Reviewer는 K에만 privileged access가 있다. 주 방법에서는 정답·hidden verifier feedback·student가 보지 못한 환경 상태를 읽지 못한다. 추가 evidence가 필요하면 student의 허용 action으로 검사를 제안하고 그 실행 결과를 trajectory에 남겨야 한다. Oracle answer를 주는 조건은 별도 ablation이다.
Reviewed trajectory로 SFT
변경하지 않은 student 응답과 reviewer의 replacement를 모두 학습한다. Replacement에 reviewer 시점의 reasoning이 섞이면 해당 reasoning span을 loss에서 mask한다. Private path·review tool name 등이 유출된 trajectory도 제외한다(§3.3, App. D).
배포에는 fine-tuned student와 h만 남는다. Specialized h★, reference K, reviewer는 제거한다.
정의와 수식
고정 target harness의 transition을 Th라고 하면 수집 loop는 다음과 같다(§3.2). \(y_t\sim\pi_S(\cdot\mid c_t),\qquad \tilde y_t=\operatorname{Review}(c_t,y_t,K,r_{<t}),\) \(c_{t+1}=T_h(c_t,\tilde y_t).\) r<t는 reviewer의 private history이며 환경 reward 기호가 아니다. Accepted response는 h의 action space에서 실행 가능해야 한다.
SFT는 accepted response의 likelihood를 높인다. 실제 loss에는 앞서 설명한 reasoning mask가 적용된다(§3.3). \(\hat\theta=\arg\min_\theta -\sum_{\tau\in D_{\rm review}}\sum_t \log\pi_\theta^h(\tilde y_t\mid c_t).\) 이는 RL이나 pairwise preference optimization이 아니다. Rejected·accepted pair를 preference learning에 활용하는 것은 후속 방향으로 제안한다(§5).
실험과 핵심 결과
실험 설정
| Domain | Evolution·collection split | Held-out 평가 | Metric |
|---|---|---|---|
| SpreadsheetBench Verified | 300 tasks | 100 tasks | Pass@1 |
| AppWorld | Train+dev 147 tasks | test_normal 168 tasks, 56 scenarios | Scenario goal completion(SGC) |
| USPTO Retrosynthesis | 10 reaction classes로 균형 잡은 500 tasks | 별도 100 tasks | Pass@1 |
Target h는 mini-SWE-agent 형태의 고정 prompt와 Bash 실행 tool 하나다. Sandbox에는 같은 모델의 one-level subagent를 부를 CLI도 있으며, 본 실험의 evolved harness는 이에 의존하지 않고 드물게만 사용한다고 설명한다. 따라서 아무 실행 도구도 없는 bare LLM의 실험은 아니다(App. E.1).
Training-free 비교는 GPT-5.6 Sol·DeepSeek-V4-Pro가 student와 reviewer 역할을 동시에 맡는다. 각 조건에서 같은 기반 모델을 쓰되 context·역할은 나눈다. Distillation은 Qwen3.5-9B student + GPT-5.6 Sol reviewer, harness evolution은 Kimi K3/Kimi Code를 사용한다(§4.1).
SFT는 LoRA rank 32, 2 epochs, seed 42이며 domain마다 별도로 학습한다. 최종 data는 Spreadsheet 487, AppWorld 282, USPTO 500 rollouts다. 앞의 두 domain은 성공·예외 없는 trial만 남기지만, USPTO는 성공·실패를 모두 남긴다. USPTO에서는 전체 data가 success-only보다 좋았다고 설명한다(App. D–E).
Finding 1 — 강한 모델에서는 code보다 agent가 guidance를 적용할 때 평균이 높다
6개 model×domain 조건의 평균이다(Table 1).
| Inference configuration | 평균 |
|---|---|
Student under h | 68.6 |
Code-as-harness, h★ | 78.1 |
Agent-as-harness, 빈 K | 69.2 |
Agent-as-harness, evolved K | 81.1 |
Generic review만으로는 평균 향상이 작고, evolved guidance가 있을 때 이득이 크다. 그러나 모든 조건에서 agent가 code를 이기는 것은 아니다. DeepSeek-V4-Pro의 AppWorld에서는 code 91.1, agent 89.3이며, GPT-5.6 Sol은 base와 agent가 96.4로 같다.
Finding 2 — Distillation 후 specialized harness 없이 평균 이득이 유지된다
아래는 Qwen3.5-9B 결과다(Table 2).
| 설정 | Spreadsheet | AppWorld | USPTO | Macro avg |
|---|---|---|---|---|
Base + h | 31.0 | 26.8 | 12.0 | 23.3 |
Base + h★ | 39.0 | 48.2 | 38.0 | 41.7 |
Harness-Zero + h | 44.0 | 58.9 | 30.0 | 44.3 |
Base 대비 +21.0%p이고, 논문이 보고하는 상대 개선은 90.1%다. 그러나 기존 h★를 넘어선 것은 평균과 두 domain이다. USPTO에서는 38.0 → 30.0으로 낮다. 저자들은 일반 절차보다 chemistry prior·candidate generation·validation 기능을 온전히 internalize하는 것이 어렵다고 논의한다(§4.3).
Macro average는 task별 weighted average가 아니다. Spreadsheet·USPTO의 pass@1과 AppWorld의 scenario metric을 세 domain에 같은 가중치로 평균한다. 또한 이는 domain별 checkpoint 결과를 합친 값이다.
Finding 3 — 수집 성공률이 높은 data가 좋은 학습 data인 것은 아니다
USPTO에서 같은 500-task collection split과 SFT recipe를 비교한다(Table 3).
| Trajectory source | Collection success | SFT 후 test pass@1 under h |
|---|---|---|
| Teacher rollout | 52.0 | 12.0 |
Teacher + h★ | 62.0 | 3.0 |
Student + h★ | 39.4 | 12.0 |
Reviewer + 빈 K | 44.2 | 11.0 |
| Reviewer + oracle answer | 98.6 | 15.0 |
Harness-Zero + K | 59.4 | 30.0 |
Teacher + h★ trajectory를 그대로 학습하면 student가 없는 harness-tool 호출을 시도해 실패하는 양상이 나타난다. 반면 oracle answer review는 수집 성공률을 크게 높이지만, 이후 independent test에서는 이득이 작다. Target-compatible하고 재사용 가능한 절차를 보여 주는 data가 더 가치 있다는 근거다(§4.4).
이 ablation은 USPTO 한 domain에서 한 것으로, 모든 distillation 상황에서 직접 teacher rollout이 실패한다는 일반 결론은 아니다.
Finding 4 — Harness-specific behavior를 평균 82.3% 복구하지만 조건부 지표다
같은 test task에서 base가 h★ 아래에서는 보이고 h 아래에서는 보이지 않는 behavior를 찾아 detector를 만든다. 이런 task가 10개 이상 있는 pattern만 유지한다. 총 28개이며 Spreadsheet 18, USPTO 6, AppWorld 4개다(§4.5, Table 4, App. G).
각 pattern의 선택된 task에서 distilled model이 behavior를 재현하는 비율을 계산하고, pattern별 평균 82.3%를 보고한다. 예를 들어 RDKit validation은 60/60, AppWorld의 complete-page retrieval은 21/53, mutation readback은 6/12다.
이 지표는 전체 test task의 82.3%를 해결했다는 뜻이 아니다. Base under h의 score는 선정 기준상 0%이며, base와 달리 새로 나타난 행동의 조건부 recovery를 측정한다. Detector의 behavior가 최종 성공을 유발했는지까지 입증하는 지표도 아니다.
한계와 해석
저자들이 밝힌 한계
- Reviewer capability: 약한 reviewer는 과하게 개입하고 해를 줄 수 있다. USPTO에서 Qwen3.6-35B-A3B는 code-as-harness 48.0, agent-as-harness 36.0이며, reviewed steps의 66.0%를 replace한다(App. F, Table 8).
- 수집 비용: 매 proposal마다 review call이 필요하다. USPTO mean latency는
h100.1초, evolved agent-as-harness 237.2초, 약 2.4배다. 이 review overhead는 distillation 후 배포에서는 없다. - 표현 범위: Context management처럼 응답 교정만으로 표현하기 어려운 harness mechanism이 있다.
- Knowledge transfer: Deep domain knowledge를 SFT만으로 충분히 internalize하지 못할 수 있다.
- Selective review, 더 세밀한 intervention, agent–environment world model, preference learning을 후속 방향으로 제안한다(§5).
AI의 해석
이 논문의 강점은 harness의 효과를 weights로 옮기려면 행동을 배포 interface에 맞게 번역해야 한다는 점을 명시하고, 직접 teacher distillation과 비교한 데 있다. “좋은 결과를 낸 로그”와 “학생이 독립적으로 재현 가능한 로그”가 다를 수 있다는 관찰이 중요하다.
다만 성공률과 행동 recovery 모두 절차의 인과적 기여를 완전히 분리하지는 않는다. Reviewer의 일반 능력, K의 지식, 학생 분포에서의 correction, loss masking 각각의 이득을 더 세밀하게 ablate할 수 있다. 또한 한 seed·작은 held-out test에서 나온 수치이므로 평균 +2.6%p로 h★를 넘었다는 결과의 변동성도 궁금하다.
“Harness-Zero”는 harness가 없어졌다는 뜻이 아니다. Bash·filesystem·tool observation·고정 prompt가 남는다. 또한 domain별 별도 SFT이므로 “다양한 harness의 지식이 하나의 generalist에 누적된다”는 논문의 비전은 이번 실험에서 완료된 결과가 아니다.
기존 Meta-Harness는 raw trace를 조사해 외부 프로그램을 고치는 방향이고, 이 논문은 그렇게 얻은 guidance를 student-compatible trajectory를 거쳐 weights에 남기는 방향이다. 두 단계의 결합 가능성이 있지만, 반복적으로 서로를 개선하는 closed loop의 장기 효과는 추가 실험이 필요하다.
더 생각해볼 질문
아래는 AI가 정리 과정에서 제안한 후속 질문입니다. 본인이 직접 작성한 의견이나 논문에서 검증한 결과로 표시하지 않습니다.
아래는 논문 밖 연구 질문이다.
- Selective review: STC의 forward consistency gate처럼, intervention의 예상 이득을 평가해 중요한 turn만 review할 수 있을까?
- Preference signal: 같은 state의 rejected·accepted pair로 DPO·RL을 수행하면 SFT보다 correction의 이유를 더 잘 학습할까?
- Exploration distillation: When Greedy Wins의 경고처럼 흔한 절차만 모방하지 않도록, 드물지만 중요한 탐색·검증 intervention을 reweight할 수 있을까?
- Online adaptation 결합: LaMer식 reflection을 reviewer가 교정하고 trial-level return으로 학습하면, 고정 절차와 새로운 실패 적응을 함께 얻을 수 있을까?
- Shared model 실험: 세 domain을 joint SFT한 뒤 domain 간 interference·unseen-domain transfer를 측정하면, harness 지식 누적의 비전을 직접 검증할 수 있다.
참고자료
정리 범위와 근거 메모
근거: arXiv v1, PDF, LaTeX main. 본문·부록·표의 명시값을 기준으로 정리했다. 아래 AI 해석·후속 질문은 정리자(Codex)의 해석과 연구 질문이다. 모델명·성능은 논문에 수록된 실험 조건을 그대로 표기한다.
용어 정리
| 용어 | 의미 |
|---|---|
| Harness distillation | Specialized harness가 유도한 행동을 model weights에 학습시키는 것 |
| Code-as-harness | Evolved 프로그램이 student의 실행 흐름을 직접 감싸는 방식 |
| Agent-as-harness | 별도 agent가 실행 전 proposal을 통과·교체하는 방식 |
Reference harness K | Reviewer만 읽는, evolved harness에서 변환된 private guidance |
| Accepted trajectory | 실제 실행된 응답과 student-visible observation의 기록 |
| Behavior recovery | h★에서만 보였던 pattern을 선택된 task에서 재현하는 비율 |