Meta-RL Induces Exploration in Language Agents ↗
Yulun Jiang, Liangze Jiang, Damien Teney, Michael Moor, Maria Brbic
ICLR 2026; arXiv first posted 2025-12-18, revised 2026-03-08 · v2
- 문제: episode별 성공 최적화는 다음 시도에 도움이 되는 탐색의 가치를 놓칠 수 있다.
- 방법: LaMer는 여러 episode와 reflection을 하나의 trial로 묶어 cross-episode return으로 학습한다.
- 결과: 세 환경의 pass@3가 개선되지만, 테스트 적응은 가중치 갱신이 아닌 context 변화로 이뤄진다.
문제와 배경
배경과 읽는 관점
한 번 실패한 행동도 다음 시도를 위한 정보를 남길 수 있다. 하지만 각 episode의 성공만 따로 보상하면, 나중의 성공에 기여한 초기 탐색이 학습 목표에 충분히 반영되지 않을 수 있다. 이 논문은 실패와 재시도를 독립된 시행이 아니라 같은 task에 대한 적응 과정으로 묶는다.
기존 접근과 연구 질문
MineSweeper에서 한 칸을 열어 정보를 얻었지만 결국 실패했다고 하자. 다음 시도에서 그 정보를 활용한다면, 첫 시도의 행동에도 가치가 있다. 하지만 각 episode를 독립적으로 채점하면, 나중의 성공을 가능하게 한 초기 탐색의 가치가 학습 목표에 충분히 드러나지 않을 수 있다. 이것이 논문의 출발점이다(§1, §4).
저자들은 Meta-RL의 두 수준을 LLM agent에 적용한다. Outer loop는 여러 task의 trial을 이용해 model weights를 RL로 학습한다. Inner loop는 특정 task에서 실패와 feedback을 받은 뒤 reflection·history를 context에 넣어 정책을 바꾼다. 이 inner loop는 gradient descent가 아니다(§4).
따라서 여러 답을 독립적으로 sampling하는 test-time scaling과, 이전 실패를 보고 다음 시도를 바꾸는 adaptation을 구분하는 것이 중요하다.
핵심은 단순히 시도 횟수를 늘렸는지가 아니라, 앞선 경험 때문에 다음 행동이 달라지는지다. 따라서 여러 답을 독립적으로 생성하는 방식과, 같은 task의 history·reflection을 이용하는 적응을 먼저 구분해야 한다.
핵심 아이디어
먼저 직관으로 이해하기
여러 episode를 하나의 trial로 연결하고, 뒤의 성공에서 얻은 reward가 앞선 탐색과 reflection에도 돌아가게 한다. 학습 중에는 이런 trial을 통해 weights를 바꾸고, 테스트에서는 weights를 고정한 채 context에 쌓인 경험으로 다음 시도를 바꾼다. 같은 meta-learning이라는 말 아래 두 시점에서 바뀌는 대상이 다르다.
전체 흐름: Figure 2 — 독립 RL rollout과 cross-episode Meta-RL.
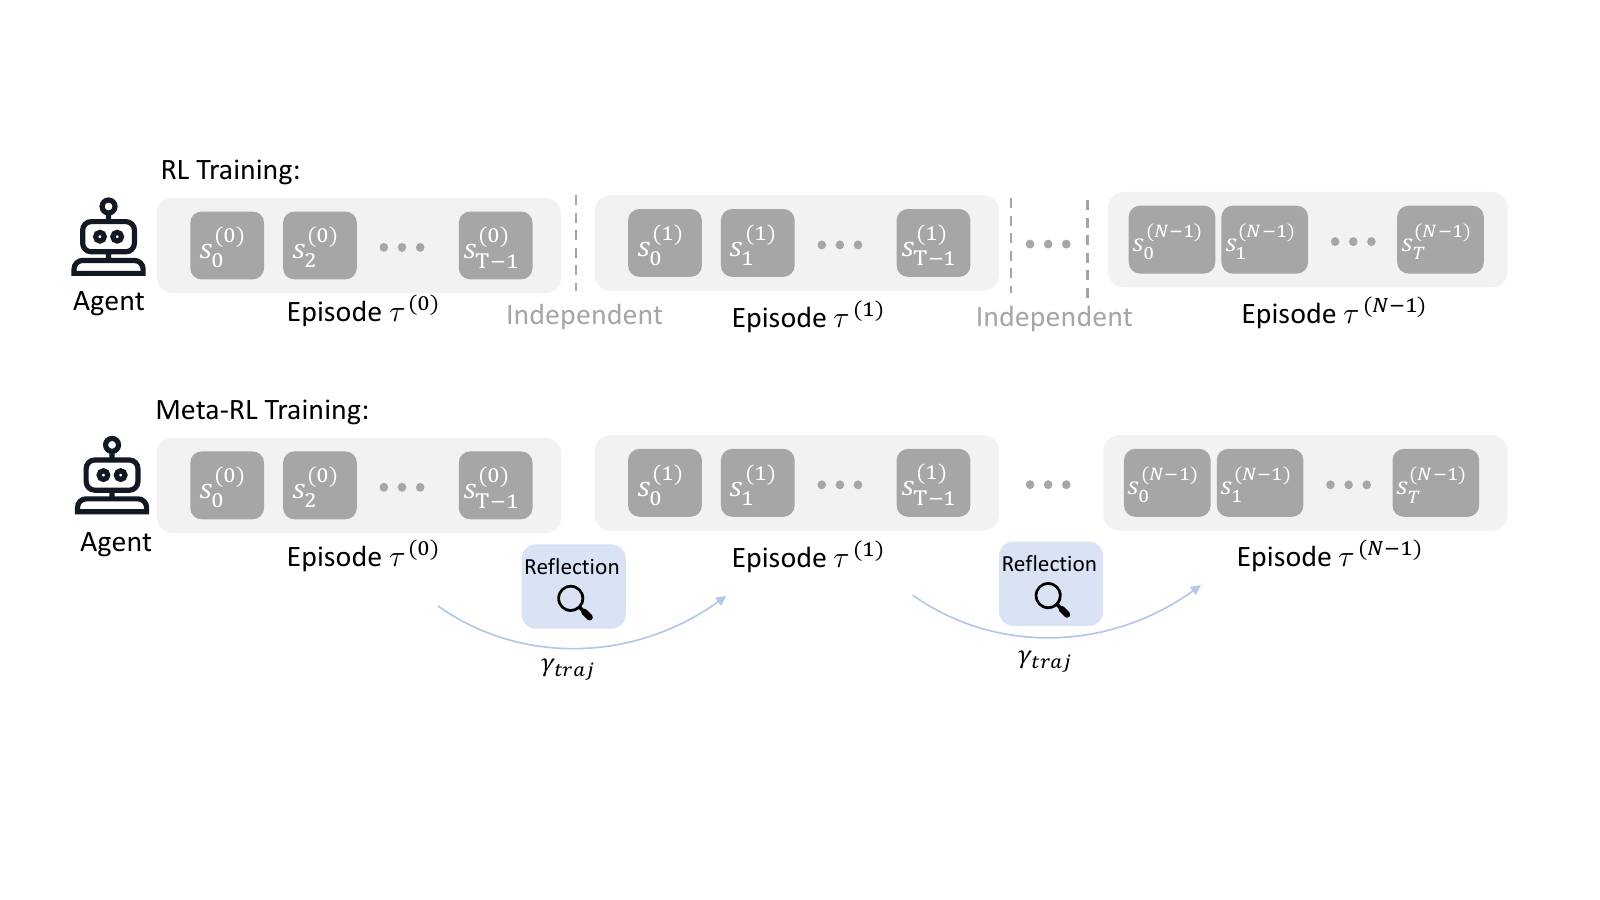
하나의 trial에 같은 task를 최대 N번 시도한다(§4).
- 첫 episode를 실행한다.
- 성공하면 trial을 끝낸다.
- 실패하면 모델이 이전 trajectory를 보고 reflection과 새 계획을 작성한다.
- 같은 초기 환경으로 reset하고 history·reflection을 참조해 다음 episode를 실행한다.
- 전체 trial의 discounted return으로 학습한다. Reflection 생성도 다음 episode의 reward를 받는다.
기본 inter-episode memory는 과거 trajectory와 reflection을 모두 포함한다. 부록의 prompt에는 첫 episode에서 reflection 변수를 비워 두고, 이후에는 과거 경험을 요약해 <remark>에 계획을 쓰도록 한다(App. B–C).
| 수준 | 바뀌는 것 | 시점 |
|---|---|---|
| Outer RL learning | Model weights θ | Training |
| Inner policy adaptation | Context의 history·reflection | Training 및 test의 같은 trial 내부 |
| Environment reset | 동일 task의 초기 상태로 복귀 | 실패 후 다음 episode |
기본 optimizer는 GiGPO다. LaMer는 cross-episode return과 context adaptation을 정의하는 framework이며, PPO·GRPO 등과도 결합 가능하다고 설명한다(§4–5).
정의와 수식
Episode n의 t번째 action에 대해, 먼저 episode 안의 return을 계산한다(§4). \(g_t^{(n)}=\sum_{l=t}^{T-1}\gamma_{\rm step}^{l-t}r_l^{(n)}.\) 이후 episode의 return도 앞선 action에 연결한다. \(G_t^{(n)}=g_t^{(n)}+ \sum_{m=n+1}^{N-1}\gamma_{\rm traj}^{m-n}g_0^{(m)}.\) Trial objective는 다음과 같다. \(J(\theta)=\mathbb E\left[ \sum_{n=0}^{N-1}\gamma_{\rm traj}^n \sum_{t=0}^{T-1}\gamma_{\rm step}^t r_t^{(n)} \right].\) γtraj가 작으면 앞선 episode의 즉각적인 성과를 더 강조하고, 커지면 뒤의 성공을 가능하게 하는 초기 행동에도 더 credit을 준다. 하지만 단순히 이 값을 크게 한다고 성능이 항상 오르지는 않는다(§6.1).
Context adaptation은 πθ⁽ⁿ⁾(·)=πθ(·|H⁽ⁿ⁾)다. θ는 trial 중 고정이고 H가 달라져 행동이 바뀐다.
실험과 핵심 결과
실험 설정
| 항목 | 설정 |
|---|---|
| 주 모델 | Qwen3-4B, rollout은 non-thinking mode |
| 추가 모델 | Llama3.1-8B-Instruct: Sokoban·MineSweeper |
| 환경 | Sokoban, MineSweeper, Webshop, ALFWorld; 모두 text modality |
| 기본 trial | 최대 3 episodes, γtraj=0.6 |
| 학습 rollout budget | Meta-RL 8 groups × 3 episodes; RL 24 independent episodes |
| 비교군 | Zero-shot, ReAct, Reflexion, PPO, RLOO, GRPO, GiGPO |
| Metric | 1·2·3회 시도 예산 내 성공률 p@1·p@2·p@3 |
Sokoban은 fully observable이고 나머지는 partially observable이다(§5.1). 같은 environment에서 더 많은 box·mine을 넣는 harder-task 평가와, ALFWorld의 일부 task category를 학습에서 제외하는 평가도 수행한다.
공정성의 두 축: 주 실험은 gradient update당 trajectory 수를 맞추지만 token 수·latency가 같다는 뜻은 아니다. 또 Table 1의 standard RL baseline은 test에서 inter-episode memory가 없다. Memory를 추가한 baseline은 부록 Table 5에 따로 있으므로 함께 봐야 한다(§6.3, App. D.2).
Finding 1 — 처음부터 더 잘 풀기보다, 재시도에서 더 많이 개선된다
가장 강한 주 baseline인 GiGPO와 비교한다(Table 1).
| 환경 | GiGPO p@1 / p@2 / p@3 | LaMer p@1 / p@2 / p@3 |
|---|---|---|
| Sokoban | 41.6 / 43.6 / 44.1 | 42.4 / 52.0 / 55.9 |
| MineSweeper | 52.0 / 54.9 / 55.1 | 44.1 / 66.4 / 74.4 |
| Webshop | 73.4 / 74.6 / 75.2 | 67.8 / 84.4 / 89.1 |
LaMer의 p@1→p@3 증가 폭은 13.5, 30.3, 21.3%p다. MineSweeper·Webshop에서는 p@1이 낮아도 p@2부터 앞선다. 따라서 “한 번의 action 선택부터 모든 환경에서 더 강하다”는 결과는 아니다.
원문 불일치: Abstract는 Sokoban·MineSweeper·Webshop 순서로 11%·14%·19% 개선이라 적지만, Table 1에서 직접 계산한 p@3 차이는 +11.8, +19.3, +13.9%p다. 본문의 MineSweeper 약 19, Webshop 약 14 설명과 표가 일치한다. 여기서는 표를 따른다.
Finding 2 — RL baseline에도 memory를 주어도 차이가 남는다
주 비교의 memory 차이를 보완한 결과다(App. D.2, Table 5).
| p@3 | Sokoban | MineSweeper | Webshop |
|---|---|---|---|
| GiGPO, memory 없음 | 44.1 | 55.1 | 75.2 |
| GiGPO, history + reflection | 47.9 | 60.4 | 74.0 |
| LaMer | 55.9 | 74.4 | 89.1 |
동일한 memory 접근을 허용한 baseline보다도 LaMer가 8.0, 14.0, 15.1%p 높다. 이는 단순한 test-time memory 추가만으로 전체 차이를 설명하기 어렵다는 근거다. 다만 cross-episode credit assignment와 reflection training의 효과를 이 표 하나로 각각 완전히 분리할 수는 없다.
Finding 3 — Reflection-only memory가 원래의 full memory보다 좋다
Memory ablation 결과는 다음과 같다(§6.2, Table 3).
| Memory | Sokoban | MineSweeper | Webshop |
|---|---|---|---|
| Trajectory-only | 34.8 | 69.5 | 89.3 |
| Reflection-only | 56.4 | 80.5 | 92.8 |
| 둘 다, 기본 설정 | 55.9 | 74.4 | 89.1 |
Reflection-only는 간결하고 집중된 guidance를 준다는 가설을 저자들이 제시한다. 하지만 history에 reflection을 추가한 기본 설정이 trajectory-only보다 항상 좋지는 않다. Webshop에서는 89.3 → 89.1이다. 본문의 reflection 개선 폭 21.6·11.0·3.5는 reflection-only와 trajectory-only의 차이다.
Finding 4 — 새 task category와 더 어려운 설정에도 이득이 전이한다
ALFWorld에서는 Pick·Look·Clean·Heat를 학습하고 Cool·Pick2를 제외한다. Held-out task category에서 RL 대비 다음 결과를 보고한다(§5.4, Table 2).
| OOD category | RL | Meta-RL |
|---|---|---|
| Cool | 58.1 | 81.0 |
| Pick2 | 36.0 | 50.2 |
이는 같은 ALFWorld 안에서 task category를 바꾼 일반화다. Sokoban으로 학습해 완전히 새로운 tool environment로 넘어간 결과는 아니다. Box·mine 수를 늘린 harder-task 평가에서도 Meta-RL이 더 높지만, 절대 성능은 난도가 오를수록 내려간다(Figure 4).
Finding 5 — 높은 diversity가 곧 성공적인 탐색은 아니다
Distinct state·action trajectory의 경험적 분포로 entropy를 측정한다. Base model의 entropy가 가장 높지만 성공률은 낮다. LaMer는 RL보다는 다양한 trajectory를 유지하면서 더 높은 p@3를 얻는다(§5.2, Figure 3).
이는 저자들의 exploration 해석을 뒷받침하는 행동 지표다. 다만 entropy는 정보 획득량을 직접 측정하지 않는다. Random한 실패도 diversity를 높일 수 있다.
한계와 해석
저자들이 밝힌 한계
- Episode를 순차 생성해야 하므로 parallelism이 낮다. 현재 구현의 training time은 RL의 약 2배라고 보고한다. 같은 trajectory budget이 같은 계산 비용을 뜻하지 않는다(§6.3).
- 가장 좋은
γtraj는 환경마다 다르다. Sokoban·Webshop은 중간값 0.6, MineSweeper는 더 큰 0.9가 유리한 양상이다(§6.1). - 더 나은 advantage estimation·reflection framework·reasoning model과의 결합은 미래 과제다(§7).
- 일반화 실험은 같은 종류의 더 어려운 환경 또는 비교적 비슷한 domain에 한정된다. 완전히 새로운 환경에 적응하는 generalist agent는 향후 가능성으로 논의한다.
AI의 해석
핵심은 reflection 문장을 넣는 기법보다 reflection과 초기 탐색을 나중의 성공으로 평가하는 학습 목표에 있다. 실패한 시도의 정보를 활용할 통로와, 그 통로를 잘 쓰도록 학습하는 credit assignment가 함께 필요하다는 결과로 읽을 수 있다.
다만 “능동적 정보 획득”과 “실패 후 다른 경로를 시도하는 다양성”은 아직 완전히 분리되지 않았다. Information gain, 불확실성 감소, 초기 탐색 행동의 counterfactual value를 측정하면 메커니즘을 더 직접 검증할 수 있다.
When Greedy Wins와 보편 법칙 차원의 모순은 아니다. 그 논문은 unknown-arm의 평균 cumulative reward와 imitation을 학습하며, LaMer는 reset 가능한 task의 여러 episode와 reflection을 연결한다. 탐색이 나중 보상에 반영되는 방식, horizon, 관측, metric이 다르다. “Meta-RL이면 탐색이 생긴다”는 문장은 이런 조건을 붙여 읽어야 한다.
더 생각해볼 질문
아래는 AI가 정리 과정에서 제안한 후속 질문입니다. 본인이 직접 작성한 의견이나 논문에서 검증한 결과로 표시하지 않습니다.
아래는 논문 밖 연구 질문이다.
- 동일 inference budget 평가: Reflection tokens까지 포함한 총 tokens·wall-clock을 맞추면 LaMer의 이득은 얼마나 남을까?
- 탐색 credit의 인과성: 첫 episode에서 특정 정보를 가린 뒤 다음 episode 성공이 얼마나 떨어지는지 측정하면 유용한 exploration을 직접 찾을 수 있을까?
- Memory interface: Reflection-only의 이득이 압축·노이즈 제거 때문인지, reflection 학습 때문인지 동일 길이 요약과 비교하면 어떨까?
- Harness와의 결합: Harness-Zero의 reviewer가 유용한 reflection·탐색 행동을 교정하고, 이후 LaMer식 trial RL로 강화할 수 있을까?
- 실패 위험: p@3 외에 반복 실패율·동일 행동 고착·최악 task의 성능을 함께 보면 평균 개선 속에 남은 exploitation bias를 찾을 수 있다.
참고자료
정리 범위와 근거 메모
근거: arXiv v2, PDF, LaTeX main. 본문·부록·표를 기준으로 정리했다. 아래 AI 해석·후속 질문은 정리자(Codex)의 해석과 연구 질문이다.
용어 정리
| 용어 | 의미 |
|---|---|
| Episode | 같은 task를 한 번 처음부터 시도하는 interaction sequence |
| Trial | 서로의 경험을 참조하는 여러 episode의 묶음 |
| Cross-episode credit assignment | 이후 episode의 reward를 이전 행동·reflection의 학습에 연결 |
| In-context adaptation | Weight는 고정하고 context를 바꿔 행동을 바꾸는 방식 |
| Reflection | 이전 실패 분석과 다음 시도의 계획을 담은 모델 출력 |
| p@k | 이 논문에서 최대 k회 시도 내 성공률; LaMer의 시도들은 서로 의존 |