When Greedy Wins: Emergent Exploitation Bias in Meta-Bandit LLM Training ↗
Sanxing Chen, Xiaoyin Chen, Yukun Huang, Roy Xie, Bhuwan Dhingra
arXiv preprint (2025-09-29) · v1
- 문제: regret가 줄어도 더 좋은 탐색 전략을 배웠다고 단정할 수 없다.
- 방법: 실제 reward·전략적 reward·UCB action matching·UCB 계산 과정의 SFT를 비교한다.
- 결과: 긴 horizon과 분포 전이에서 성과가 개선돼도, 되돌리기 어려운 탐색 실패는 늘어날 수 있다.
문제와 배경
배경과 읽는 관점
처음에는 어떤 선택지가 좋은지 모르고, 직접 시도한 결과로만 다음 선택을 정해야 한다고 하자. 지금까지 좋아 보인 선택을 반복하면 당장의 보상은 얻지만, 아직 잘 모르는 더 좋은 선택을 놓칠 수 있다. Bandit은 이런 탐색과 활용의 긴장을 단순한 문제로 만들고, 학습된 LLM의 의사결정 규칙을 관찰하는 실험장이 된다.
기존 접근과 연구 질문
평균 reward가 높은 arm을 더 자주 고르면 당장은 성과가 좋아진다. 그러나 관측이 적은 다른 arm이 실제로는 더 좋을 수도 있다. Multi-armed bandit(MAB)은 이 exploration–exploitation trade-off를 단순한 형태로 드러낸다(§1, §3).
LLM을 이 문제에 fine-tune하면 regret가 줄어든다는 연구는 있지만, 어떤 의사결정 규칙을 배웠는지, 새로운 reward distribution과 긴 horizon에서도 그 규칙이 유효한지는 별개다. 이 논문은 성능 평가와 행동 분석을 함께 수행한다.
Meta-bandit이라는 말은 다양한 bandit instance로 weights를 학습해, 새 instance에서는 과거 arm pull의 통계를 보고 적응하는 policy를 얻는다는 뜻이다. Test-time에 gradient를 계산하는 방법은 아니다(§3).
좋은 평균 점수만으로는 모델이 어떤 규칙을 배웠는지 알 수 없다. 이 글의 중심 질문은 teacher를 이긴 결과가 탐색 원리의 습득을 뜻하는지, 아니면 해당 환경에 더 유리한 greedy 규칙을 익힌 결과인지다.
핵심 아이디어
먼저 직관으로 이해하기
환경과 입력 형식을 유지한 채 학습 신호를 바꿔 보면, 관측된 성과가 보상 최적화에서 나왔는지, UCB의 행동이나 계산 과정을 모방하면서 나왔는지 비교할 수 있다. 이후 평균 regret와 실제 arm 선택 이력을 함께 읽어, 점수 개선과 탐색 실패가 동시에 나타날 수 있는지 확인한다.
매 turn의 prompt에는 arm별 pull count와 observed average reward가 들어간다. 전체 interaction transcript를 그대로 넣는 대신 환경 측 summarizer가 통계를 계산한다. 모델은 reasoning과 다음에 고를 arm을 출력한다(§3–4, Figure 1).
학습 신호를 네 가지로 비교한다.
| 이름 | 학습 신호 | 모델이 보는 환경 history |
|---|---|---|
| RL-OG | 실제 sampling된 bandit reward | 실제 관측 reward로 만든 통계 |
| RL-STG | True arm mean으로 만든 regret-based strategic reward | 동일한 실제 관측 통계 |
| RL-ALG | 같은 history에서 UCB가 고른 action과 일치하면 1 | 동일한 실제 관측 통계 |
| SFT | UCB의 계산 CoT와 정답 action을 직접 지도 | UCB rollout에서 수집한 통계 |
Training reward를 바꿔도 prompt 속 reward history를 oracle mean으로 바꾸지는 않는다. Strategic reward에는 simulator가 아는 true mean을 사용하지만, test policy는 관측된 통계에만 의존한다(§3.2).
RL은 PPO와 token/turn 두 수준의 GAE를 쓴다. RL-OG·STG는 turn 간 γ=λ=0.95, turn 내부는 γ=λ=1이다. RL-ALG는 reactive UCB action을 맞히는 reward이므로 turn 간 γ=λ=0으로 둔다. 따라서 RL-ALG를 장기 정보 획득의 return을 직접 학습한 조건으로 읽으면 안 된다(App. A, Table 4).
정의와 수식
Arm i의 true mean을 μi, 최고 mean을 μ*라고 하면 immediate pseudo-regret는 다음과 같다(§3). \(\Delta_t=\mu^*-\mu_{A_t},\qquad \mathcal R_T=\sum_{t=1}^T\Delta_t.\) Strategic reward는 이 regret를 arm mean range로 정규화한다. \(\tilde r_t=1-\frac{\Delta_t}{\mu^*-\min_i\mu_i} =\frac{\mu_{A_t}-\min_i\mu_i}{\mu^*-\min_i\mu_i}.\) 저자들은 stochastic realized reward 대신 expected utility에 가까운 신호를 주어 variance를 줄이는 취지로 설명한다. 본문의 이름은 RL-STR로도 등장하지만 결과·그림은 주로 RL-STG라 표기한다. 이 노트에서는 RL-STG로 통일한다.
Teacher UCB의 action score는 다음과 같다. 논문에서는 C=0.5를 사용한다(§4). \(\operatorname{UCB}_t(a)=Q_t(a)+C\sqrt{\frac{\log t}{N_t(a)}}.\) 중요한 행동 지표는 다음 두 가지다(§5.2).
- GreedyFreq@t: t까지 observed mean이 가장 높은 arm을 고른 빈도. True best arm 선택률과 다르다.
- SuffixFail@t: 총
T=300인 episode에서 t부터 300까지 true best arm을 한 번도 고르지 않는 episode의 비율.
SuffixFail은 순간적인 오답률이나 전체 task 실패율이 아니다. 나중에 최적 arm을 재탐색할 기회가 완전히 사라지는지를 보는 지표다.
실험과 핵심 결과
실험 설정
| 항목 | 설정 |
|---|---|
| 모델 | Qwen2.5-3B·7B-Instruct |
| 학습 분포 | Gaussian5_Var1_MeanN0 또는 Bernoulli5_Uniform |
| RL | Batch당 64 environments × 50 turns, 500 training iterations |
| SFT | 32,768 transitions, UCB 계산 template, 6 epochs |
| 평가 | 고정된 64 environment seeds, 최대 300 turns |
| OOD | Reward family·mean·variance·arm 수 변화; 5 → 10 arms |
| 비교군 | Greedy, ε-Greedy(ε=0.1), UCB(C=0.5), Thompson Sampling |
50 turns로 학습한 뒤 300 turns까지 평가하므로 horizon이 6배다. 평가 수가 64 episodes로 제한된 이유는 LLM inference 비용이며, 저자들은 distribution plot으로 task별 편차를 보여 준다(§4).
Gaussian family마다 variance 변화의 의미가 다르다. MeanN 계열에서는 reward noise와 arm-mean 분산이 함께 바뀌므로, variance 증가를 곧 난도 증가로 볼 수 없다. MeanU 계열은 mean 분포를 고정해 noise 효과를 분리한다(App. A.1).
Finding 1 — 학습 후 긴 horizon·다른 분포에서도 성과는 좋아진다
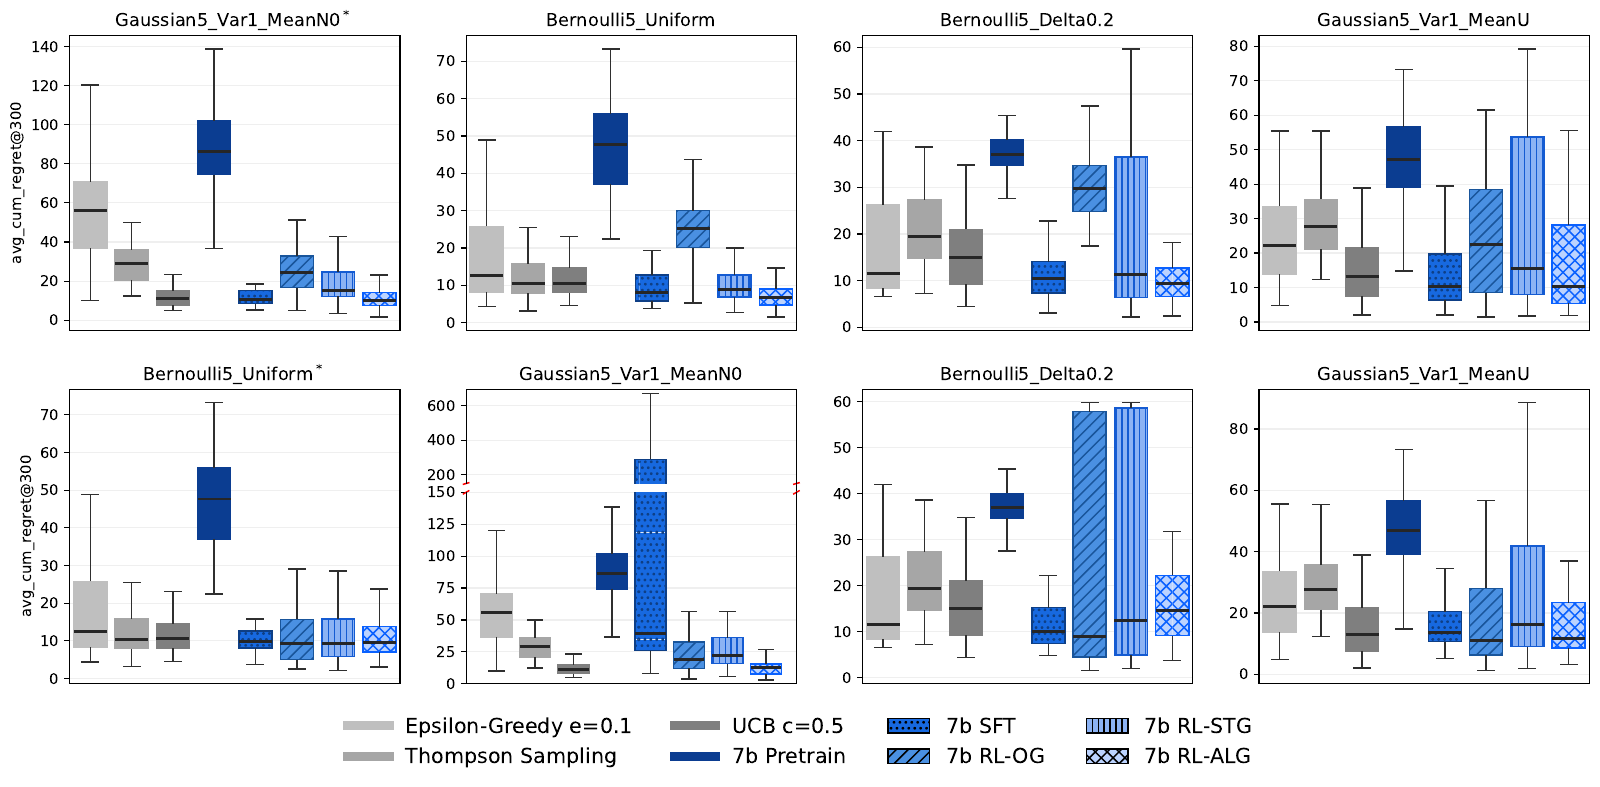
RL·SFT는 pretrained model보다 regret가 낮아지고, UCB·TS와 경쟁할 만한 수준을 보인다. UCB signal을 쓴 RL-ALG·SFT는 환경 reward만 쓰는 RL-OG보다 전반적으로 좋다. 다만 SFT의 OOD 성능은 학습 분포에 민감하며, 3B는 teacher 없이 환경 reward만으로 학습하기 어려운 양상이다(§5.1).
주 결과: Figure 3 — 7B cumulative regret boxplots. 이 그림의 비교군은 고정 hyperparameter의 baseline이다. 모든 task에서 최적으로 tuning된 모든 classical policy를 이겼다는 결과는 아니다.
Finding 2 — 평균 성과 향상과 irreversible exploration failure가 함께 나타난다
다음은 7B·Gaussian training·in-distribution evaluation의 Table 2에서 일부 metric을 옮긴 것이다. Frequency·failure의 단위는 %다.
| Policy | AvgReward@300 | BestArmFreq@300 | GreedyFreq@300 | SuffixFail@50 / @150 |
|---|---|---|---|---|
| Pretrain | 0.79 | 63.1 | 65.4 | 0.0 / 0.0 |
| UCB | 1.04 | 80.6 | 95.4 | 3.1 / 4.7 |
| SFT | 1.05 | 81.3 | 95.5 | 6.2 / 6.2 |
| RL-OG | 1.01 | 79.8 | 91.7 | 1.6 / 4.7 |
| RL-STG | 1.01 | 81.1 | 95.8 | 3.1 / 6.2 |
| RL-ALG | 1.05 | 85.7 | 97.0 | 7.8 / 9.4 |
RL-ALG는 best arm 선택률이 가장 높으면서도 suffix failure가 더 많다. 어떤 episode에서는 거의 항상 좋은 arm을 고르고, 어떤 episode에서는 일찍 잘못 굳어지는 양상이 평균에 함께 들어간다. Figure 5의 best-arm-frequency histogram은 이러한 bimodal pattern을 보여 준다.
모든 학습 모델이 모든 baseline보다 suffix failure가 높다는 뜻도 아니다. 예를 들어 RL-OG의 @50은 UCB보다 낮다. 중요한 비교는 pretrain보다 reward는 높아졌지만, 사라졌던 종류의 실패가 생긴다는 것이다.
Finding 3 — Teacher를 이긴 학생은 정확한 UCB 대신 더 greedy한 규칙을 쓴다
Gaussian-trained RL-ALG의 rationale에는 다음 variant가 98%의 비율로 나타난다고 보고한다(§5.2). \(Q_t(a)+C\sqrt{\frac{\log(N_t(a)+1)}{N_t(a)}}.\) 원래 UCB의 분자는 전체 시간 log t이지만 이 variant는 해당 arm의 count만 쓴다. 원래 식은 그 arm을 안 골라도 시간이 흐르면 exploration bonus가 커질 수 있지만, variant는 arm을 안 고르는 동안 score가 고정될 수 있다. 이에 따라 잠깐 나빠 보였던 arm을 영구히 포기하기 쉬워진다.
Bernoulli-trained 모델에서는 Q + C/√N이라는 다른 variant도 나타난다. 모델 행동은 teacher UCB보다 이런 variant의 결정과 더 잘 맞으며, variant와 다르게 고를 때도 86% 이상 greedy action을 선택한다고 보고한다(Figure 6, App. C).
이는 rationale와 decision matching에 기반한 행동 분석이다. 모델 내부가 이 수식을 정확히 구현한다는 기계적 증명은 아니다. 저자들도 계산 오차가 남아 있음을 설명한다.
Finding 4 — Imitation은 탐색 신호보다 빈번한 exploitation 신호를 따라가기 쉽다
UCB도 후반에는 observed mean이 높은 arm을 자주 고른다. 따라서 UCB action-matching reward의 상당 부분을 greedy action으로 얻을 수 있다. 저자들은 드문 exploration decision보다 흔한 exploitation decision의 신호가 커지고, 어려운 계산과 credit assignment가 이를 악화시킨다고 해석한다(§5.2–6).
SFT도 정확한 알고리즘 전이를 보장하지 않는다. Bernoulli-only data로 학습한 모델은 Gaussian의 음수 reward를 만나면 덧셈·UCB 계산을 틀리고 자기 계산과 다른 action을 고른다. Appendix C의 한 조건에서는 계산상 최대 UCB와 다른 선택이 78%, mean을 −1 shift하면 89%, +1 shift하면 44%라고 보고한다. 분포 밖 계산 능력의 회귀가 의사결정 실패로 이어지는 사례다.
한계와 해석
저자들이 밝힌 한계
별도의 limitations 절보다 실험·결론에서 범위와 후속 과제를 설명한다.
- LLM 비용 때문에 평가는 64 episodes·300 turns로 제한된다. 매우 많은 samples·긴 horizon에서의 classical bandit 평가와 다르다(§4).
- Classical baselines의 hyperparameter 비교가 주목적은 아니며, ε-Greedy도 고정값 0.1을 쓴다.
- Worst-case·OOD variability와 계산 능력 저하가 남아 있어 평균 regret만으로 robust exploration을 평가하기 어렵다(§5).
- Information gain·surprise에 따른 replay reweighting, adversarial task, curriculum 등으로 exploration signal을 키우는 방법을 미래 방향으로 제안한다(§6).
AI의 해석
이 논문은 “학습하면 탐색 능력이 생겼다”는 해석에 유용한 제동을 건다. 평균 성능, 알고리즘 모방 정확도, 탐색의 견고함은 각각 다른 축이다. 높은 평균에 만족하지 않고 실패가 어떤 episode에 몰리는지 봐야 한다.
다만 greedy bias의 원인을 credit assignment 하나로 확정할 수는 없다. RL-OG·STG의 turn discount는 0.95이고, RL-ALG는 myopic matching objective다. Training horizon 50, fixed UCB constant, prompt representation도 정책 형성에 영향을 줄 수 있다. 각각을 통제한 추가 실험이 필요하다.
LaMer와 함께 읽으면 학습 목표의 중요성이 보인다. LaMer는 실패한 episode의 정보를 다음 episode에서 써서 성공하는 구조를 학습한다. 이 논문은 한 bandit episode 안의 decision과 teacher matching을 중심으로 연구한다. “Meta-RL이 탐색을 유도한다/망친다”라는 단일 결론으로 합치기보다, 탐색의 장기 이득이 실제 training signal에 얼마나 살아 있는지 봐야 한다.
더 생각해볼 질문
아래는 AI가 정리 과정에서 제안한 후속 질문입니다. 본인이 직접 작성한 의견이나 논문에서 검증한 결과로 표시하지 않습니다.
아래는 논문 밖 연구 질문이다.
- Evaluation 확장: Agent success rate와 함께 suffix failure에 대응하는 “정답 경로를 영구 포기한 비율”을 만들 수 있을까?
- Teacher data 재균형: Teacher의 exploration turn을 oversample하면 imitation fidelity와 worst-case 성능을 동시에 높일 수 있을까?
- 계산과 전략 분리: UCB score를 외부 계산기로 제공한 조건에서도 greedy variant가 발생하는지 보면 arithmetic failure와 strategy learning을 분리할 수 있다.
- Counterfactual exploration value: 탐색 action으로 얻은 정보가 이후 성능에 준 기여를 reward로 돌려주면, 단순 matching보다 robust policy가 생길까?
- Harness distillation 검증: Harness-Zero에서도 절차를 자주 재현하는 것과 그 절차가 필요한 상황을 정확히 식별하는 것을 따로 평가할 필요가 있다.
참고자료
정리 범위와 근거 메모
근거: arXiv v1, PDF, LaTeX main. 소스 파일명은 venue 확정 근거로 사용하지 않았다. 수치는 본문·부록의 명시값이며, boxplot에서 regret 수치를 임의로 읽어 옮기지 않았다. 아래 AI 해석·후속 질문은 정리자(Codex)의 해석과 연구 질문이다.
용어 정리
| 용어 | 의미 |
|---|---|
| Meta-bandit policy | 여러 bandit에서 학습해 새 instance의 관측 통계로 적응하는 policy |
| Pseudo-regret | 최적 arm과 선택 arm의 true expected reward 차이 누적 |
| Greedy action | 지금까지 관측 평균이 가장 높은 arm |
| UCB | Observed mean에 uncertainty bonus를 더해 arm을 선택하는 알고리즘 |
| Suffix failure | 남은 horizon 동안 true best arm을 한 번도 고르지 않는 사건 |
| Exploitation bias | 불확실한 대안을 계속 탐색하기보다 현재 좋아 보이는 선택에 굳어지는 경향 |