Cross-Domain Offline Policy Adaptation via Selective Transition Correction ↗
Mengbei Yan, Jiafei Lyu, Shengjie Sun, Zhongjian Qiao, Jingwen Yang, Zichuan Lin, Deheng Ye, Xiu Li
arXiv preprint (2026-02-05) · v1
- 문제: dynamics가 바뀌면 같은 state·action 형식의 과거 경험도 target에 맞지 않을 수 있다.
- 방법: target inverse policy로 source action·reward를 보정하고 forward model로 채택 여부를 정한다.
- 결과: 24개 조건 중 18개에서 최고 점수를 보고하며, 보정을 거절한 source transition은 삭제하지 않고 유지한다.
문제와 배경
배경과 읽는 관점
과거 경험은 상태, 행동, 보상, 다음 상태를 묶어 저장한다. 환경의 물리 조건이 달라지면 같은 행동의 효과도 바뀌므로, source의 기록이 target에서도 같은 의미를 갖는다고 보기 어렵다. 이 문제는 단순히 데이터의 양을 늘리는 것과, 새 환경에 맞는 경험을 얻는 것이 다르다는 점을 드러낸다.
기존 접근과 연구 질문
로봇의 중력·마찰·다리 길이가 달라졌다고 하자. 이전 환경에서 a를 실행해 s → s′로 갔다는 기록은 새 환경에서도 그대로 참일까? State와 action의 형식이 같아도 action의 효과가 다를 수 있다. 이 논문은 이 dynamics mismatch를 다룬다(§1, §3).
기존 cross-domain offline RL은 target과 닮은 source transition만 선택하거나, mismatch가 큰 transition의 reward를 낮추는 방식이 많다. 저자들은 이 과정에서 유용한 경험까지 충분히 활용하지 못할 수 있다고 본다. 따라서 source의 state pair를 유지하면서 target에서는 어떤 action이 그 전이를 만들었을지 추정해 경험을 고친다(§1, §4.1).
연구 범위는 LLM agent가 아니라 연속 제어의 offline RL이다. Source·target은 state space, action space, reward function을 공유하고 transition dynamics가 다르다고 설정한다. Reward function이 같아도 action label을 바꾸면 그 action에 해당하는 reward를 다시 계산해야 한다(§3–4).
이 글은 source 경험을 버릴지 유지할지의 선택에서 한 단계 더 나아가, 관측된 상태 전이를 target에서 설명할 수 있도록 action label을 고치는 방법을 살펴본다. 다만 target의 제한된 데이터로 학습한 모델이 보정을 판단하므로, 보정 자체가 항상 참이라는 보장은 없다.
핵심 아이디어
먼저 직관으로 이해하기
관측된 출발 상태와 도착 상태는 남겨 두고, target에서 그 둘을 연결했을 법한 행동을 inverse policy로 추정한다. 그런 다음 forward model이 원래 행동과 보정 행동 중 어느 쪽이 관측 전이를 더 잘 설명하는지 비교한다. 이 검사를 통과할 때만 보정안을 쓰며, 통과하지 못하면 원본을 유지한다.
전체 흐름: Figure 1 — STC pipeline.
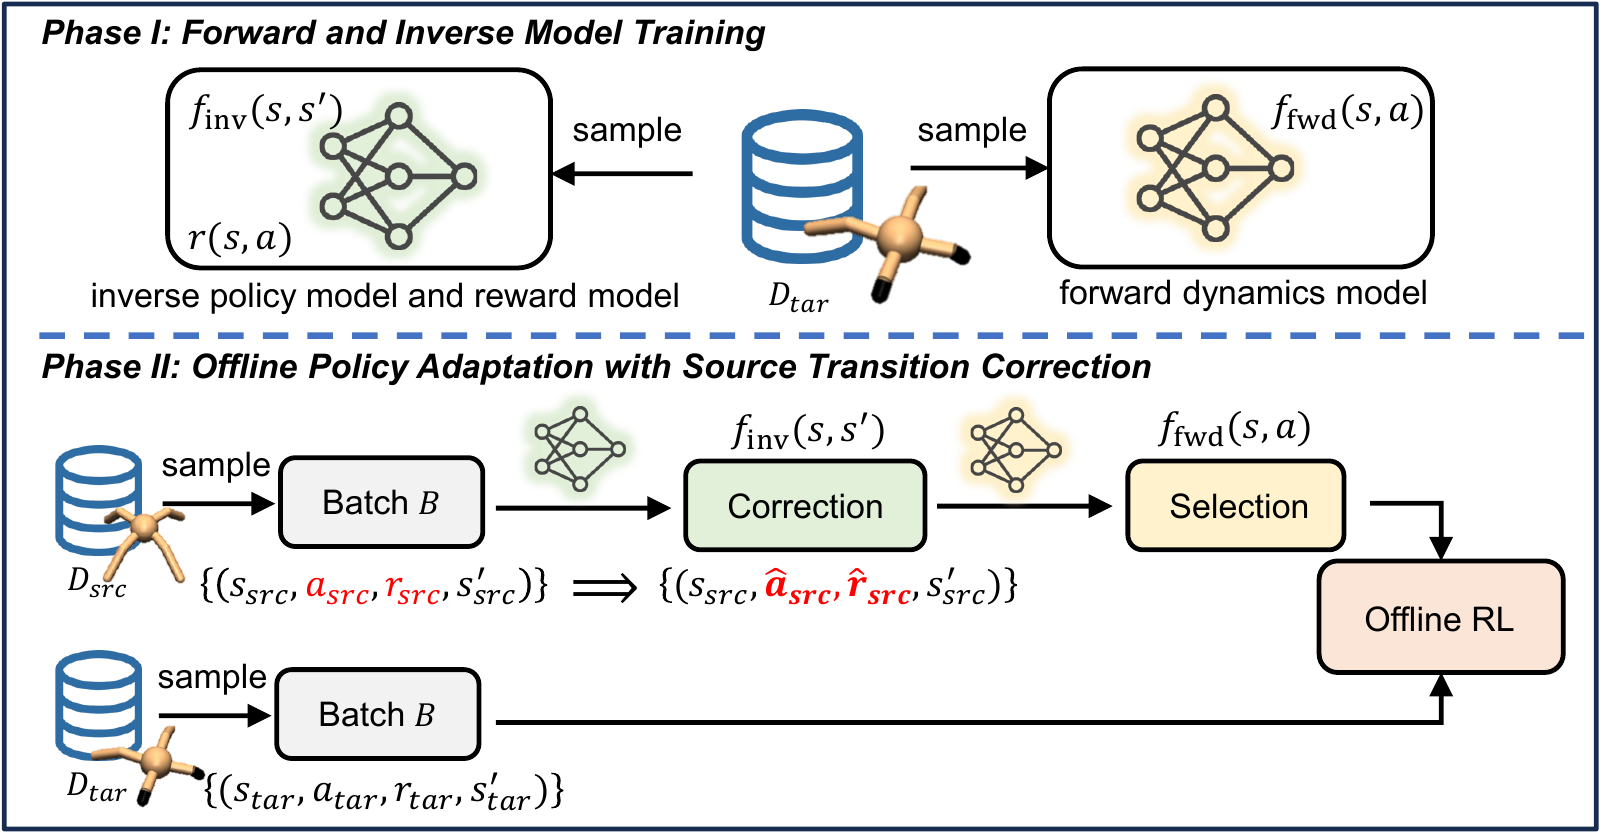
먼저 제한된 target dataset만으로 세 모델을 학습한다. 구현에서는 50,000 pretraining steps를 사용한다(App. C).
| 모델 | 입력 → 출력 | 용도 |
|---|---|---|
| Inverse policy | (s, s′) → a | Target에서 state pair를 설명하는 action 제안 |
| Forward dynamics | (s, a) → s′−s | 원래 action과 보정 action의 전이 오차 비교 |
| Reward model | (s, a) → r | Action 변화에 따른 reward의 국소 변화 추정 |
그다음 source transition (s, a, r, s′)마다 다음을 수행한다(§4).
- Inverse policy로 보정 action
â를 만든다. - Reward model의 action gradient를 이용해 보정 reward
r̂를 만든다. - Forward model로 원본과 보정본의 예측 오차를 비교한다.
- 조건을 통과하면
(s, â, r̂, s′), 아니면 원본(s, a, r, s′)을 학습에 쓴다. - 이 source batch와 원래 target batch로 actor-critic을 학습한다.
새 next state를 생성하는 world-model rollout은 아니다. 관측된 source의 s, s′를 보존하고 action·reward label을 수정한다. 보정된 action의 실제 효과를 target 환경에 실행해 확인하는 절차도 주 offline 실험에는 없다.
정의와 수식
Action correction은 간단하다(§4.1, Eq. 2). \(\hat a=f_{\rm inv}(s,s').\) Reward는 새 action에 대한 model prediction으로 통째로 바꾸지 않는다. 원래 관측 reward를 기준으로 first-order Taylor adjustment를 더한다(Eq. 4). \(\hat r=r+\alpha\nabla_a r_\nu(s,a)^\top(\hat a-a).\) 구현에서는 gradient를 정규화·clip하고, α=0.5를 사용한다. 저자들은 직접 reward prediction의 OOD bias를 통제하기 어렵기 때문에 국소 보정을 택했다고 설명한다(App. F).
Forward model의 원본·보정 오차는 각각 다음과 같다(§4.3). \(\varepsilon_{\rm orig}=\|f_{\rm fwd}(s,a)-(s'-s)\|^2, \quad \varepsilon_{\rm corr}=\|f_{\rm fwd}(s,\hat a)-(s'-s)\|^2.\) 보정 채택 조건은 εcorr < λ εorig다. λ=1이면 예측 오차가 줄어야 하지만, 실험에서 사용하는 다른 값인 λ=5는 보정 오차가 원래보다 커도 통과할 수 있다. 본문의 “더 잘 맞는 보정만 사용한다”는 직관을 모든 설정에서 엄밀한 오차 감소 조건으로 읽으면 안 된다(§4.3, §5.5, Table 5).
Theorems 4.4–4.6은 bounded dynamics discrepancy, inverse-policy estimation error, bounded·smooth reward 등의 가정 아래 discrepancy·value·return bound를 제시한다. 핵심은 inverse-policy error κ와 target sample 수 n에 의존한다는 것이다. 이 결과가 학습된 두 모델의 임의 OOD 예측이나 모든 개별 correction을 인증하지는 않는다.
실험과 핵심 결과
실험 설정
| 항목 | 설정 |
|---|---|
| 환경 | ODRL의 HalfCheetah, Hopper, Walker2d, Ant |
| Dynamics shift | Gravity, morphology, friction |
| Source | 원래 환경의 D4RL MuJoCo-v2 dataset |
| Target | 수정 환경의 ODRL dataset; 주 실험 약 5,000 transitions |
| Source quality | Medium, medium-replay, medium-expert |
| 비교군 | 합쳐서 학습한 IQL, DARA, BOSA, SRPO, IGDF, OTDF |
| 평가 | Target normalized score; 5 seeds의 mean ± standard deviation |
Normalized score는 (J−Jrandom)/(Jexpert−Jrandom) × 100이다. 성공률(%)이 아니며, 여러 조건의 Total Score도 성공률 평균이 아니라 normalized score의 합이다. Source·target data quality와 target data size 5k/100k를 바꾸는 실험도 한다(§5, Tables 1–3).
구현은 IQL framework를 기반으로 하며, 본문의 actor objective에는 Q maximization과 Q-weighted behavior cloning을 함께 쓴다(§4.4, App. C).
Finding 1 — 적은 target data에서도 source correction이 큰 이득을 낸다
주 결과는 gravity·morphology의 24개 조합이다(Table 1).
| 비교 | IQL | OTDF | STC |
|---|---|---|---|
| 24개 조건 Total Score | 677.6 | 818.1 | 1045.2 |
| Hopper-medium, gravity | 11.2 ± 1.1 | 32.4 ± 8.0 | 43.4 ± 6.1 |
| Walker2d-medium, morphology | 31.5 ± 8.6 | 42.5 ± 3.1 | 56.7 ± 8.1 |
| HalfCheetah-medium, morphology | 24.5 ± 2.4 | 21.1 ± 7.6 | 19.5 ± 2.2 |
STC는 18/24개 조건에서 최고다. 논문은 합계 기준 IQL 대비 54%, OTDF 대비 27% 개선으로 설명한다. 이는 상대 개선이며 %p가 아니다. HalfCheetah morphology처럼 STC가 낮은 조건도 있다.
Finding 2 — Data quality·size를 바꿔도 평균 이득은 있지만 일관된 우위는 아니다
Target quality를 바꾼 20개 조건에서는 STC가 12개에서 최고이며 Total Score는 820.8, OTDF는 723.3이다(Table 2). Hopper morphology의 expert target에서는 STC가 53.2 ± 50.3으로 seed 편차가 매우 크다.
Target size를 늘린 실험에서는 Hopper gravity가 5k의 43.4 ± 6.1에서 100k의 66.1 ± 4.8로 오른다. 반면 Walker2d morphology·100k에서는 STC 67.4 ± 6.1, DARA 79.1 ± 3.8이다. Data가 많아져도 STC가 항상 가장 좋은 선택은 아니다(Table 3).
Friction shift의 12개 조건 합계는 STC 675.6, 최고 기존 합계인 IQL 636.8이다. 저자들은 이 shift에서는 domain gap이 작아 방법 간 격차도 작을 수 있다고 논의한다(App. E.1, Table 6).
Finding 3 — Selectivity와 reward adjustment의 강도를 조절해야 한다
λ=0은 보정을 하지 않는 조건이며 성능이 좋지 않다. 그러나 가장 좋은 λ는 task마다 다르다. α는 λ보다 덜 민감하고, 대부분의 실험에서 0.5가 유리해 공통값으로 채택한다(§5.5, Figure 3).
Action KDE는 correction 후 target action distribution과 더 가까워지는 사례를 보여 준다. 이는 (s,s′)의 nearest-neighbor pair를 구성해 비교한 시각화이며, 보정 action을 실제 환경에 실행한 전체 transition accuracy 측정은 아니다(§5.4, Figure 2).
한계와 해석
저자들이 밝힌 한계
- Forward·inverse model을 추가 학습해야 하며, 이론의 일부 가정이 강하다고 인정한다(§6).
- Target data가 적으면 inverse model이 부정확해질 수 있어, 이를 보완하는 selective mechanism이 필요하다(§4.3, App. F).
- Reward correction에는 forward-model consistency와 대응하는 별도의 신뢰도 검사가 없어, 정규화·clipping·scaling으로 보수적으로 조정한다(App. F).
- 계산 시간은 두 대표 task에서 기존 방법과 비슷한 수준이라고 보고하지만, 모든 환경·모델 크기의 비용을 검증한 것은 아니다(App. H, Table 9).
AI의 해석
비교의 통제 범위: STC와 Table 1의 IQL은 서술된 actor objective도 다르다. 따라서 그 차이를 transition correction 하나만의 완전한 통제 실험으로 읽는 데는 주의가 필요하다(§4.4, App. C).
가장 흥미로운 점은 경험을 버릴지의 선택을 넘어, 경험의 의미를 다시 붙인다는 것이다. Source의 결과를 target에서 가능한 action과 연결한다. 다만 inverse model이 제안한 action이 그 state pair를 실제로 실현할 수 있다는 전제가 중요하다. Target에서 도달 불가능한 전이나 다봉적인 inverse mapping은 별도 검증이 필요하다.
Forward와 inverse를 같은 작은 target dataset으로 학습하므로, 두 모델이 비슷한 방향으로 틀릴 수 있다. Model 간 consistency가 실제 dynamics와의 정확성을 자동 보장하지 않는다. 또한 λ>1을 쓰고 거절된 원본도 유지하므로, “전체 학습 데이터에서 mismatch를 제거한다”는 해석은 과하다.
이론은 학습 오차가 작으면 유리하다는 조건부 설명으로 읽는 편이 적절하다. 특히 finite-data bound는 state·action의 유한 cardinality를 포함하며, 연속 MuJoCo에서 신경망이 내는 correction의 정확도를 바로 계산해 주는 bound는 아니다.
더 생각해볼 질문
아래는 AI가 정리 과정에서 제안한 후속 질문입니다. 본인이 직접 작성한 의견이나 논문에서 검증한 결과로 표시하지 않습니다.
아래는 논문 밖 연구 질문이다.
- LLM tool semantics 변화: Tool의 인자나 효과가 달라졌을 때, 과거
(관측, 결과)를 새 tool call로 relabel할 수 있을까? Discrete action과 여러 가능한 호출을 다루는 inverse model이 필요하다. - Selective intervention: STC의 correction gate와 Harness-Zero의 실행 전 response correction을 연결하면, 보정의 예상 효과를 검증하는 공통 평가 틀을 만들 수 있을까?
- 실제 오차 측정: 학습에 사용하지 않는 target simulator에서 보정 action을 실행해, model consistency와 실제 transition accuracy의 관계를 확인하면 어떨까?
- 반환 정책: Gate가 거절했을 때 원본 유지·삭제·downweight를 같은 actor objective에서 비교하면, correction과 data coverage의 기여를 더 명확히 나눌 수 있다.
참고자료
정리 범위와 근거 메모
근거: arXiv v1, PDF, LaTeX 본문·부록. 수치는 표의 명시값을 따른다. 아래 AI 해석·후속 질문은 정리자(Codex)의 해석과 연구 질문이다. ICML 형식의 소스를 사용하지만, 확인한 공개 상태는 arXiv preprint다.
용어 정리
| 용어 | 의미 |
|---|---|
| Cross-domain offline RL | Dynamics가 다른 source·target의 고정 데이터로 target policy 학습 |
| Inverse policy | State pair를 설명하는 action을 추정하는 모델 |
| Transition correction | State pair를 보존하며 action·reward label 수정 |
| Selective correction | Forward-model 오차 기준으로 보정본 또는 원본 선택 |
| Normalized score | Random·expert return을 기준으로 정규화한 평가값 |
| Dynamics mismatch | 같은 state·action에 대한 다음 state 분포의 차이 |