RAGEN: Understanding Self-Evolution in LLM Agents via Multi-Turn Reinforcement Learning ↗
Zihan Wang, Kangrui Wang, Qineng Wang, Pingyue Zhang, Linjie Li, Zhengyuan Yang, Xing Jin, Kefan Yu, Minh Nhat Nguyen, Licheng Liu, Eli Gottlieb, Yiping Lu, Kyunghyun Cho, Jiajun Wu, Li Fei-Fei, Lijuan Wang, Yejin Choi, Manling Li
arXiv preprint (2025-04-24; revised 2025-05-26) · v2
- 문제: multi-turn RL은 초반의 향상 뒤에 반복적인 행동과 성능 붕괴를 보일 수 있다.
- 방법: 전체 trajectory를 조직하는 StarPO와 uncertainty filtering·gradient shaping을 사용하는 StarPO-S를 분석한다.
- 결과: 평균 reward뿐 아니라 outcome 다양성과 rollout 구성도 학습 안정성·일반화에 중요하다.
문제와 배경
배경과 읽는 관점
여러 차례 행동하는 agent에게는 한 번의 좋은 답변보다, 앞선 선택이 만든 상황에서 다음 행동을 이어가는 능력이 필요하다. 학습 데이터 역시 독립적인 정답 쌍이 아니라 서로 영향을 주는 reasoning·행동·관측의 연속이다. RAGEN은 이 상호작용을 실제로 학습시킬 때 어떤 조건에서 유용한 개선이 유지되고, 어떤 조건에서 반복 행동으로 무너지는지 분석한다.
기존 접근과 연구 질문
수학 문제 하나를 풀고 최종 답을 채점하는 RL과, 환경에 여러 번 행동하고 확률적인 결과를 받는 agent RL은 학습 조건이 다르다. 앞선 실수로 다음 observation이 바뀌고, reasoning·action·환경의 randomness가 최종 reward에 함께 영향을 준다. 이때 학습이 진행된다고 유용한 reasoning이 계속 강화되는지, 어떤 조건에서 collapse하는지가 논문의 질문이다(§1–2).
저자들은 초기에는 다양한 설명을 하던 모델이 점차 고정된 문구와 shortcut을 반복하는 현상을 Echo Trap이라고 부른다. 이는 단순히 문장이 짧아진다는 뜻이 아니라, 행동·outcome의 다양성이 줄고 성능도 무너지는 학습 패턴을 가리킨다(§4.1).
제목의 self-evolution은 주로 self-generated interaction trajectory를 사용한 weight training이다. Agent가 스스로 harness 코드를 수정하는 방법이나, test-time 경험을 영구적으로 저장하는 memory 시스템을 제안하는 논문은 아니다.
이 글에서는 최종 reward의 상승과 reasoning·행동의 다양성 유지가 같은 현상인지 구분하며 읽는다. 특히 안정화 장치가 무엇을 기준으로 rollout을 남기는지, PPO·GRPO와 framework의 관계가 무엇인지부터 살펴본다.
핵심 아이디어
먼저 직관으로 이해하기
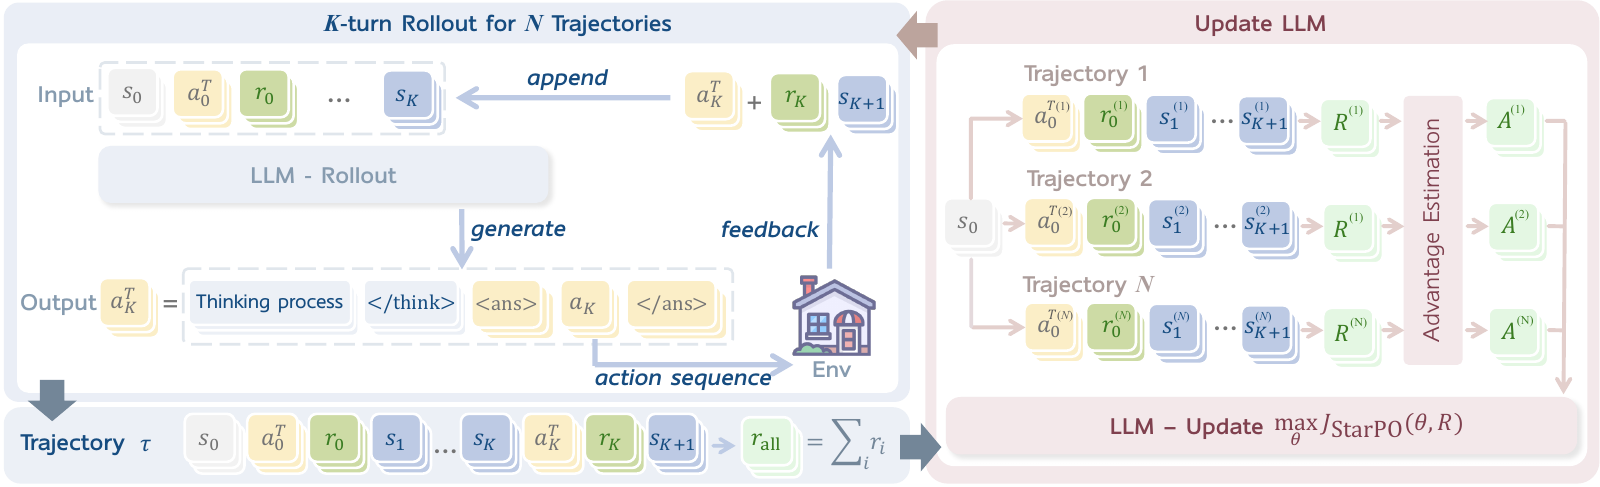
하나의 응답만 잘라서 보기보다, 상태를 관찰하고 생각하고 행동해 reward를 받는 전체 trajectory를 학습 단위로 조직한다. 같은 초기 조건에서 여러 rollout의 결과가 갈릴 때 그 차이를 학습 신호로 활용하되, 모든 결과가 비슷해지는 group이 학습에 어떤 영향을 주는지 함께 점검한다. 이 관점이 뒤의 uncertainty filtering과 collapse 진단을 연결한다.
전체 구조: Figure 2 — StarPO.
| 구성 | 역할 |
|---|---|
| StarPO | State–thinking–action–reward trajectory를 수집하고 최적화하는 공통 framework |
| RAGEN | Environment·rollout·reward·training을 연결하는 실행 시스템 |
| PPO instantiation | Critic으로 token-level value와 advantage 추정 |
| GRPO instantiation | 같은 초기 상태의 여러 trajectory reward를 비교해 advantage 구성 |
| StarPO-S | Uncertainty filtering과 gradient shaping 등을 적용한 안정화 variant |
한 turn에서 모델은 <think>…</think><answer>action</answer>를 출력하고, 환경은 action을 실행해 다음 observation·reward를 돌려준다. 이렇게 만든 여러 turn의 trajectory를 학습한다(§2).
StarPO는 PPO·GRPO를 대체하는 하나의 완전히 별개 optimizer라기보다 multi-turn rollout과 optimization을 조직하는 framework다. PPO 자체가 single-turn에만 적용 가능한 알고리즘이라는 뜻으로 읽으면 안 된다.
StarPO-S의 주요 장치는 다음과 같다(§4.2, App. D).
- Uncertainty filtering: 같은 prompt에서 여러 rollout을 얻고 reward 표준편차가 큰 prompt group을 우선 유지한다. 기본 keep ratio는 25%다.
- Critic 활용: PPO의 value estimate가 일부 환경에서 critic-free GRPO보다 안정적이다. 하지만 FrozenLake에서는 반대 결과도 있다.
- Gradient shaping: KL penalty를 제거하고 PPO clipping을 비대칭으로 설정한다. 하한
εlow=0.2, 상한εhigh=0.28을 사용한다.
“좋은 trajectory만 남긴다”와는 다르다. Filtering은 높은 reward 자체가 아니라 같은 초기 상태에서 outcome이 얼마나 갈리는지를 본다.
정의와 수식
목표는 reasoning을 포함한 전체 trajectory의 return을 높이는 것이다(§2.2). \(J(\theta)=\mathbb E_{\mathcal M,\tau\sim\pi_\theta}[R(\tau)].\) GRPO에서는 같은 초기 상태에서 얻은 trajectory i에 대해 다음 scalar advantage를 사용한다. 해당 trajectory의 token들에 같은 값이 전달된다. \(\hat A_i=\frac{R(\tau_i)-\operatorname{mean}_j R(\tau_j)} {\operatorname{std}_j R(\tau_j)}.\) Filtering에서 정의하는 outcome uncertainty는 다음과 같다(§4.2). \(U(\pi_\theta,\mathcal M,s_0)= \operatorname{Std}_{\tau\sim\pi_\theta(\cdot\mid s_0)}[R(\tau)].\) 여기서 uncertainty는 모델의 calibrated epistemic uncertainty가 아니다. Rollout reward의 경험적 표준편차이며, 환경 randomness도 영향을 줄 수 있다.
실험과 핵심 결과
실험 설정
| 환경 | 주요 성격 |
|---|---|
| Bi-arm Bandit | Symbolic arm label과 risk-sensitive choice; 단순 single-turn task |
| Sokoban | Box를 밀되 되돌릴 수 없는 deterministic planning |
| FrozenLake | Slip이 있는 stochastic navigation |
| WebShop | 자연어 요청을 제품 검색·선택에 연결하는 multi-turn interaction |
주 모델은 symbolic task의 Qwen2.5-0.5B-Instruct, WebShop의 3B다. 추가 scale·foundation-model 비교는 부록에 있다. 기본 rollout은 8 initial prompts × 16 responses, 최대 5 turns·10 actions이며, 평가에는 고정된 256 prompts와 temperature 0.5를 사용한다(§3, App. C–D).
Success rate 외에 token entropy, in-group reward std, response length, gradient norm을 본다. Sokoban에는 box·completion·action cost reward가 있고, FrozenLake에는 성공 1/실패 0 reward가 있다. 따라서 모든 실험이 오직 terminal reward만 쓰는 동일한 sparse-reward 설정은 아니다(App. C).
Finding 1 — 평균 reward만 보면 collapse 신호를 놓칠 수 있다
Bandit·Sokoban에서는 vanilla StarPO의 PPO·GRPO 모두 초반 향상 후 collapse가 나타난다. PPO는 이 두 환경에서 더 안정적이지만, FrozenLake에서는 GRPO가 더 안정적이다. WebShop은 초기 성능이 높고 두 방법 모두 개선되는 양상이다(§4.1, Figure 3).
저자들은 reward std 감소와 entropy 변동이 reward 하락에 앞설 수 있고, gradient spike가 collapse와 동반된다고 보고한다(Figure 4). 예를 들어 FrozenLake-PPO에서는 std가 step 40에서 급감한 뒤 mean reward가 step 90 부근에서 collapse한다고 본문에서 설명한다. 이 시간차는 해당 run의 관찰이며 모든 task에 공통인 예측 규칙은 아니다.
Finding 2 — 낮은 reward variance의 group을 빼면 PPO collapse가 줄어든다
Filtering은 특히 Sokoban·FrozenLake의 PPO run에서 안정화를 돕는다. FrozenLake에서 keep 75%는 안정 구간을 약 100 → 140 steps로 늘리고, keep 50%는 관찰한 학습 범위에서 collapse를 피한다고 저자들은 설명한다. GRPO에서는 개선이 작고 Sokoban의 collapse가 계속 나타난다(§4.2, Figure 5).
결과 그림: Figure 6 — StarPO vs. StarPO-S. Bandit·Sokoban·FrozenLake·WebShop의 곡선을 함께 제시한다. 기본 keep 25%가 모든 환경에서 최적이라는 주장은 아니다.
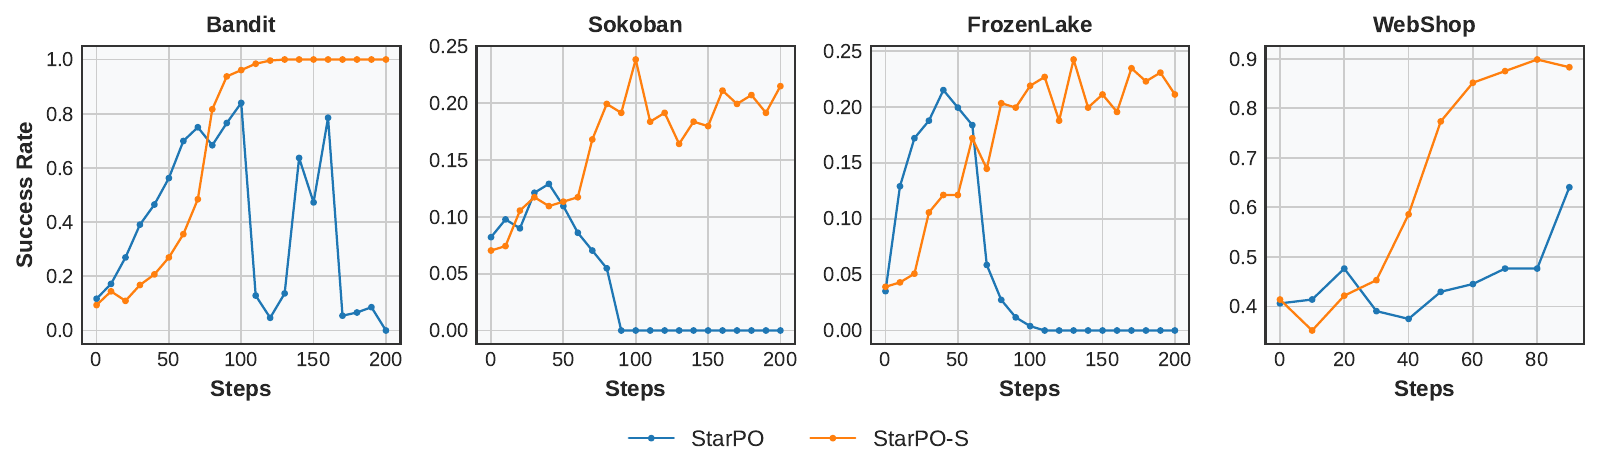
Finding 3 — 같은 batch budget에서도 rollout 구성에 따라 일반화가 달라진다
Task diversity 실험은 batch size를 고정하고 responses per prompt를 바꾼다. 16 responses에서 4 responses로 바꾸면 SokobanNewVocab은 21.48 → 25.39%, FrozenLake는 19.53 → 21.48%다. 그러나 responses를 1–2개로 줄이면 FrozenLake는 12.50%로 떨어진다. 서로 다른 결과를 비교할 만큼의 반복 rollout도 필요하다는 해석이다(§4.3, Table 1).
한 turn의 action budget은 5–6개가 유리한 조건이 많다. Sokoban은 1 action의 12.11%에서 6 actions의 33.59%로 오르지만, 7 actions에서는 22.27%로 내려간다. FrozenLake의 최고는 5 actions의 21.09%로 task별 차이가 있다(Table 2).
Rollout 하나를 여러 update에 재사용하는 Online-k 실험에서는, 매 update마다 새로 수집하는 Online-1이 Online-5·10보다 수렴·일반화에 유리하다(Figure 7). 다만 추가 수집 비용까지 포함한 모든 조건의 최적 비용 정책을 확정하지는 않는다.
Finding 4 — <think>를 출력하는 것과 유용한 reasoning은 다르다
Bandit에서는 reasoning을 유지한 모델이 NoThink보다 일반화가 좋다. 그러나 Sokoban 학습 후 multi-turn 평가에서는 이득이 작거나 뒤집힌다(§4.4, Table 3).
| 평가 | StarPO-S | NoThink |
|---|---|---|
| Bandit-trained → Bandit-Rev | 67.58 | 56.25 |
| Sokoban-trained → FrozenLake | 19.92 | 19.53 |
| Sokoban-trained → LargeSokoban | 2.34 | 2.73 |
| Sokoban-trained → SokobanNewVocab | 18.75 | 26.17 |
Sokoban의 reasoning length는 step 0/100/200에서 307.1/104.6/89.5 tokens로 줄어든다(Table 4). 부록에는 부정확하거나 hallucinated reasoning과 높은 reward가 공존하는 사례도 있다. 저자들은 reward가 reasoning quality를 충분히 구분하지 못할 수 있다고 해석하며 finer-grained supervision을 향후 과제로 제안한다.
한계와 해석
저자들이 밝힌 한계
- 상대적으로 작은 task에 집중했고 multimodal task는 다루지 않았다(§6).
- Replay buffer 같은 기존 RL 기법의 실증 연구가 빠졌다고 인정한다. Framework에서 replay를 지원할 수 있다는 설명과, 실험에서 체계적으로 검증했다는 주장은 구분해야 한다.
- 공격적인 filtering ratio가 모든 task에서 적절하지 않을 수 있다(§4.2).
- 더 세밀한 reasoning reward는 중요한 미래 방향이지만, 본 논문에서 보편적인 해결책을 완성한 것은 아니다(§4.4).
AI의 해석
이 논문의 가치는 최고 benchmark 점수보다 agent RL의 실패를 측정 가능한 현상으로 분해한 것에 있다. Mean reward와 함께 diversity·gradient를 추적하는 설계는 후속 학습 실험의 진단에 유용하다.
다만 outcome variance는 epistemic uncertainty와 stochastic outcome을 섞는다. 확률적 환경에서 높은 std인 prompt를 계속 선택하는 것이 항상 가장 학습 가치가 높다는 보장은 없다. 또한 filtering 후 update 비용 감소와 동일 interaction budget에서의 sample efficiency는 별개다.
Reasoning length 감소만으로 추론 능력 감소를 확정할 수 없다. NoThink 비교와 사례 분석은 우려를 뒷받침하지만, reasoning-aware reward가 반드시 필요하다는 보편적 인과 결론은 더 많은 모델·환경·reward 통제가 필요하다.
When Greedy Wins와 Bandit을 구분해야 한다. RAGEN의 symbolic bi-arm 선택은 그 논문의 50–300회 unknown-arm 통계 추론과 다른 task다. 두 논문의 “reasoning” 또는 “exploration” 결과를 같은 지표로 직접 비교하기 어렵다.
더 생각해볼 질문
아래는 AI가 정리 과정에서 제안한 후속 질문입니다. 본인이 직접 작성한 의견이나 논문에서 검증한 결과로 표시하지 않습니다.
아래는 논문 밖 연구 질문이다.
- 탐색 붕괴의 조기 탐지: Reward std·token entropy가 LaMer의 cross-episode adaptation에서도 미래 실패를 예측할까?
- Noise와 학습 가능성 분리: 같은 environment seed를 재사용한 variance와 새 seed의 variance를 나누면 더 좋은 filtering signal을 만들 수 있을까?
- Reasoning의 실질적 기여: Reasoning token을 가리거나 바꾸었을 때 이후 action·성공률이 어떻게 달라지는지 측정하면, 길이 이상의 인과 지표를 얻을 수 있다.
- Failure-aware curriculum: 모든 고분산 group을 동일하게 유지하지 않고, 실패 원인이 달라지는 group이나 correction으로 회복 가능한 group을 우선하면 어떨까?
참고자료
정리 범위와 근거 메모
근거: arXiv v2, PDF, LaTeX. 본문·부록의 명시 수치를 사용했다. 학습 곡선의 값을 임의로 추출하지 않았다. 아래 AI 해석·후속 질문은 정리자(Codex)의 해석과 연구 질문이다.
용어 정리
| 용어 | 의미 |
|---|---|
| Echo Trap | 반복되는 reasoning·행동 양식과 성능 collapse가 결합한 학습 실패 |
| StarPO | Reasoning을 포함한 multi-turn trajectory optimization framework |
| RAGEN | StarPO의 rollout·환경·학습을 지원하는 시스템 |
| StarPO-S | Filtering·critic·gradient shaping을 활용한 안정화 variant |
| Outcome uncertainty | 같은 초기 상태의 rollout reward 표준편차 |
| Online-k | 한 rollout batch를 k번의 policy update에 재사용하는 설정 |