ModularRSI: Modular and Generalizable Recursive Harness Self-Improvement ↗
Siwei Wu, Jincheng Ren, Yizhi Li, Haau-Sing Li, Chengran Yang, Xudong Ma, Yuxuan Zhang, Weicheng Gu, Jian Yang, Riza Batista-Navarro, Chuanyi Zhang, Xianglong Liu, Ming Zhou, Bryan Dai, Chenghua Lin
arXiv preprint (v2 2026-10-09), ICLR 2027 template 사용 (게재 확정 여부는 이 원문으로 확인되지 않음) · v2
- 문제: 단일 실패에서 harness 전체를 수정하면 task별 추론 실수와 공통 실행 결함이 섞인다.
- 방법: 성공·실패 대조와 task 간 근거 집계로 수정할 기능을 찾고 모듈별로 독립 진화 후 통합한다.
- 결과: coding·terminal benchmark와 모델 간 전이를 보고하며, gate의 실행 검증을 held-out 성능 보장과 구분해야 한다.
문제와 배경
배경과 읽는 관점
하나의 실패를 보고 agent의 전체 실행 코드를 바꾸면 문제별 실수와 반복적인 실행 결함을 구분하기 어렵다. 진단이 맞더라도 관계없는 모듈까지 함께 바뀌면 수정의 효과를 해석하기도 힘들다. ModularRSI는 실패 원인을 찾는 문제와 그 원인을 고칠 위치를 정하는 문제를 연결한다.
기존 접근과 연구 질문
긴 coding·terminal task에서는 모델이 답을 생각하는 능력과, 그 생각을 환경에서 실행하는 장치가 함께 성능을 결정한다. 여기서 harness는 실행 loop, tool 호출, observation 처리, context 압축, 종료 판단을 담당한다(§1, §3.2).
저자들은 harness self-improvement를 두 층의 credit assignment로 정의한다(§1).
| 층위 | 답해야 하는 질문 | 해결 장치 |
|---|---|---|
| Behavioral attribution | 실패에서 어떤 실행 행동이 반복적으로 문제였나? | 같은 task의 성공·실패 비교 + 여러 task의 근거 집계 |
| Mechanism localization | 그 행동을 harness의 어느 부분에서 바꿔야 하나? | 기능별 모듈 분해 + target module 안에서만 수정 |
같은 task에서도 sampling에 따라 성공과 실패가 갈린다. 이를 비교하면 task 내용 자체보다 요구사항을 잊었는지, tool을 잘못 해석했는지, 검증 없이 종료했는지 같은 실행 차이를 찾을 수 있다. 하지만 원인을 찾았더라도 전체 harness를 자유롭게 고치면 관계없는 부분까지 바뀔 수 있다. 따라서 저자들의 중심 가설은 수정 공간을 넓히는 것보다 attribution을 정확하게 하는 것이 일반화에 중요하다는 것이다(§1).
핵심은 수정 권한을 넓히는 것보다, 여러 task가 지지하는 실행 문제를 찾아 제한된 모듈에서 고치는 것이 일반화에 유리한가다. 이 글에서는 behavioral attribution과 mechanism localization이라는 두 층을 나눠 방법을 읽는다.
핵심 아이디어
먼저 직관으로 이해하기
같은 task의 성공·실패를 대조하고 여러 task에서 비슷한 진단을 모아, 한 문제에만 맞춘 patch를 줄이려 한다. 이후 harness를 기능별 모듈로 나누어 독립적으로 진화시키고 통합한다. 최종 평가에서는 이미 만들어진 function library를 고정하고 task에 맞는 기존 function만 선택한다.
전체 과정은 Figure 1 — ModularRSI overview에 있다.
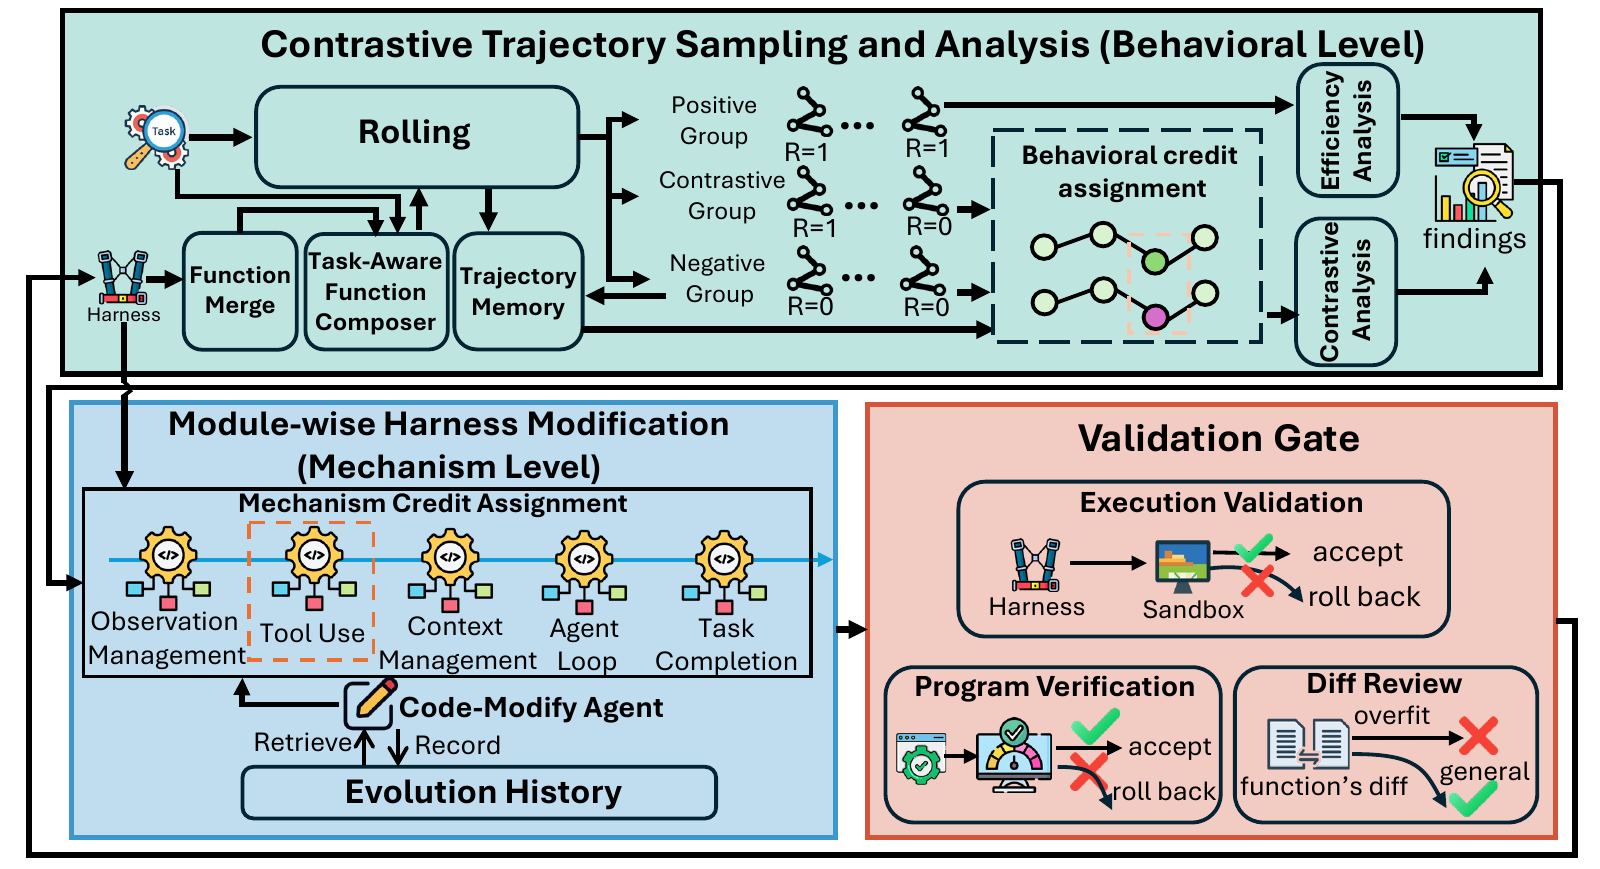
다섯 모듈을 같은 출발점에서 따로 진화시킨다 (§3.1–3.2, App. B)
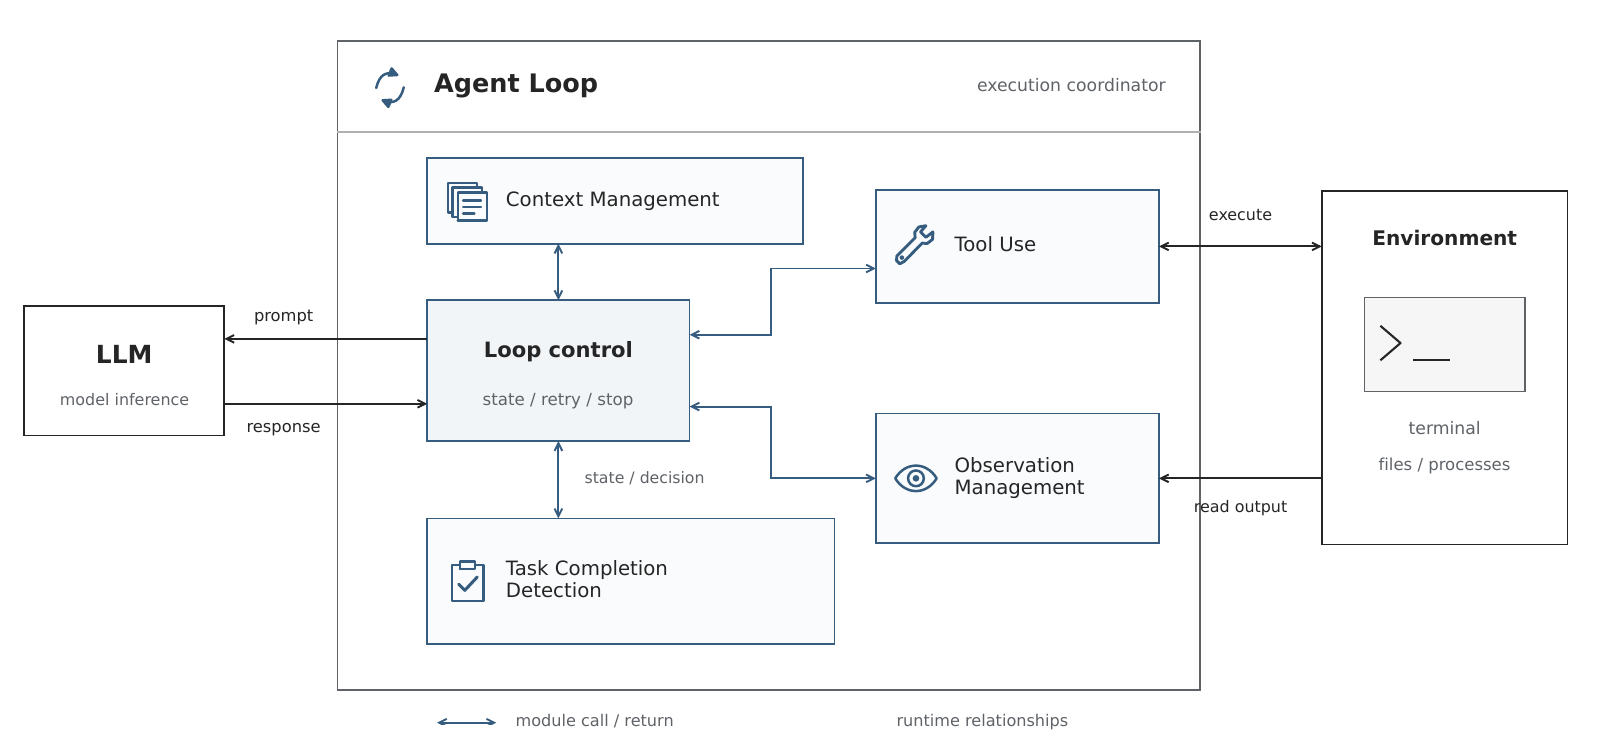
Harbor의 Terminus-2를 기능별로 재구성한다. sandbox 초기화, 병렬 실행 인프라, LLM 통신은 evolution 대상 밖이다.
| 모듈 | 담당 기능 | 다른 모듈과의 경계 |
|---|---|---|
| Agent Loop | reasoning–action–observation cycle, retry·recovery, 실행 상태 관리 | 다른 네 모듈을 호출하고 실행 계속 여부를 제어 |
| Tool Use | 모델 응답 parsing, command 실행, tool 오류 처리 | 모델의 텍스트를 실제 환경 action으로 연결 |
| Observation Management | terminal 출력 획득·필터링·압축 | 현재 환경 feedback을 다룸 |
| Context Management | history 보존·압축·검색 | 누적된 대화와 원래 task를 다룸 |
| Task Completion Detection | 완료 여부와 근거 반환 | stop을 권고하며, 실제 제어와 상태 관리는 loop가 담당 |
다섯 lineage는 같은 초기 harness에서 출발하고 중간 수정은 공유하지 않는다. 각 lineage에서는 target module만 고친다. 독립 evolution을 마친 뒤 결과를 합치고 한 epoch 동안 interaction을 정리한다. 병렬 처리가 가능한 설계다(§3.1).
실행 구조는 Figure 3 — harness architecture와 App. B의 interface에 자세히 나온다. 예를 들어 VerificationLoop.should_terminate()는 boolean과 reason을 반환하지만, completion 선언 횟수와 확인 prompt는 loop가 관리한다. 따라서 종료와 관련된 모든 수정이 반드시 Completion Detection 모듈 안에서만 생기는 것은 아니다.
성공한 trajectory도 분석한다 (§3.3, App. I, J.1)
각 task를 여러 번 실행해 binary reward로 세 그룹을 만든다. 주요 실험은 task당 세 trajectory다.
| 그룹 | 현재 rollout 결과 | 분석 방식 |
|---|---|---|
| Contrastive | 성공·실패 혼재 | 같은 task에서 행동이 갈린 지점과 가능한 module 수정을 비교 |
| Negative | 모두 실패 | 과거 같은 task의 성공이 있으면 짝지음. 없으면 실패 evidence로 진단 |
| Positive | 모두 성공 | 불필요한 retry·중복 작업 등 효율 개선 기회 탐색 |
Trajectory Memory가 epoch 간 task별 기록을 보관한다. infrastructure-only 실패는 harness 진단에서 제외한다(App. I).
분석 결과는 JSON finding이다. 핵심 필드는 evidence, target module, 수정 가능 여부, 제안 행동, 그리고 그 모듈을 바꿨다면 결과가 좋아졌을지에 대한 판단이다. 근거가 없으면 is_culprit=false로 수정하지 않을 수 있다. 이는 LLM이 하는 counterfactual 판단이며, 그 자체가 개입 실험의 결과는 아니다(App. I, J.1).
여러 task가 지지한 수정을 우선한다 (§3.4)
같은 function에 대해 의미가 비슷한 진단을 모은다. 후보의 vote는 trajectory 수가 아니라 그 수정을 지지하는 서로 다른 task 수다. vote가 높은 상위 10개 후보를 우선 수정한다. 함수별 Evolution History를 참고해 기존 기능을 지우거나 같은 수정을 반복하는 일을 줄인다.
task 수행 agent가 Code-Modify Agent로서 분석과 코드 변경도 맡는다. 수정 지시문은 가장 눈에 띄는 task 하나에 맞추지 말고, 해당 방향을 지지한 전체 evidence에 맞는 shared mechanism을 구현하도록 요구한다(§3.1, App. J.2).
gate는 실행 가능성과 일반적인 변경인지 검사한다 (§3.5, App. C, J.3)
각 function update는 다음 세 gate를 차례로 통과해야 하며 실패하면 diff로 rollback한다.
- Program Check: AST, import, protocol, discovery contract, self-attribute 등의 정적 검사.
- Diff Review: reward-blind review로 변경의 mechanism과 trajectory evidence가 연결되는지 확인하고, task 이름·특정 파일·특정 출력·task에 맞춘 상수 등을 거절.
- Execution Validation: 현재 batch에서 무작위 task 두 개를 실행해 runtime error와 protocol 위반 검사.
별도 held-out validation task의 accuracy가 올라야 accept하는 규칙은 본문과 App. C에 제시되지 않는다. 여기서 validation은 주로 변경의 유효성·실행 안정성과 task-specific patch 여부를 검사한다. 최종 비교에는 마지막 generation의 harness를 사용한다(App. F).
function을 쌓은 뒤 선택하고, 통합 시 충돌을 줄인다 (§3.6–3.7, App. J.4)
Function Merge는 module 안에서 중복 기능을 합친다. Task-Aware Function Composer는 task 설명과 function의 자연어 설명을 보고 사용할 subset을 고른다. composer는 trajectory 수집과 최종 평가에서 모두 작동한다.
통합 epoch는 중복 mechanism 제거, 책임 조정, coordination 수정에 쓰인다. 공개된 run-in 지시문은 새 capability를 추가하기보다 한 번에 하나의 coherent repair를 하도록 제한하고 composer·kernel 등은 수정하지 못하게 한다(App. J.4).
평가 시점에는 function library가 고정된다. 새 task에 맞춰 기존 function을 고를 수 있지만, function merge나 코드 수정은 하지 않는다. 따라서 “고정 harness”에도 task별 composition은 포함된다(§3.7).
정의와 수식
아래는 §5.2의 정의를 표기만 정리한 것이다. task i의 세 실행 reward를 r_i1, r_i2, r_i3 ∈ {0,1}이라 하면: \(\mathrm{Acc}=\frac{1}{3N}\sum_{i=1}^{N}\sum_{k=1}^{3}r_{ik},\qquad \mathrm{Pass@3}=\frac{1}{N}\sum_i \mathbf{1}\!\left[\sum_k r_{ik}\ge 1\right],\qquad \mathrm{Pass}^{3}=\frac{1}{N}\sum_i \mathbf{1}\!\left[\sum_k r_{ik}=3\right].\) Pass@3는 세 번 중 한 번이라도 성공한 task 비율, Pass³는 세 번 모두 성공한 task 비율이다. StepNum은 rollout당 평균 agent–environment interaction 수다. 수치 개선은 상대 증가율이 아니라 %p로 표시한다.
본문에서 K는 trajectory 수와 상위 수정 후보 수에 각각 쓰이므로 혼동에 주의한다. 주요 실험의 rollout은 3회이고, 수정 후보의 top-K는 10개다(§3.3–3.4, §6.3, App. F).
실험과 핵심 결과
실험 설정
| 항목 | 설정 |
|---|---|
| Evolution dataset | 외부 자료로 만든 executable task 2,000개. GitHub, Hugging Face, Kaggle, Linux kernel 문서 등에서 수집 |
| Benchmark-disjoint 의미 | benchmark instance·trajectory·evaluator feedback·task-specific 내용은 evolution에 사용하지 않음. 단, task category는 수집 지침으로 사용 |
| 품질 검사 | 환경·실용성·evaluator LLM 검사, reference solution 통과, no-op 무보상, 수동 검토, benchmark와 semantic similarity screening |
| 주요 evolution | TB-related 120개와 SWE-related 120개로 각각 독립 evolution. 합쳐 240개로 하나를 학습한 조건이 아님 |
| 기본 모델·harness | DeepSeek-V4-Flash-Preview, Terminus-2 baseline |
| 예산 | module당 3 epochs × 5개 + integration 1 epoch. joint·non-modular·AHE·Meta-Harness는 16 epochs |
| 기타 | batch size 10, TPM limit 2M. AHE·Meta-Harness 비교에서 모든 방법의 web search 비활성화 |
| 평가 | TerminalBench 2.0 89 tasks, SWE-Bench Verified 500 tasks, Harbor 사용 |
| 통계 | fixed harness를 세 번 실행. task를 묶은 paired bootstrap 100,000회로 accuracy 차이의 95% CI 산출 |
근거: §4–5, §6.3, App. F–G. TPM은 처리율 상한이지 총 token 예산이 아니다.
Finding 1 — 같은 도메인의 새로운 benchmark task뿐 아니라 다른 evolution 도메인에도 전이된다 (Table 1)
Accuracy (%) 비교다. 각 benchmark 열에서 같은 no-evolution baseline을 사용한다.
| Evolution set | SWE-Bench Verified | TerminalBench 2.0 |
|---|---|---|
| 없음 | 73.40 | 47.57 |
| TB-related 120 | 75.80 (+2.40%p, cross-domain) | 52.43 (+4.86%p, in-domain) |
| SWE-related 120 | 76.40 (+3.00%p, in-domain) | 49.44 (+1.87%p, cross-domain) |
여기서 in-domain도 benchmark task를 evolution에 썼다는 뜻은 아니다. 유사한 범주의 별도 task로 evolution하고 downstream benchmark에서 평가했다.
TB-related evolution의 TB 성능은 Pass@3 58.43→65.17, Pass³ 30.34→35.96다. 반면 SWE-related→TB의 Pass³는 30.34로 그대로다. accuracy 개선과 모든 조건의 reliability 개선을 동일시하면 안 된다(Table 1).
App. G의 reported 95% CI는 TB-related→TB accuracy 차이가 [3.37, 9.36]%p, SWE-related→SWE는 [1.06, 4.26]%p다. 이 구간은 고정된 최종 harness의 task 수준 bootstrap 결과다.
Finding 2 — evolution에 쓰지 않은 inference model에서도 개선된다 (Table 2)
DeepSeek-V4-Flash-Preview와 TB-related data로 만든 동일한 frozen library를 다른 모델에 적용한다.
| Inference model | Baseline Acc | Evolved Acc | 차이 |
|---|---|---|---|
| GLM-5.2 | 59.55 | 61.80 | +2.25%p |
| MiniMax-2.5 | 41.57 | 44.94 | +3.37%p |
| DS-V4-Flash | 47.57 | 52.43 | +4.86%p |
별도로 App. D는 다른 모델로 evolution 절차를 다시 실행하는 실험이다. DS-V4-Flash-0731은 61.79→67.42, Qwen3.8-Max는 61.05→64.79다. 이것을 frozen harness의 직접 전이 결과와 섞지 않는다.
Finding 3 — 전체 수정 권한을 주는 것보다 module별 독립 evolution이 낫다 (Table 3)
| Evolution 방식 | TB Acc | Pass³ | StepNum |
|---|---|---|---|
| No Evolution | 47.57 | 30.34 | 34.70 |
| Non-modular Evolution | 46.44 | 24.72 | 29.03 |
| Joint All-Module Evolution | 44.19 | 24.72 | 44.34 |
| ModularRSI | 52.43 | 35.96 | 35.57 |
같은 aggregate epoch·trajectory 예산에서 두 대안은 accuracy가 baseline 아래로 내려간다. 많이 바꿀 수 있다고 더 좋아지는 것은 아니다라는 설계 가설을 지지한다. 다만 ModularRSI의 최종 step 수도 baseline보다 조금 크므로 전반적인 실행 효율 개선으로 요약하지 않는다.
Finding 4 — module별 개선의 성격이 다르고, 통합 결과가 가장 높다 (Table 4)
| 독립 evolution한 모듈 | TB Acc | StepNum |
|---|---|---|
| Context Management | 49.44 | 35.10 |
| Tool Use | 50.19 | 41.28 |
| Agent Loop | 50.56 | 40.40 |
| Observation Management | 49.81 | 22.50 |
| Task Completion Detection | 49.44 | 31.06 |
| 전체 통합 | 52.43 | 35.57 |
모든 single-module 조건에서 accuracy가 오른다. Agent Loop가 단일 module 중 가장 높은 accuracy를 보이고, Observation Management는 baseline 34.70에서 22.50으로 step을 줄인다. 통합은 가장 높은 accuracy를 얻지만 가장 낮은 step을 보존하지는 않는다.
Finding 5 — contrastive analysis, library 관리, gate를 빼면 각각 나빠진다 (Table 5)
| 조건 | TB Acc |
|---|---|
| Full | 52.43 |
| CTA 제거 | 50.56 |
| Function Library Management 제거 | 49.81 |
| Validation Gates 제거 | 48.31 |
| No Evolution | 47.57 |
gate 제거의 감소가 가장 크다. FLM ablation은 merge와 task-aware composition을 묶은 구성요소를 제거한 결과이므로 둘의 독립 기여를 분리한 수치는 아니다(§3.7, §6.4).
Finding 6 — 통일된 protocol의 기존 방법 재현보다 높다 (Table 6, App. F–G)
TB accuracy는 Meta-Harness 49.44, AHE 49.81, ModularRSI 52.43이다. 세 방법은 Terminus-2, 같은 TB-related 120 task, 같은 모델·TPM, 맞춘 aggregate epoch 예산을 쓴다. 이는 저자들이 Harbor로 adaptation·재현한 조건의 비교다.
App. G에서 baseline 대비 Meta-Harness와 AHE의 차이 CI는 각각 [-0.07, 2.24], [-0.03, 2.62]%p로 0을 포함한다. ModularRSI의 baseline 대비 CI는 0 위다. 이 표는 ModularRSI와 AHE 사이의 직접 paired CI를 제공하는 것은 아니다.
Finding 7 — 데이터 양뿐 아니라 성공·실패 대조가 가능한 난이도가 중요하다 (§6.6, App. H, L)
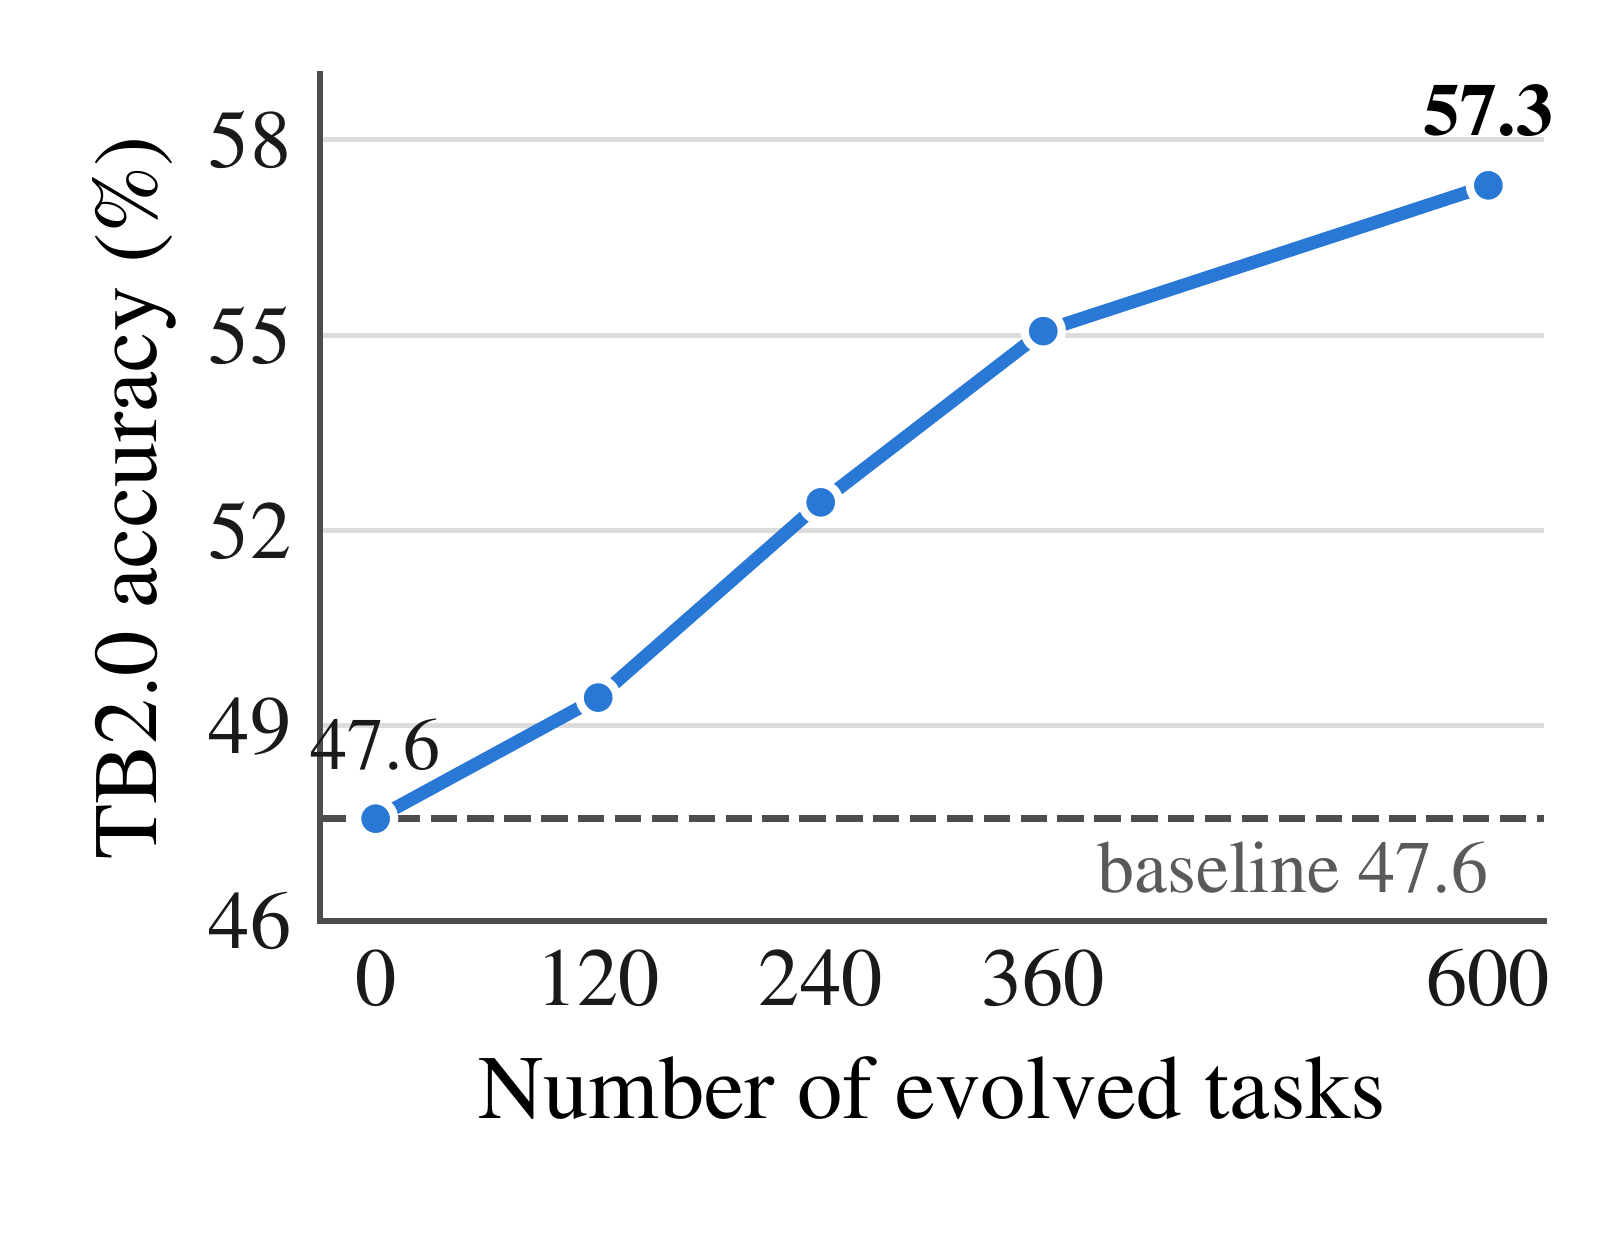
Figure 2 — evolution task 수 scaling은 epoch를 1로 고정하고 120·240·360·600 task를 비교한다. task 수가 커질수록 TB accuracy가 증가하며 600 task의 figure 표기는 57.3%다. 이는 주 실험의 120 task·module당 3 epochs 조건과 다른 scaling 실험이다. 중간 점의 정확한 값을 본문 표 없이 추정해 적지는 않는다.
SWE-related data의 난이도를 중간에 집중한 조건은 SWE accuracy 76.40, 쉬운 것과 어려운 것에 집중한 조건은 74.20이다(App. H). 난이도는 네 모델로 생성한 총 여덟 trajectory의 성공률로 추정한다. 중간 조건은 성공률 40–60% 구간 task가 50%, 양극 조건은 10%다(App. L).
Finding 8 — 실제 변경은 요구사항 유지·완료 검증·tool parsing 같은 실행 mechanism이다 (App. K)
| 근거 그룹 | 원래 문제 | 진화한 변경과 후속 관찰 |
|---|---|---|
| Contrastive | Scala→PySpark 이식에서 명시적 NULL 제거 요구와 legacy code가 충돌 | task checklist를 유지하는 loop. 뒤의 rollout에서 요구사항을 유지하고 검증. task 성공은 1/3→2/3 |
| Negative | FFmpeg 실행은 되지만 요구된 shared library 연결이 빠진 채 완료 선언 | acceptance checklist를 재제시하고 실제 검증 요구. epoch 3에서 3/3 성공 |
| Positive | Go 수정 task는 성공하지만 multiline write_file이 shell로 잘못 전달돼 retry 발생 | command 이름과 file content를 구분하는 dispatcher. 성공은 유지하고 평균 episode 36→25 |
저자들은 이 후속 실행들에 다른 update도 함께 들어 있으므로 단일 변경의 효과를 분리한 비교가 아니라고 명시한다(App. K.4).
한계와 해석
저자들이 밝힌 한계
별도의 Limitations 절은 없다. 공개된 본문·부록의 단서는 다음과 같다.
- 계산·시간 제약으로 주 실험은 구축한 2,000개 중 각 도메인 120개만 사용한다. 더 큰 subset은 별도의 1-epoch scaling으로 다룬다(§5.3, §6.6).
- 경험이 항상 contrastive하지 않다. App. K.1의 1,800 group 집계에서 현재 성공·실패 pair는 732개(40.67%), 모두 성공 648개(36.00%), 과거 성공도 없는 모두 실패는 262개(14.56%)다. historical success를 붙인 150개(8.33%)는 subsequent replay에서 사용했다고 적는다. 유효 점수가 없는 group은 8개다. 이 표 전체를 현재 rollout에서 직접 얻은 pair 비율로 읽으면 안 된다.
- 모듈을 조합하면 중복·충돌이 생길 수 있어 integration 단계가 따로 필요하다(§3.6).
- 사례 비교는 다른 update의 영향도 포함하므로, 특정 수정 하나가 개선을 만들었다고 고립해서 입증하지 않는다(App. K.4).
AI의 해석
아래는 논문의 주장이 아니라 정리자(Codex)의 해석이다.
- 모듈 제한은 causal proof보다 탐색의 제약으로 이해하는 편이 정확하다. 같은 code에서 sampling만 다른 trajectory pair는 유용하지만 여러 행동이 함께 달라진다. LLM의 counterfactual finding과 task vote는 가설을 선별한다. 개별 function의 인과 기여를 확정하려면 같은 시작 상태·동일 조건에서 patch 유무를 비교하는 개입 실험이 필요하다(§3.3–3.4, App. J, K).
- benchmark-disjoint는 연구 과정 전체의 benchmark-blind와 다르다. category를 참고해 data를 구성했고 App. M은 여러 generation을 TB에서 평가해 evolution curve를 그린다. 이것만으로 benchmark reward가 수정 loop에 흘러들었다고 단정할 수는 없다. 다만 최종 실험 설계·hyperparameter 선택까지 완전히 blind였는지는 본문으로 확인되지 않는다(§4, App. M).
- 신뢰구간은 evolution 재현성과 구분해야 한다. App. G는 고정 harness의 세 rollout을 task별로 묶어 bootstrap한다. 독립적인 evolution seed를 여러 번 돌렸을 때 만들어질 library·성능의 분산은 보고하지 않는다. 또한 여러 baseline 대비 CI만으로 방법 간 직접 우열의 통계적 유의성을 대신할 수 없다.
- matched budget은 같은 총비용을 뜻하지 않는다. 5×3+1과 16 epoch를 맞췄지만 분석·수정·review·composer·execution validation이 소비하는 token, wall-clock, sandbox 비용의 총계는 제시되지 않는다. 성능 결과는 지지되지만 비용 효율 우열은 이 자료만으로 판단하기 어렵다(§5.3, App. F).
- gate는 일반화의 보증 장치가 아니다. 두 task sanity 실행과 LLM diff review는 오류·노골적 task 특화를 줄일 수 있다. 그러나 held-out regression suite나 개선량 기준 없이도 update가 남을 수 있다. gate 제거 ablation은 묶음 장치의 유용성을 지지하지만 어떤 검사 덕분인지 분리하지 않는다(§3.5, Table 5).
- integration의 추가 효과는 더 분리해서 볼 수 있다. Table 4는 single-module harness들과 최종 통합을 비교한다. 단순히 다섯 결과를 합치기만 한 조건이 없어, 최종 이득 중 complementarity와 integration epoch의 repair가 각각 얼마나 기여했는지는 분리되지 않는다.
- 전이는 확인됐지만 적용 범위는 coding·terminal 중심이다. TB와 SWE는 다른 task 분포지만 둘 다 Harbor 기반 executable software 환경이다. browser·GUI·장기 memory 등으로의 전이를 직접 보여 준 결과는 아니다. 또한 frozen library에도 task-aware selection이 포함되므로 composer 없이 단일 고정 bundle을 옮긴 결과와는 구분해야 한다(§3.7, §5.1).
- LiteEvo와의 차이는 평가 단위와 선택 규칙에 있다. 기존 LiteEvo 노트의 근거와 비교하면, 둘 다 same-task contrast와 library를 쓰지만 LiteEvo는 benchmark별 train/val에서 composition을 만들고 validation pass@2로 best를 선택한다. ModularRSI는 외부 task에서 module별로 진화시키며, 마지막 library를 downstream task마다 선택해 적용한다. LiteEvo의 AppWorld cross-benchmark library 전이 실패와 ModularRSI의 TB↔SWE 전이 성공은 환경·모델·budget이 달라 직접 승패로 읽을 수 없다.
더 생각해볼 질문
아래는 AI가 정리 과정에서 제안한 후속 질문입니다. 본인이 직접 작성한 의견이나 논문에서 검증한 결과로 표시하지 않습니다.
💭 연구 아이디어 — 이 논문이 검증한 결과가 아니다.
- Attribution 검증: task vote가 높은 patch가 실제 held-out task에서도 더 효과적인가? 무작위 patch·single-task patch와 같은 token 예산으로 비교할 수 있을까?
- LiteEvo와 결합: module별 독립 lineage에 held-out performance gate를 넣으면 regression은 줄고 탐색은 지나치게 보수적으로 바뀌지 않을까?
- Environmental Novelty: tool 문법·출력 형식이 변했을 때 전체 library를 다시 진화시키는 것보다 해당 module만 갱신하는 편이 적은 경험으로 회복할까?
- Agent Plasticity: 최종 accuracy뿐 아니라 rollout·optimizer token당 개선 속도, plateau, 과거 task 회귀를 함께 측정하면 modular evolution의 경험 효율은 어떤가?
- MemCo와 연결: shared memory에 task 해법 대신 module별 failure evidence와 적용 조건을 저장하면 새로운 환경에서 선택 오류를 줄일 수 있을까?
- Composition의 기여: library와 inference model을 고정하고 task-aware composer, 고정 bundle, random bundle을 비교하면 transfer가 function 자체와 selection 중 어디서 생기는지 분리할 수 있을까?
참고자료
정리 범위와 근거 메모
읽은 범위: v2 LaTeX 본문과 부록 A–M, 표·지시문, Figure 1·2의 원본 PDF. 근거는 LaTeX 원문, 원문 PDF, HTML. 소스에 주석 처리된 이전 문안·수치는 사용하지 않았다. 아래 AI 해석·후속 질문은 정리자 해석이다.
용어 정리
| 용어 | 이 논문에서의 뜻 |
|---|---|
| Harness RSI | 실행 경험으로 agent의 실행 제어·tool·context 관련 코드를 반복 수정하는 절차 |
| Benchmark-disjoint | downstream benchmark의 instance·trajectory·reward를 evolution에 쓰지 않는 구성 |
| Lineage | 하나의 target module만 독립적으로 수정해 온 evolution 경로 |
| Behavioral credit assignment | 성공·실패 차이에서 재사용 가능한 행동 결함을 찾는 것 |
| Mechanism credit assignment | 수정 책임을 harness의 특정 module·function에 국소화하는 것 |
| Trajectory Memory | evolution task의 과거 trajectory·reward 보관소 |
| Evolution History | function별 코드 변경과 누적 기능 기록 |
| Function library | evolution된 function variant의 집합. 최종 평가 전에 고정됨 |
| Composer | task 설명을 보고 기존 function 중 활성화할 subset을 고르는 LLM |
| Pass@3 / Pass³ | 세 번 중 한 번 이상 성공 / 세 번 모두 성공한 task 비율 |