LiteEvo: Automated, Cost-Efficient Harness Evolution for Generalization to Unseen Tasks ↗
Euntae Choi†, Sumin Song†, Sungjoo Yoo* († equal contribution, * corresponding)
arXiv preprint (2026-09-27), ICLR 2027 template 사용 (게재 확정 여부는 이 원문으로 확인되지 않음) · v1
- 문제: 자동 harness 개선에는 benchmark별 seed, 높은 optimizer 비용, 일반화 평가의 구분이 필요하다.
- 방법: 성공·실패 대조에서 component를 만들고 library로 harness를 조립하며 validation pass@2 gate로 선택한다.
- 결과: 낮은 meta-agent API 비용과 같은 benchmark의 unseen-task 개선을 보고하지만 범용 library 전이는 약하다.
문제와 배경
배경과 읽는 관점
Agent의 실패에는 모델의 추론 외에도 action 형식, observation 처리, 제출 절차 같은 실행 장치가 관여한다. 이런 부분을 자동으로 개선하려면 어떤 실패를 보고 무엇을 바꿀지 결정해야 하고, 그 과정 자체의 API 비용도 든다. LiteEvo는 공통 출발점과 component library를 이용해 이 탐색을 조직한다.
기존 접근과 연구 질문
agent가 실패했다고 해서 모델 자체의 능력이 부족한 것은 아니다. action 형식을 잘못 쓰거나, 로그인 방법을 모르거나, 같은 오류를 반복하거나, 성공한 작업을 제대로 제출하지 못했을 수 있다. 저자들은 이런 모델과 환경 사이의 실패를 harness를 바꿔 해결할 수 있는지 묻는다(§1, §2).
비교 대상인 HarnessX에 대한 저자들의 문제 제기는 세 가지다. benchmark마다 사람이 만든 seed harness가 필요하고, meta-agent token 예산이 크며, 기존 보고 결과가 evolution에 사용한 과제와 분리된 held-out 평가를 포함하지 않는다는 것이다. LiteEvo는 benchmark별 seed 없이 출발하는 절차, 낮은 optimizer API 비용, 미관측 과제에서의 성능을 함께 평가한다(§1).
다만 이 논문에서 쓰는 generalization은 구분해야 한다(§2, App. D.2, D.4).
| 일반화의 단위 | 평가한 내용 | 결과의 범위 |
|---|---|---|
| 같은 benchmark의 unseen task | train에서 evolution, val에서 선택, test에서 평가 | 네 benchmark에서 개선 유지 |
| 같은 AppWorld의 unseen app | train에서 쓰지 않은 app이 필요한 test-challenge | inductive pass@2 48.6% |
| unseen benchmark | 다른 네 benchmark의 library로 AppWorld harness 조립 | 2,502 episode 중 성공 1회 |
| 절차의 재사용 | 같은 loop로 benchmark마다 library를 새로 학습 | 다섯 benchmark에서 실험 |
이 글에서는 낮은 비용이라는 주장이 어떤 비용 항목을 뜻하는지, 새로운 task에 대한 평가가 새로운 benchmark로의 전이와 어떻게 다른지 먼저 구분한다. 같은 절차를 여러 benchmark에서 다시 돌리는 것과 이미 얻은 library를 곧바로 다른 benchmark에 쓰는 것은 별개의 실험이다.
핵심 아이디어
먼저 직관으로 이해하기
같은 task에서 성공과 실패가 갈린 trajectory를 비교하면, 문제 내용보다 실행 절차의 차이를 조사할 실마리를 얻을 수 있다. LiteEvo는 이 차이를 재사용 가능한 component로 저장하고, 다음 round의 harness를 library에서 다시 조립한다. Validation gate는 후보를 평가하되 library의 갱신과 현재 harness의 채택을 별도로 관리한다.
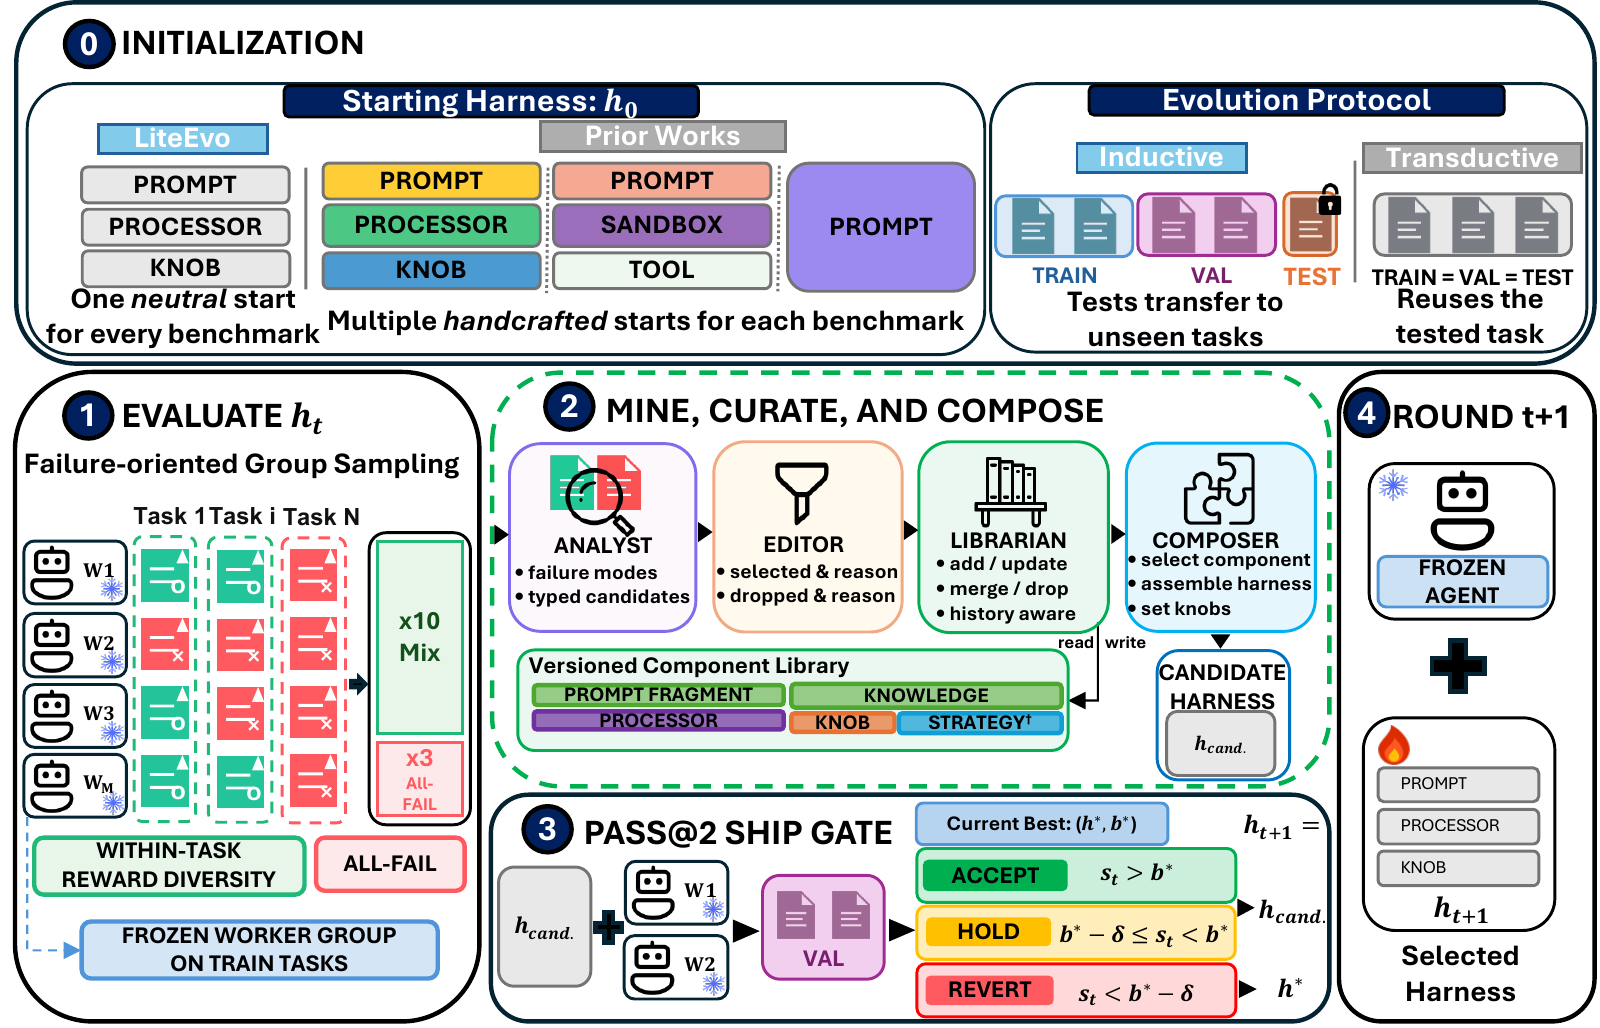
전체 구조: Figure 2 — LiteEvo overview.
무엇을 고정하고, 무엇을 바꾸나? (§2, App. B.1–B.4)
harness를 h = (p, Φ, κ)로 정의한다.
| 부분 | 바꿀 수 있는 것 | 구체적인 예 |
|---|---|---|
p: system prompt | 지시문, worked example, 환경에서 발견한 사실 | API spec을 먼저 확인하는 예제, 로그인 순서 |
Φ: processors | 정해진 hook에서 실행하는 짧은 Python 코드 | 반복 action 경고, 추출된 action 교정, observation 재작성 |
κ: runner knobs | 아래의 다섯 실행 설정 | 남은 turn 수 표시 |
다섯 knob는 reply protocol, available actions 표시, observation 길이 제한, action tag가 없을 때 마지막 줄을 action으로 쓰는 fallback, 남은 turn 수 표시다(Table 7). 모델 가중치, decoding, 환경, benchmark별 turn cap은 evolution 중 바꾸지 않는다.
neutral harness는 episode와 action tag를 설명하는 788-character prompt, processor 없음, 기본 knob로 시작한다. code action 환경에서는 multi-line block을 허용하도록 문구 세 곳을 바꿔 977 characters가 된다. 따라서 같은 출발 원칙을 쓰되 action interface까지 문자 단위로 동일한 것은 아니다(App. B.1).
성공과 실패를 같은 과제 안에서 비교한다 (§3.2, App. B.6)
각 train task를 M명의 frozen worker가 한 번씩 풀고, 그 M개 trajectory를 하나의 group으로 묶는다. analyst는 모든 task를 읽는 대신 다음을 본다.
- mixed group 10개: 성공과 실패가 섞인 task 중 평균 partial credit이 높은 것. 같은 문제에서 무엇이 성공을 갈랐는지 비교한다.
- all-fail group 3개: 전부 실패한 task 중 평균 partial credit이 낮은 것. 현재 harness로 풀지 못하는 실패를 탐색한다.
기본 M=4이므로 13개 group은 52개 trajectory다. mixed group이 부족하면 partial credit이 높은 all-fail group으로 보충한다. SWE-bench Verified는 M=2, mixed 5개 + all-fail 2개를 쓴다. trajectory의 긴 action·observation은 잘라서 전달하므로 모든 token을 그대로 읽는 방식은 아니다(App. B.6, Table 10).
네 meta-agent가 실패를 실행 가능한 component로 만든다 (§3.3)
| 역할 | 하는 일 | 검증·기억 장치 |
|---|---|---|
| Analyst | group 내부를 먼저 비교한 뒤 공통 failure mode와 해결 component 제안 | 실패 비중·근거·mechanism을 제시 |
| Editor | 중복·충돌을 정리하고 후보를 선택 | 이전 round journal 참고, processor compile·replay·출력 review |
| Librarian | component를 add/update/merge/drop하고 version 보관 | compile·knob parsing·benchmark identity filter |
| Composer | library에서 component를 골라 새 harness 조립 | best harness, journal, 실패 발췌, 사용 통계를 참고 |
library에는 prompt fragment, knowledge, processor, knob, strategy의 다섯 kind가 있다. 앞의 네 가지는 harness 구성에 쓰이고, strategy는 composer만 읽는 조립 지침이다. 처음에는 사람이 쓴 generic strategy 세 개만 들어 있다. composer는 이전 prompt를 계속 덧고치는 대신 매 round library에서 새로 조립한다(§3.3, App. B.4–B.5).
processor의 인터페이스는 advise(ctx) -> dict다. before_model에서 일회성 message를 주입하고, after_model에서 추출된 action을 바꾸거나, after_step에서 observation을 바꾼다. episode 안에서는 history와 scratchpad를 볼 수 있지만 모델의 reasoning은 보지 못한다. Editor는 processor를 round의 첫 24개 episode에 replay하고, 실행되지 않거나 오류가 나는 후보를 버린 뒤 최대 여섯 출력 예시를 review한다. 이는 새 환경 trajectory를 실행해 효과를 측정하는 것과는 구별된다(App. B.3, B.6).
후보를 되돌려도 library는 남는다 (§3.4, App. B.8)
validation pass@2가 best보다 높으면 accept하고 best를 갱신한다. 크게 떨어지면 revert해 best harness로 돌아가며, 허용 범위 안이면 hold해 후보에서 탐색을 계속하되 best는 바꾸지 않는다. 최종 출력은 마지막 후보가 아니라 best harness다.
실제 실행은 pipeline되어 있어 후보는 다음 round에서 평가된다. 그 round의 meta-agent가 이미 만든 다음 composition은 revert 때 버리지만, library 수정은 되돌리지 않는다. 최종 평가에는 best가 만들어진 시점의 library snapshot을 사용해 prompt를 byte 단위로 재구성한다(App. B.8).
benchmark-blind의 정확한 의미 (§3.1, App. B.6, B.9)
meta-agent 입력에서 task ID·split·URL을 지우고 benchmark 이름을 가린다. 지시문은 benchmark를 알아보더라도 사전 지식을 쓰지 말라고 요구한다. knowledge에는 관찰한 episode·turn·action을 연결하는 검사도 있다. 여러 episode를 비교해야만 얻는 규칙성에는 단일 turn citation 예외가 있다.
그러나 환경을 연결하는 adapter와 action 계약은 사람이 제공한다. WebShop에는 adapter가 action 문법도 보여 준다. meta-agent 지시문에는 이름을 제거한 개발 실험의 측정값도 들어 있고, 일부는 AppWorld에서 왔다고 명시한다(App. B.9). 이 점에 대한 해석은 아래 AI 해석에서 다룬다.
정의와 수식
pass@k는 “k번 중 한 번이라도 성공” (App. C.2, Eq. 3)
task τ에서 총 n회 시도 중 c_τ회 성공했다면 다음 estimator를 task 전체에 평균한다. \(\widehat{\mathrm{pass@}k}(h;\mathcal T) =\frac{1}{|\mathcal T|}\sum_{\tau\in\mathcal T} \left[1-\frac{\binom{n-c_\tau}{k}}{\binom nk}\right].\) 최종 test는 task당 두 번 시도하므로 n=k=2다. pass@1은 두 시도의 평균 성공률이고, pass@2는 둘 중 하나라도 성공한 task의 비율이다. 주표는 이 test를 세 번 실행한 평균이며, evolution을 세 번 다시 한 평균은 아니다. infrastructure fault로 유실된 episode는 집계에서 제외한다(App. C.2, App. E).
gate의 허용 폭 (Eq. 1, App. B.8)
후보 점수를 s_t, best 점수를 b*라 하면 기본 규칙은 다음과 같다. \(\begin{cases} \text{accept and update best}, & s_t>b^*,\\ \text{revert to best}, & s_t<b^*-\delta,\\ \text{hold candidate}, & \text{otherwise}. \end{cases}\) 점수를 % 단위로 쓰면 δ = max(min(7, b*/2), n_r, Δ*)이며 단위는 %p다. n_r은 worker 점수의 round 내부 spread로 추정한 noise band, Δ*는 best의 반복 측정 spread다. parse되지 않은 reply가 5%를 넘으면 accept하지 않고 hold한다. best를 revert 후 재측정한 경우 등 세부 우선순위는 App. B.8을 따른다.
실험과 핵심 결과
실험 설정
| 항목 | 설정 / 근거 |
|---|---|
| 주 agent | locally served Qwen3.5-9B, thinking mode, frozen (§4.1) |
| Meta-agent | Analyst: Claude Sonnet 5. Editor/Librarian/Composer: Claude Opus 4.6. 모두 high effort (App. B.5, Table 10) |
| Evolution | R=8: neutral round 0 + evolution 7회. 기본 M=4, SWE-bench Verified M=2 |
| 생성 예산 | reply당 4,096 token, context window 40,960, prompt budget 32,768 (Table 10) |
| 평가 | 주 결과는 반환 harness의 fresh test 3회 평균. Claude Code의 evolved cell은 단일 측정 (Tables 1, 3) |
| 비교 | task만 받는 Bare, Neutral, 저자들의 HarnessX 재현. 별도로 Bare + format 및 component ablation |
| 추가 backbone | Qwen3.5-4B, Claude Code + Sonnet 4.6 low effort. Claude Code 자체 tools는 꺼 둠 (Table 3, App. D.1) |
task split과 turn cap (Table 11, App. C.1):
| Benchmark | Train | Val | Test | Turn cap |
|---|---|---|---|---|
| ALFWorld | 134 | 140 valid-seen | 134 valid-unseen | 20 |
| WebShop | 100 | 100 | 100 | 20 |
| AppWorld | 90 train | 57 dev | 168 test-normal | 40 |
| GAIA | — | — | 103 text-only validation questions | 20 |
| SWE-bench Verified | 55 | 55 | 55 | 200 |
Inductive는 세 집합을 task 수준에서 분리한다. WebShop은 product도 겹치지 않고, ALFWorld test는 train에 없는 room이다. Transductive는 test task를 train·val로도 쓴다. GAIA는 inductive 결과가 없다. SWE-bench Verified는 전체 benchmark가 아니라 repository·difficulty로 stratify한 subset이다(App. C.1).
Finding 1 — 낮은 초기 성능에서 출발해 HarnessX 재현을 따라잡는다 (Table 1)
모두 Qwen3.5-9B pass@2 (%)다. 비용 비교에 쓰는 열은 두 방법 모두 transductive다.
| Benchmark | LiteEvo Neutral | HarnessX evolved, transductive | LiteEvo evolved, transductive | LiteEvo evolved, inductive |
|---|---|---|---|---|
| ALFWorld | 60.9 | 92.3 | 96.3 | 94.8 |
| WebShop | 10.0 | 60.7 | 62.7 | 70.0 |
| AppWorld | 0.0 | 62.3 | 67.7 | 65.5 |
| GAIA | 48.5 | 64.4 | 65.2 | — |
| SWE-bench Verified | 52.7 | 57.0 | 63.2 | 66.7 |
다섯 benchmark의 transductive 평균은 LiteEvo 71.0, HarnessX 재현 67.3이다. 특히 AppWorld는 HarnessX의 handcrafted seed가 이미 48.6인데도, LiteEvo는 0.0에서 시작해 67.7에 도달한다.
단, Neutral 대비 개선량이 항상 가장 좋은 간단한 baseline 대비 개선량은 아니다. WebShop은 Bare가 24.0으로 Neutral 10.0보다 높다. SWE-bench Verified는 Bare + format만으로 61.2이므로, Full 63.2와의 차이는 2.0%p다(Table 2, §4.2).
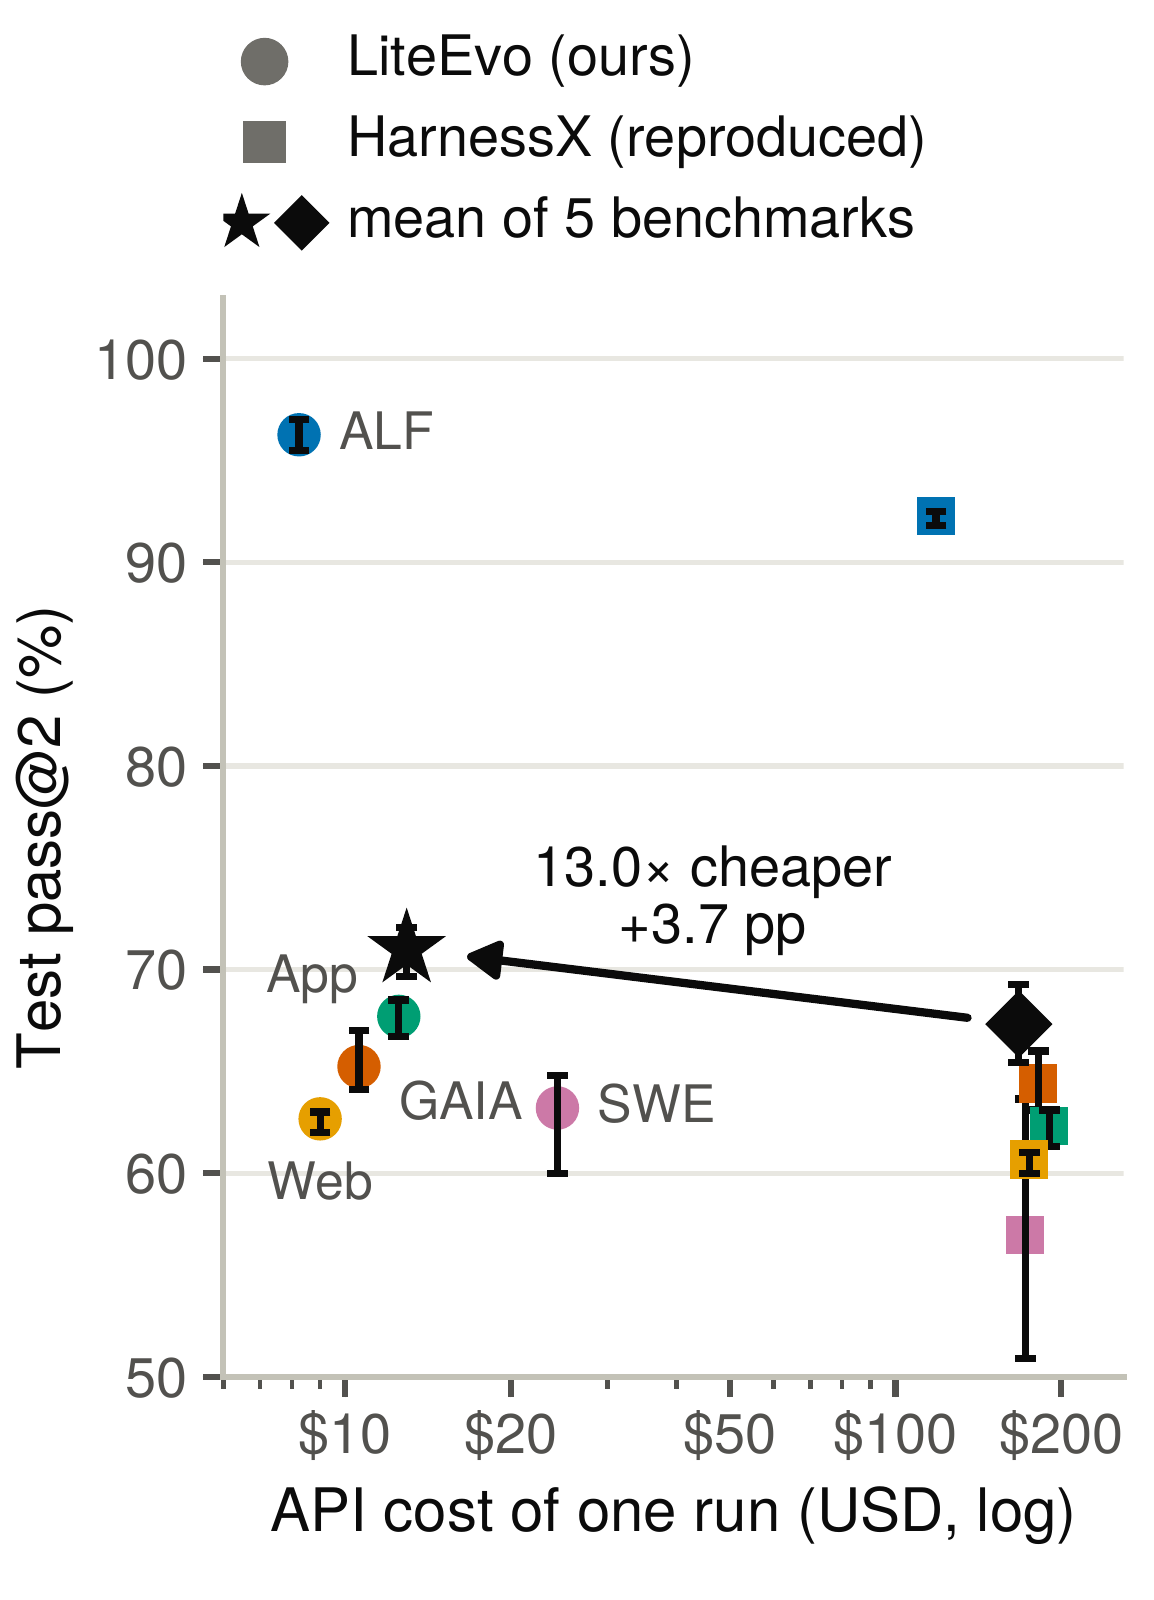
Finding 2 — 약 13배 차이는 optimizer API 비용에서 나온다 (§3.5, §4.2, App. C.3)
| Benchmark | HarnessX API cost ($) | LiteEvo API cost ($) |
|---|---|---|
| ALFWorld | 118.47 | 8.24 |
| WebShop | 175.11 | 9.00 |
| AppWorld | 190.32 | 12.51 |
| GAIA | 181.89 | 10.59 |
| SWE-bench Verified | 172.22 | 24.30 |
위 transductive run들의 평균 비용 비율이 13.0배다. 이유는 매 round 약 다섯 번의 tool-free 호출만 하고, 긴 trajectory는 상대적으로 저렴한 analyst가 한 번 읽으며, 나머지는 짧은 구조화 결과와 library를 받기 때문이다. HarnessX 재현은 round당 65–130회의 Opus 호출과 3.3–5.6M input token을 쓰고, LiteEvo는 약 다섯 호출과 0.12–0.54M을 쓴다. 이 token 분석은 기록이 남은 네 benchmark 기준이다(App. C.3).
비용은 h1–h7을 만드는 meta-agent token만 센다. 로컬 GPU worker의 rollout, test, wall-clock 총비용은 포함하지 않는다. 당시 논문이 사용한 input/output 단가는 Opus 4.6이 $5/$25, Sonnet 5가 introductory $2/$10 per million token이다. caching 여부와 무관하게 input을 정가로 환산했고, 기록이 유실된 일부 run은 남아 있는 같은 benchmark 기록의 비율과 7/8 보정을 이용했다. 현재 가격을 조사한 값이 아니다(App. C.3).
비용·성능 그림: Figure 1(a).
Finding 3 — 같은 benchmark의 unseen task에는 전이되지만, library 자체의 범용 전이는 약하다 (§4.2, App. D.2, D.4)
Inductive 성능은 ALFWorld 94.8, AppWorld 65.5로 각각 transductive보다 1.5·2.2%p 낮다. WebShop 70.0, SWE-bench Verified 66.7은 transductive 62.7·63.2보다 높다(Table 1). 이는 독립 evolution 여러 회의 통계적 우열을 뜻하지는 않는다(App. E).
더 어려운 AppWorld test-challenge 417개 task에서는 train에 없던 app이 필요하다. Neutral 0.0에서 LiteEvo inductive 48.6, transductive 49.2에 도달한다. 다만 HarnessX 재현은 50.5로 더 높다(Table 14).
반면 AppWorld component를 빼고 다른 네 benchmark에서 만든 library만 사용하면, 세 번의 draw 전체 2,502 episode 중 성공 1회다. 이것은 pass@2 48.6과 같은 지표가 아니라 episode 성공 횟수다. 저자들은 환경 고유의 API 이름·action으로 쓰인 worked example이 library의 주요 가치이며, 관찰된 전이 종류는 loop-breaking processor였다고 설명한다. 같은 절차를 새 환경에 다시 적용하는 것과 기존 library를 그대로 가져가는 것을 구분한다(App. D.4).
Finding 4 — prompt와 processor의 중요도는 환경마다 다르다 (Table 2)
아래 +Prompt, +Processor는 각각 Bare + format에 해당 부분만 더한 조건이다. 수치는 pass@2 (%)다.
| Harness | ALFWorld | WebShop | AppWorld | GAIA | SWE-bench Verified |
|---|---|---|---|---|---|
| Bare + format | 56.7 | 13.8 | 0.0 | 44.3 | 61.2 |
| +Processor | 57.7 | 53.0 | 0.0 | 59.2 | 63.1 |
| +Prompt | 95.5 | 59.0 | 63.1 | 49.5 | 58.2 |
| Full | 96.3 | 62.7 | 67.7 | 65.2 | 63.2 |
ALFWorld·AppWorld는 prompt만으로 Full에 가깝고, GAIA·SWE-bench Verified는 processor 쪽이 더 강하다. SWE-bench Verified에서는 prompt만 더하면 baseline보다 낮아진다. 저자들도 두 부분이 함께 evolution된 뒤 분리한 실험이므로 독립적인 인과 기여를 분리한 것은 아니라고 단서를 둔다(§4.3).
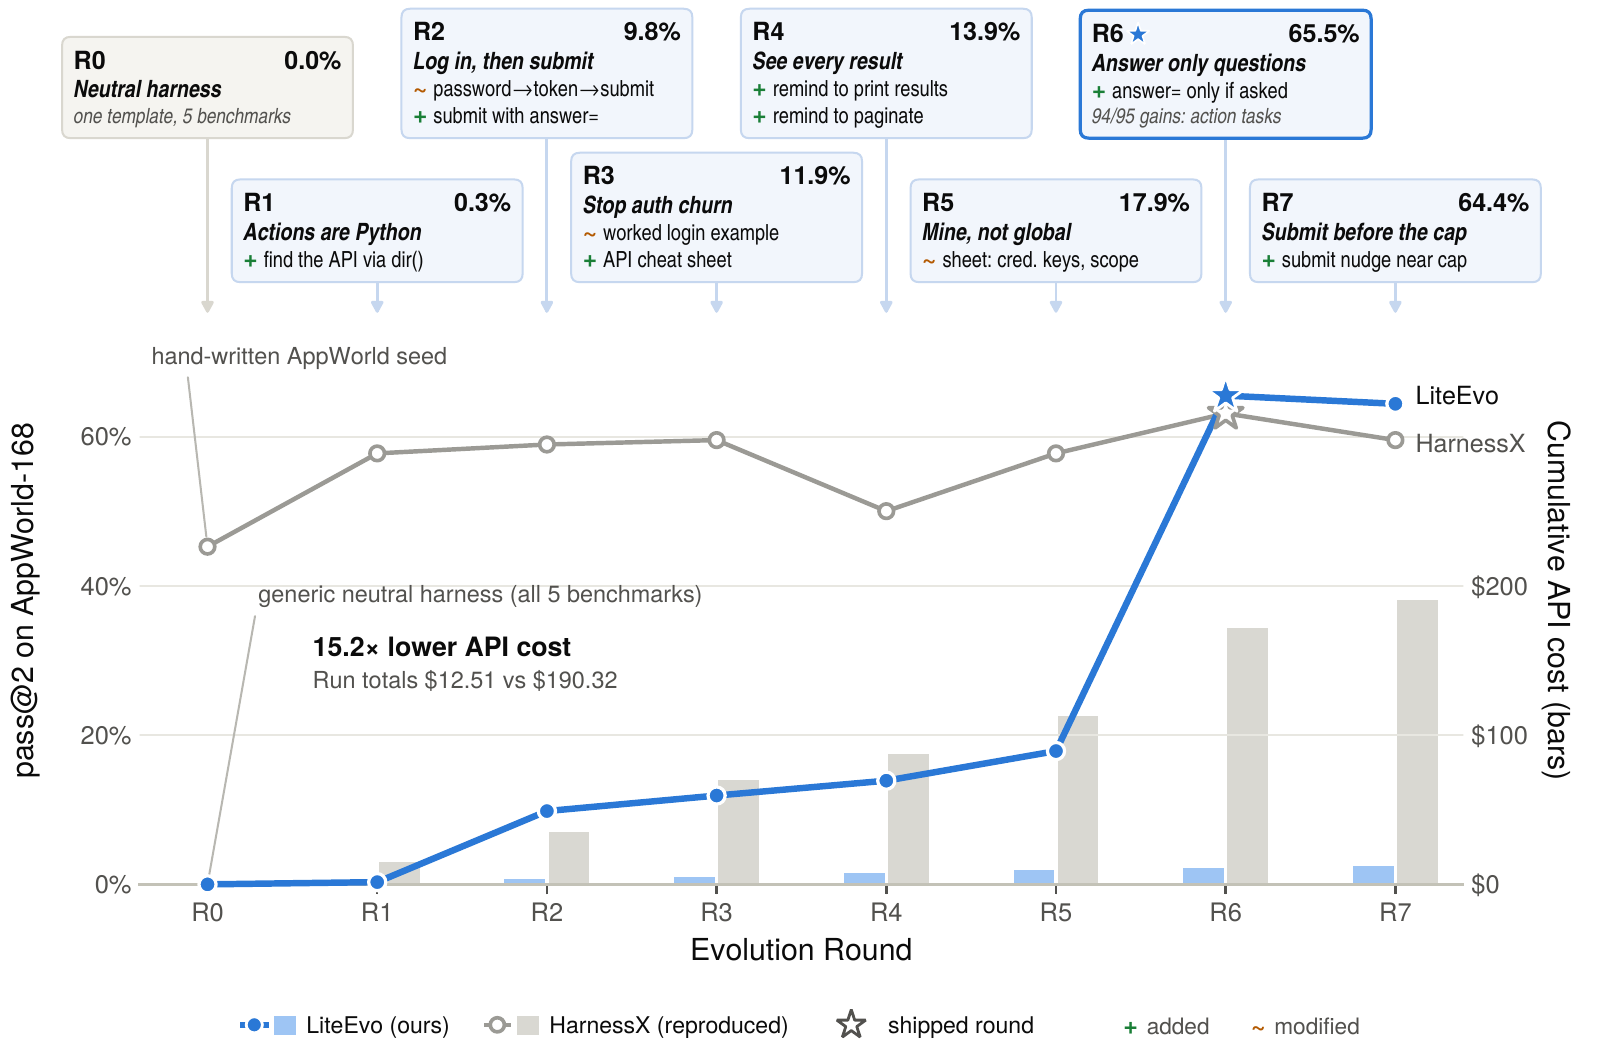
AppWorld evolution의 구체적인 예는 Figure 13 — round별 실패 수정에 있다. Python action 탐색, 로그인 예제, API 결과 출력·pagination, credential 범위 수정 등이 쌓인다. round 6에는 질문 과제가 아닐 때 불필요한 answer=를 넣지 않도록 수정한다. 그림의 선은 loop 내부 추정치이고 Table 1의 67.7은 반환 harness의 fresh test 평균이므로 동일한 수치로 취급하지 않는다(App. D.3, Figure 13 caption).
Finding 5 — group 선택은 특히 AppWorld에서 중요하다 (App. D.5–D.6, Tables 15–16)
| Analyst가 읽는 group | ALFWorld | WebShop | AppWorld | GAIA | SWE-bench Verified |
|---|---|---|---|---|---|
| Mixed + all-fail (default) | 96.3 | 62.7 | 67.7 | 65.2 | 63.2 |
| All-success 위주 | 86.6 | 62.0 | 16.9 | 64.7 | 63.0 |
| All-fail 위주 | 89.3 | 60.7 | 12.3 | 57.0 | 61.8 |
| Random | 94.3 | 62.0 | 57.9 | 59.2 | 60.0 |
동일 개수의 group을 읽으며, 해당 종류가 부족하면 다른 group에서 채운다. AppWorld에서는 default가 크게 앞서지만 SWE-bench Verified의 all-success 대비 차이는 0.2%p다. 또한 analyst를 worker마다 따로 두는 방법과 비교하면 group analyst 한 명의 비용은 9개 조건 모두에서 더 낮아 상대 비용 36–75%다. 성능은 5개 조건에서 높고, 2개는 0.2%p 이내이며, ALFWorld의 두 조건에서는 낮다(App. D.5–D.6).
Finding 6 — 작은 모델 밖에서도 작동하나, 비교 조건과 반복 수를 봐야 한다 (Table 3, App. D.1)
Claude Code + Sonnet 4.6에서도 9개 benchmark·regime 조건 모두 pass@2가 오른다. AppWorld는 0.0에서 transductive 66.1, inductive 71.4가 되며, 다른 benchmark의 개선은 1.2–7.5%p다. 이 실험은 low effort, 자체 tools off, 각 evolved cell 단일 측정이다. 일반적인 기본 설정의 Claude Code 사용 전체를 대표하는 비교는 아니다(Table 3).
Qwen3.5-4B도 모든 조건에서 Neutral 대비 6.7–49.8%p 개선된다. 예를 들어 AppWorld inductive는 0.0→33.7, WebShop inductive는 15.2→62.3이다(Table 13).
Finding 7 — library는 주로 커지며, 모든 설계 선택의 필요성이 분리 검증된 것은 아니다
- Library 관리: 다섯 transductive run 합계 add 85, update 25, merge 7, drop 2. 평균 크기는 첫 round 후 3.8개에서 마지막 16.4개로, 마지막 선택 비율은 75.6%다. 적극적인 pruning의 효과는 시험하지 않았다(Table 4, App. E).
- Neutral vs seed: LiteEvo를 handcrafted seed에서 시작하면 AppWorld 64.9, GAIA 59.9로 Neutral의 67.7·65.2보다 낮다. 각 arm 한 번이므로 seed가 해롭다는 결론은 내리지 않는다(Table 5).
- Compose vs Refine: 매번 library에서 새로 조립하는 Compose는 이전 harness를 수정하는 Refine보다 평균이 높다. Transductive 68.1 vs 64.3, inductive 72.4 vs 65.8이다. 단, 이 비교는 default group analyst가 아니라 worker별 analyst를 사용했다(Table 20, App. D.10).
- Explicit cross-episode memory: 수작업 memory를 매 composition에 강제로 넣는 변형은 낮게 나왔다. 그러나 단일 측정이며 AppWorld는 code version·load까지 달라 통제된 memory 유무 비교가 아니다(App. D.8).
- Editor/Librarian 통합: 합친 변형이 낮게 나오지만 다른 설정도 달랐고, 별도로 통제한 WebShop pilot은 차이가 없었다. 네 역할의 분리가 필수라고 확정하는 근거로 쓰기 어렵다(App. D.9).
한계와 해석
저자들이 밝힌 한계
- Evolution 반복이 없다. 각 결과는 evolution run 한 번에서 나온다. test를 세 번 반복해도 loop 자체가 다른 library를 만들 변동성은 측정되지 않는다(App. E).
- GAIA 정답 사본 노출이 남는다. 알려진 mirror와 answer record를 차단했지만, loop observation scan에서 먼저 정답 사본을 본 사례가 30개 발견됐다. 반환 harness를 실행한 round에서는 그런 episode 중 10개가 성공했다. 이를 실패로 처리하면 그 round pass@2는 측정값 64.6에서 62.9 이상으로 남는다. 이 bound는 loop episode만 대상으로 하며, Table 1의 fresh test 평균 65.2를 보정한 값이 아니다. 반환 processor 하나는 dataset mirror 탐색도 권한다(App. C.4, E).
- Library의 unseen-benchmark 전이는 성공하지 못했다. benchmark마다 새 library를 맞추며, AppWorld test-challenge에서는 HarnessX 재현보다 낮다(App. D.2, D.4, E).
- HarnessX는 저자들의 재현이다. 공개 코드에 원 논문의 four-stage engine이 없어 single-agent evolver를 썼다. ALFWorld·WebShop·AppWorld seed/recipe는 저자들이 작성했고, 네 benchmark에서 meta-agent thinking을 껐다. SWE-bench 쪽은 HarnessX agent만 test 이름을 보고, ALFWorld seed coverage는 134개 중 88개다. 차이가 양쪽 모두에 유리·불리하게 작용할 수 있다(App. C.5, Table 12).
- 범위와 남은 작업: 더 적극적인 library 관리, 더 어려운 agentic benchmark, flagship model을 agent로 쓰는 실험, meta-agent 지시문 최적화, coding-agent skill 패키징, fine-tuning·RL 결합은 남아 있다. Sonnet 4.6 실험은 있지만 flagship agent를 쓴 실험은 하지 않았다고 저자들은 적는다(App. E).
AI의 해석
아래는 논문의 주장이 아니라 정리자(Codex)의 해석이다. 근거 위치와 그로부터의 판단을 구분한다.
- 주요 기여는 benchmark마다 실행 지식을 발견하는 절차에 있다. 서로 다른 환경에 같은 loop를 적용할 수 있다는 결과는 의미가 있다. 반면 library 직접 전이의 거의 0에 가까운 결과(App. D.4)를 고려하면, “일반적인 agent 지식을 축적했다”는 해석보다 환경별 성공 절차를 자동으로 찾아 재사용한다는 해석이 근거에 더 가깝다.
- Benchmark-blind를 development-blind로 읽으면 안 된다. 이름·ID를 가리는 filter는 명시적 identity 누출을 줄인다. 하지만 App. B.7 지시문에는 과거 실험의 worked-example 효과와 실패 양상이 구체적으로 들어 있고, App. B.9는 일부 AppWorld 유래임을 인정한다. 사전학습 지식의 사용을 금지하는 문구도 그 사용이 실제로 없었다는 보장은 아니다. 설계가 완전히 잠긴 뒤 처음 만나는 환경에서 반복 검증해야 더 강한 범용성 주장을 할 수 있다.
- SWE-bench inductive도 연구 과정 전체가 test-blind였다는 뜻은 아니다. App. C.2는 이전 SWE-bench run의 test episode를 살펴본 뒤 analyst 입력에 “파일을 전혀 수정하지 않은 episode 비율”을 추가했다고 밝힌다. 현재 loop의 train/val/test task 분리와, 연구자가 설정을 선택하는 과정의 test 독립성을 구분할 필요가 있다.
- 개선량은 baseline의 interface 지원에 민감하다. AppWorld의 0점 출발은 Python action과 종료 API조차 알려 주지 않는 조건이다(App. C.1). 그 간극을 자동으로 메운 것은 유용하지만, 모든 증가분을 고차 추론 능력 향상으로 해석하기는 어렵다. SWE-bench에서 format hint만으로 61.2가 되는 결과(Table 2)는 간단한 interface 지원 baseline을 함께 보고해야 할 이유다. 남은 turn 수를 알려 주는 knob도 기본적으로 숨겨졌던 정보를 추가한다(App. B.3).
- “13배”를 시스템 전체 비용이나 속도로 확대하면 안 된다. API token 계수는 비교 가능하게 정리되어 있지만, 가격이 다른 analyst 모델도 비용 차이에 기여하고 rollout GPU 비용은 빠져 있다(App. C.3). inductive 설정은 validation rollout도 필요하므로 총 episode 수·GPU 시간·wall-clock까지 넣으면 비용 비율이 달라질 수 있다. 현재 자료만으로 그 방향이나 크기는 계산할 수 없다.
- Gate는 작은 개선의 통계적 유의성을 보장하지 않는다. noise margin
δ는 주로 크게 나빠진 후보를 되돌리는 데 쓰이고, accept 자체는s_t > b*면 된다(Eq. 1). validation을 여러 round 재사용하면서 작은 우연한 상승을 best로 잡을 가능성이 있다. 독립 evolution 반복과 별도 final test는 이런 선택 효과를 평가하는 데 필요하다. hold와 library 보존은 나쁜 중간 후보를 거쳐 탐색하도록 허용하는 설계로 읽힌다. - Component 단위 credit assignment는 아직 약하다. library 통계는 함께 배치된 bundle의 점수이고, 지시문도 이를 co-occurrence로 경고한다(App. B.7). prompt/processor 분리 실험은 있지만 함께 evolution한 뒤의 분리이며, merge·memory 변형도 통제가 부족하다. 따라서 각 역할·library·gate가 성능을 얼마나 독립적으로 만드는지는 별도 ablation이 필요하다.
- 지시문의 정확한 재현에는 확인할 부분이 있다. App. B.5의 수작업 strategy는 reply format을 runner에 맡기라고 하지만, App. B.7의 composer 지시문(Figure 12)은
base_system에 format 문단을 반드시 쓰라고 한다. 공개된 지시문과 조립 규칙 사이의 긴장이므로 구현에서의 실제 우선순위를 확인할 필요가 있다. 이 불일치만으로 결과의 오류를 단정하지는 않는다.
더 생각해볼 질문
아래는 AI가 정리 과정에서 제안한 후속 질문입니다. 본인이 직접 작성한 의견이나 논문에서 검증한 결과로 표시하지 않습니다.
💭 연구 아이디어 — 기존 아카이브의 주제와 연결한 후속 질문이며, 이 논문이 검증한 결과가 아니다.
- Agent Plasticity: best 성능뿐 아니라 경험량에 따른 개선 속도를 측정하면 어떨까? worker episode·token·GPU 시간당 개선을 함께 그리면 harness evolution의 sample efficiency를 비교할 수 있을까?
- Environmental Novelty: 로그인 API·action 문법이 바뀌어 기존 worked example이 실패할 때, library를 버리는 것과 모순되는 component만 고치는 것 중 어느 쪽이 빨리 회복할까? stale component의 탐지 지연은 어떻게 측정할까?
- Generalization Tax / LoGRA: RL로 weights를 바꾸는 방법과 harness만 바꾸는 방법을 같은 rollout 예산에서 비교하면 어떤 task family에 서로 다른 이득이 있을까? 둘을 결합하면 새 task에서의 개선과 기존 task의 회귀를 함께 줄일 수 있을까?
- MemCo: 환경 고유 worked example을 role 수준의 template와 현재 환경의 binding으로 분리하면 다른 benchmark로의 library 전이가 좋아질까? API 이름을 지우면서 실행 가능성을 보존하는 것이 핵심 실험이 될 수 있다.
- SCDP: “trajectory를 더 수집할지, analyst를 부를지, 기존 component를 시험할지”를 비용이 있는 decision으로 모델링해 고정 8-round loop를 adaptive하게 바꿀 수 있을까?
- 최소 비교 실험: 같은 train trajectory·같은 meta-agent 모델·같은 총 예산으로 단일 prompt optimizer와 typed library를 비교하면, component 분리와 재조립 자체의 이득은 얼마나 남을까?
참고자료
정리 범위와 근거 메모
읽은 범위: v1 LaTeX 본문과 부록 A–E, 표, PDF로 실린 meta-agent 지시문 및 방법·evolution 그림. 근거는 원문 PDF, HTML, LaTeX main.tex. 아래의 논문 내용과 아래 AI 해석·후속 질문의 정리자 해석을 구분한다.
용어 정리
| 용어 | 이 논문에서의 뜻 |
|---|---|
| Harness | frozen model과 환경 사이에서 바꿀 수 있는 system prompt·processors·runner knobs |
| Frozen agent | evolution 동안 가중치와 decoding 설정을 바꾸지 않는 task 수행 모델 |
| Meta-agent | offline에서 trajectory를 분석하고 harness를 만드는 LLM 역할. test 중 agent와 협업하지 않음 |
| Mixed group | 같은 task의 여러 rollout 중 성공·실패가 섞인 집합 |
| Worked example | 설명만 하는 대신 action 문법과 실행 절차를 실제 예제로 보여 주는 prompt fragment |
| Processor | 정해진 hook에서 message·action·observation을 가공하는 짧은 코드 |
| Knowledge component | trajectory에서 관찰한 환경 사실을 보관해 prompt에 넣는 component |
| Strategy component | agent에게 전달되지 않고 composer의 조립 결정을 돕는 지침 |
| Versioned library | round별 수정과 snapshot을 남기는 component 저장소. revert해도 수정은 남음 |
| Transductive | evolution·선택·최종 평가에 같은 task 집합을 사용 |
| Inductive | evolution train, 선택 val, 평가 test의 task를 분리 |
| pass@2 | 독립적인 두 번의 시도 중 한 번이라도 성공할 확률의 task 평균 |
| pp / %p | 두 백분율의 차이. 상대 개선율(%)과 구분 |
주요 수치의 원자료: Table 1 소스, Table 2 소스, 부록 소스. 수치는 표·본문의 명시값을 사용했고, 그래프에서 눈대중으로 추정한 값은 사용하지 않았다.