LoGRA: Scaling LLM Reinforcement Learning with Low-Rank Gradient Sketches ↗
Shaokun Zhang, Yifan Zhang, Jian Hu, Yueying Li, Hao Zhang, Binfeng Xu, Jan Kautz, Yi Dong
arXiv preprint (2026-10-05, NVIDIA tech report 양식)
- 문제: RL 학습의 gradient와 optimizer state가 추론에 필요한 weights보다 큰 메모리 부담을 만들 수 있다.
- 방법: gradient sketch를 바로 누적하고 RowAdam 및 predicted-KL step control로 원래 weights를 갱신한다.
- 결과: 메모리 감소와 큰 모델의 학습 가능성을 보이지만, 모든 baseline에 대해 정확도·속도 우위를 뜻하지는 않는다.
문제와 배경
배경과 읽는 관점
LLM을 추론할 수 있는 메모리가 있다고 해서 같은 장비로 RL 학습도 할 수 있는 것은 아니다. 학습 중에는 weights 외에 gradient와 optimizer state를 저장해야 하고, 이 추가 상태가 모델 크기와 함께 커진다. LoGRA는 학습 상태를 어떻게 줄이면서도 실제 policy update를 안정적으로 적용할 것인지 다룬다.
기존 접근과 연구 질문
- RL은 LLM 발전의 핵심 동력이지만 메모리 요구량이 진입 장벽이다. 부담은 파라미터에서 끝나지 않는다. gradient와 optimizer state가 weight의 몇 배를 차지한다.
- 기존 해법은 세 갈래다.
- 시스템 레벨: FSDP sharding, gradient checkpointing, CPU offloading.
- PEFT: LoRA. pretrained weight를 freeze하고 작은 adapter만 학습한다.
- Gradient compression: GaLore, Flora. 원래 weight는 학습 가능하게 두고, gradient와 optimizer state만 압축해서 표현한다.
- LoGRA는 세 번째 계열이다. 저자들의 직관은 이렇다. binary outcome reward에서는 response 하나당 정답 여부라는 스칼라 하나만 피드백으로 들어온다. 그러니 그 학습 신호는 full gradient만큼의 정보량이 필요 없을 것이다(Schulman et al. 2025, “LoRA without regret”를 인용, §1).
- 기존 gradient compression과 다른 점은 RL의 training ↔ generation 루프 전체를 겨냥한다는 것이다(§Related Works).
- full gradient를 아예 만들지 않고 backprop 중에 sketch를 곧바로 누적한다.
- 같은 압축 표현으로 rollout policy도 동기화한다.
읽을 때는 모델 weights의 저랭크화, gradient를 저장하는 방식의 압축, optimizer 통계의 단순화, update 크기 제어를 구분해야 한다. 이 논문은 gradient sketch와 KL 기반 step control을 결합하며, 압축률만이 아니라 학습 안정성과 실행 비용도 함께 평가한다.
핵심 아이디어
먼저 직관으로 이해하기
거대한 gradient 행렬을 끝까지 저장한 뒤 압축하는 대신, backprop 과정에서 저랭크 projection으로 만든 sketch를 바로 누적한다. 작은 공간에서 update 방향을 계산하고 원래 weights에 merge하되, 정책이 한 번에 너무 많이 변하지 않도록 적용 전의 KL 근사로 step 크기를 조절한다.
Low-rank gradient sketch
weight 행렬 $W\in\mathbb R^{d\times k}$와 그 gradient $G=\nabla_W\mathcal L$에 대해 다음과 같이 한다.
| 단계 | 식 | 저장량 |
|---|---|---|
| 랜덤 projection 샘플 | $A\in\mathbb R^{r\times k}$, 원소는 $\pm 1/\sqrt r$ (Rademacher). 학습하지 않는다. | seed만 |
| Sketch 누적 | $S = GA^\top \in \mathbb R^{d\times r}$ | $dk \to dr$ |
| (선택) sketch optimizer | $U = S$ (SGD) 또는 RowAdam | RowAdam은 행마다 값 1개 → $d$개 |
| Update | $W \leftarrow W - \alpha\eta\, UA$ | rank ≤ r인 update를 weight에 직접 merge |
- full gradient를 만들지 않는다. $G = \delta^\top X$ 꼴이므로 입력 $X$를 먼저 $A^\top$로 projection한 뒤 backward derivative와 곱한다. 그러면 microbatch마다 $S$를 fp32로 바로 누적할 수 있다. forward 계산은 그대로다(§2.1).
- projection refresh: $A$를 매 step 새 seed로 다시 뽑는다. 그러면 각 update는 rank ≤ r이어도 누적된 변화는 rank r에 갇히지 않는다(Flora의 아이디어). adapter branch가 따로 남지 않는다.
- 적용 범위는 attention과 MLP projection 행렬뿐이다. 나머지 파라미터(embedding, norm 등)는 고정한다(§2.2).
- 예시: $d=k=4096$, $r=64$이면 fp32 gradient accumulator가 64 MiB에서 1 MiB로 줄어든다.
- 동기화: trainer는 $\alpha\eta U$($O(dr)$ 크기)와 $A$의 seed만 rollout 엔진에 보낸다. rollout 쪽은 seed로 $A$를 다시 만들어 같은 update를 적용한다(Algorithm 1).
Predicted-KL step control
parameter 공간에서는 작은 update라도 출력 분포를 크게 바꿀 수 있다. 그래서 TRPO처럼 정책 KL로 step 크기를 제한한다. 차이는 업데이트를 적용하기 전에 KL을 예측한다는 점이다.
- 현재 batch에서 response 몇 개를 골라 그 토큰 위치들(context 집합 $\mathcal P$)을 본다.
- 2차 Taylor 근사로 다음 관계를 얻는다(부록 A.1).
- $\dot z_v(s)$는 update 방향 $D$를 따라 logit이 변하는 속도(JVP)다. 모든 logit이 똑같이 움직이면 softmax가 변하지 않으므로, logit 변화량의 확률가중 분산이 곧 KL 곡률이 된다. dense gradient도, dense curvature 행렬도 필요 없다.
- step 크기는 다음과 같이 정한다.
예를 들어 예측 KL이 budget의 4배이면 update를 절반으로 줄인다.
- budget $\delta$는 상수로 두거나, cosine annealing으로 점점 줄인다(부록 D 식).
- Mismatch subtraction(부록 D): rollout 엔진과 trainer가 같은 weight에서도 log-prob이 조금씩 다르다. 이 차이 $\kappa_u$를 추정해 budget에서 뺀다: $\delta^{\text{eff}}=\max(\delta-\kappa, 0.5\delta)$. 저자들도 이것이 KL의 정확한 분해가 아니라 휴리스틱이라고 밝힌다.
- 27B 장기 실험에서는 효율 때문에 JVP 대신 실제 KL을 직접 계산하는 finite-difference probe를 썼다(§4.3).
RowAdam (부록 B)
메인 실험의 sketch optimizer다. Adam과는 다르다.
- per-parameter가 아니라 행(row) 단위 second moment만 둔다. 행렬 하나당 $d$개 값이다.
- first moment(momentum)가 없다. $\beta_2 = 0.95$.
- 행별로 스케일링한 뒤에는 원래 sketch의 Frobenius norm으로 다시 맞춘다. 즉 전체 크기는 바꾸지 않고 행 사이의 상대 기여만 조정한다.
- 행 통계는 projection을 refresh해도 유지된다.
실험과 핵심 결과
실험 설정
- 모델: Qwen2.5-Math-1.5B / 7B, Qwen3.8-27B
- 데이터: DAPO-Math-7.5K(DAPO-Math-17k에서 중복을 뺀 앞쪽 7,500개)로 학습, MATH-500으로 평가. 27B 장기 실험은 Reasoning-Gym Hard mixture(8개 task, train 38,948 / held-out 193)를 썼다.
- RL 알고리즘: 일부러 단순하게 갔다. PPO + verifiable reward, prompt당 response 1개, global running reward baseline. 방법 효과를 더 정교한 RL 알고리즘의 효과와 분리하려는 의도다(§4.1).
- 하드웨어: H100 80GB 8장짜리 노드 한 대. 학습 4장(FSDP) + generation 엔진 4장. BF16, activation checkpointing, CPU offloading 없음.
- 메인 비교(부록 D, Table 3):
| Dense | LoGRA | |
|---|---|---|
| Optimizer | Adam (β=(0.9, 0.95)) | RowAdam (no momentum) |
| Step-size | LR $10^{-6}\to10^{-7}$, warmup 9 + cosine | predicted-KL $2\times10^{-4}\to2\times10^{-5}$, cosine |
| Projection | – | rank 256 Rademacher, 매 update refresh |
| Mismatch subtraction | – | 사용 (budget floor 50%) |
| Seed | 1, 2, 42 | 1, 2, 42 |
- batch는 128 prompt × 1 response, context 4,096 토큰이다. 평가는 문제당 4개 샘플(T=0.7, top-p=0.7)로 하고, 2,000개 응답의 평균 정답률을 Pass@1로 쓴다.
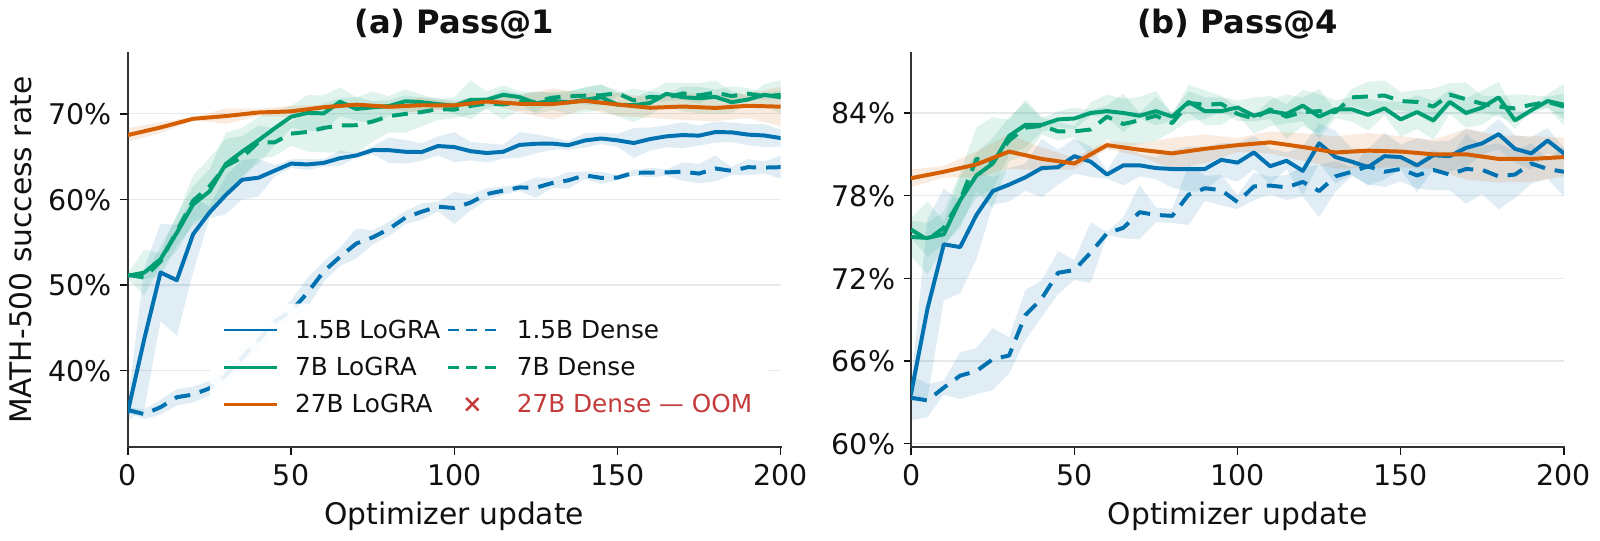
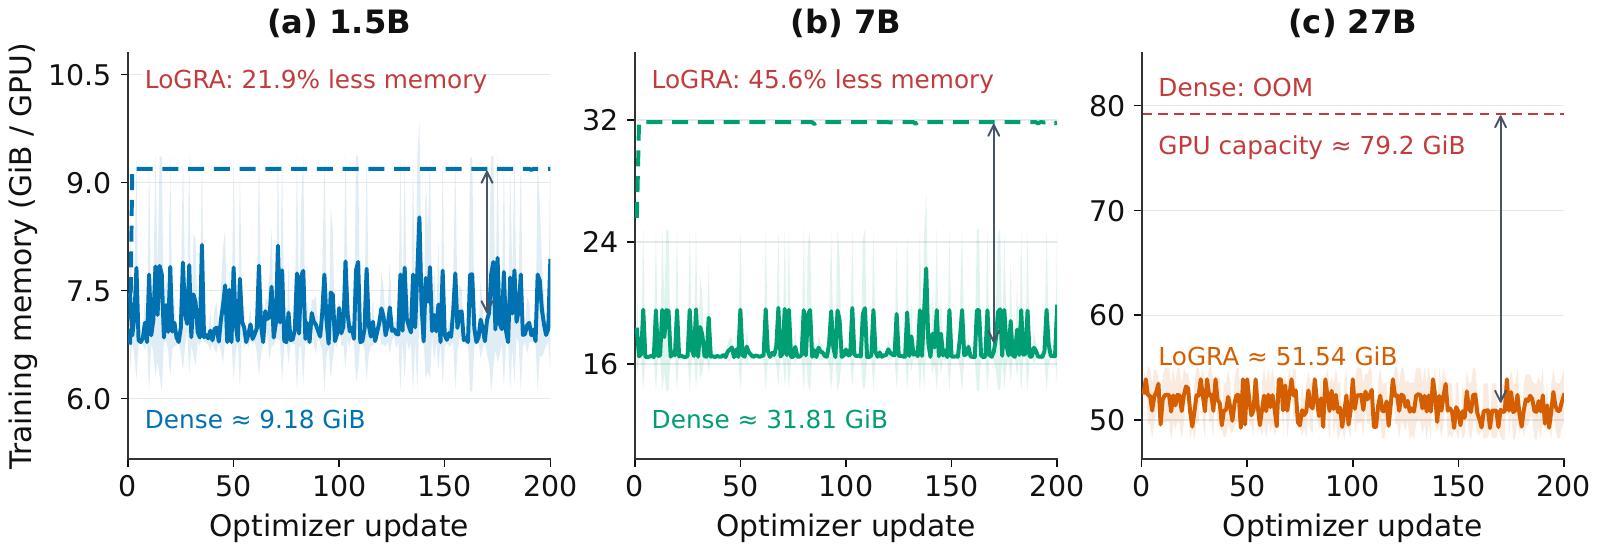
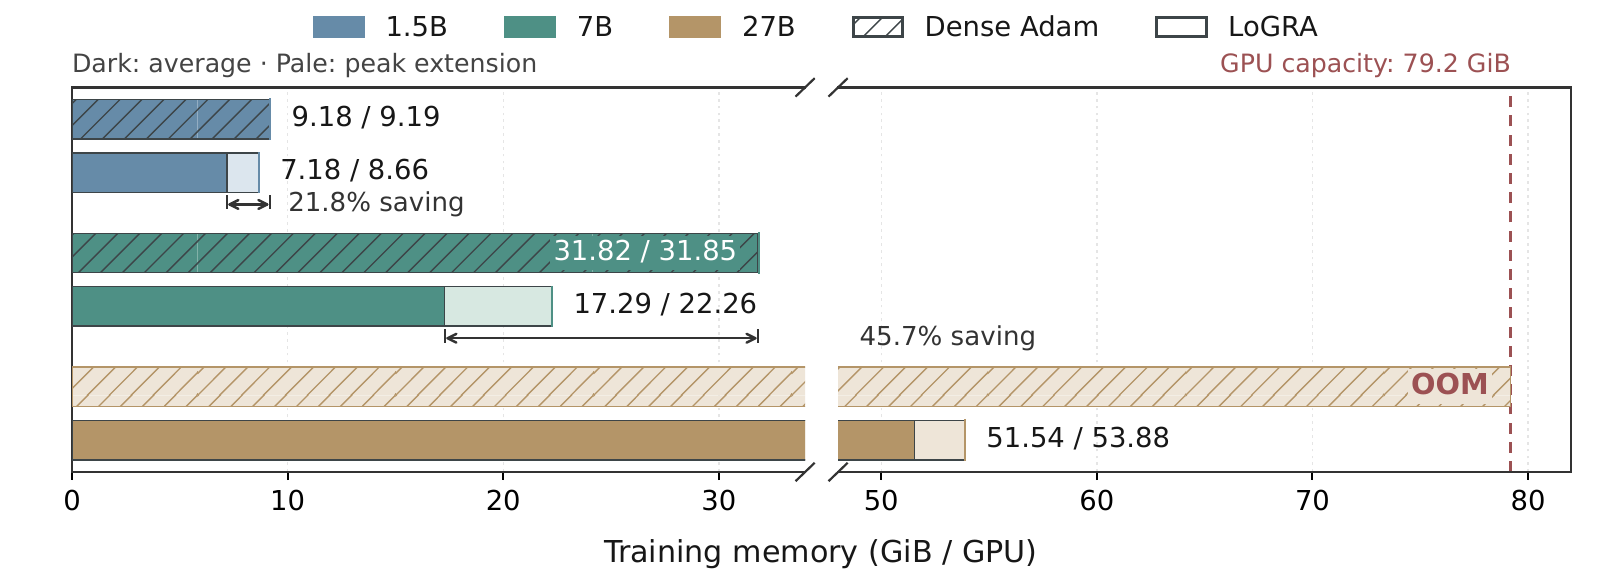
Finding 1. 메모리는 크게 줄고 정확도는 유지된다 (Table 1, Figure 2, Figure 3, Figure 1)
| Model | Method | Avg mem (GiB/GPU) | Peak mem | Updates/h | Peak Pass@1 | Peak Pass@4 |
|---|---|---|---|---|---|---|
| 1.5B | Dense | 9.18 ± 0.00 | 9.19 ± 0.00 | 54.28 | 63.77 ± 1.35 | 80.33 ± 1.47 |
| 1.5B | LoGRA | 7.18 ± 0.10 | 8.66 ± 1.62 | 55.44 | 67.87 ± 1.23 | 82.47 ± 1.10 |
| 7B | Dense | 31.82 ± 0.00 | 31.85 ± 0.00 | 25.28 | 72.48 ± 0.35 | 85.33 ± 0.83 |
| 7B | LoGRA | 17.29 ± 0.34 | 22.26 ± 4.98 | 25.73 | 72.33 ± 1.33 | 85.13 ± 1.14 |
| 27B | Dense | OOM | ||||
| 27B | LoGRA | 51.54 ± 0.17 | 53.88 | 6.99 | 71.52 ± 0.94 | 81.87 ± 0.81 |
- 평균 메모리는 1.5B에서 21.8%, 7B에서 45.7% 줄었다. 27B Dense는 첫 Adam state를 할당하는 순간 OOM이 났다.
- 정확도: 7B에서는 사실상 동률이고, 1.5B에서는 LoGRA가 Pass@1 기준 약 4%p 높다.
- throughput은 비슷하다. 저자들도 시스템 측면의 주된 이득은 속도가 아니라 메모리와 27B 학습 가능성이라고 정리한다.
- 그림에서 읽은 값: Figure 2에서 1.5B Dense는 200 update 시점까지도 계속 오르는 중이다(~63%). 반면 LoGRA는 ~50 update 만에 ~64%에 도달한다. 27B는 시작점이 이미 ~67%이고, 200 update 동안 ~4%p 정도 오른다.
Finding 2. 27B를 노드 한 대에서 1,100+ step 학습한다 (§4.3, Figure 4)
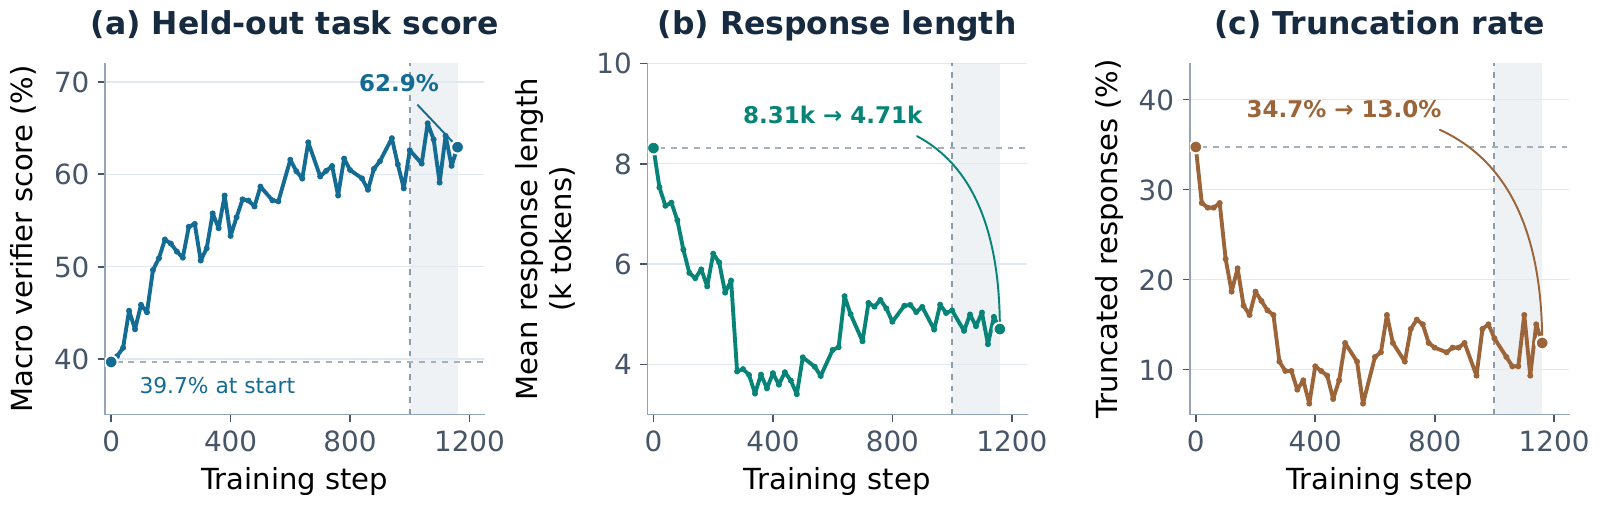
- Qwen3.8-27B를 Reasoning-Gym Hard로 학습했다. rank 256, SGD sketch, budget은 1,000 merge 동안 annealing한 뒤 고정했다. seed는 42 하나다.
- held-out macro score: 39.69% → 62.94%, 최고점은 step 1,060의 65.52%. 마지막 다섯 번의 평가는 59.11–64.16%로, 지속적인 collapse는 없었다.
- 평균 응답 길이는 8,312 → 4,705 토큰, truncation 비율(16,384 토큰 한도)은 34.72% → 12.95%로 줄었다. 응답 길이가 폭주하지 않았다.
Finding 3. rank가 가장 중요하고, refresh와 분포는 거의 상관없다 (§4.4.1, Figure 5)
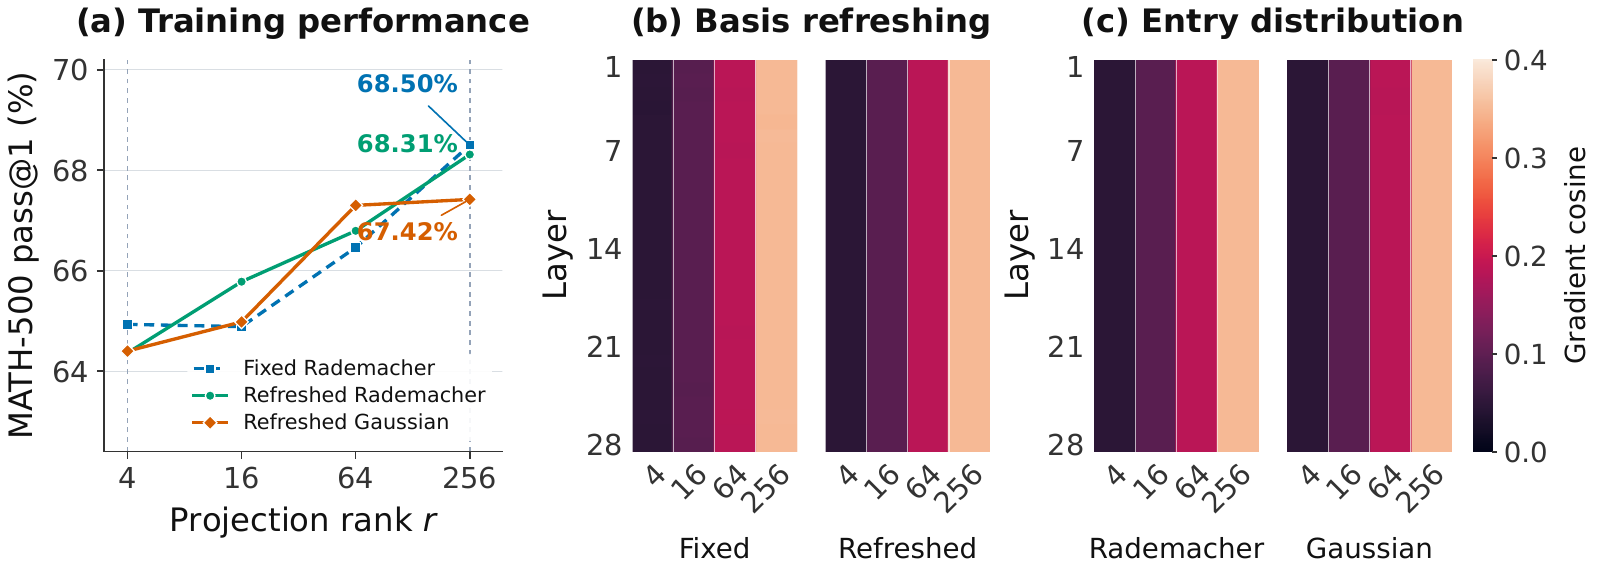
- 1.5B에서 $r\in{4,16,64,256}$을 비교했다. rank를 4에서 256으로 올리면 pass@1이 3.02–3.95%p 오른다.
- rank 256에서 fixed Rademacher / refreshed Rademacher / refreshed Gaussian은 각각 68.50 / 68.31 / 67.42%다. rank마다 순서가 바뀌므로, refresh의 일관된 이득은 없다. 저자들은 짧은 학습 구간에서는 고정된 부분공간으로도 충분하기 때문일 수 있다고 본다.
- Gradient reconstruction cosine $\cos(G, GA^\top A)$는 rank 4에서 ~0.046, rank 256에서 ~0.348이다. fixed와 refreshed의 차이는 최대 0.0014, Rademacher와 Gaussian의 차이는 최대 0.0008에 그친다.
- 즉 rank 256에서도 복원된 gradient와 실제 gradient의 cosine은 0.35 정도에 불과하다. 그런데도 학습 성능은 Dense와 비슷하다.
Finding 4. LoRA보다 메모리는 훨씬 적지만, 정확도와 속도에서 우위는 아니다 (§4.4.2, Table 2)
| (1.5B, rank 256, 300 step) | Avg mem | Peak mem | Pass@1 | Pass@4 | s/update |
|---|---|---|---|---|---|
| LoRA (AdamW, LR 2e-4) | 13.21 | 13.38 | 70.45 ± 3.09 | 81.40 ± 2.09 | 10.63 |
| LoGRA | 7.18 | 8.66 | 68.47 ± 0.95 | 81.80 ± 1.06 | 11.31 |
- 저자들도 이렇게 쓴다: “메모리가 병목일 때 대안이 될 수 있지만, 정확도나 속도 우위를 보인 것은 아니다”. counter, optimizer, schedule이 서로 달라서 adapter parameterization만의 효과를 분리할 수 없다고도 밝힌다(부록 D.4).
Finding 5. 보수적인 KL budget이 장기 학습에서 유리하다 (§4.4.3, Figure 6)
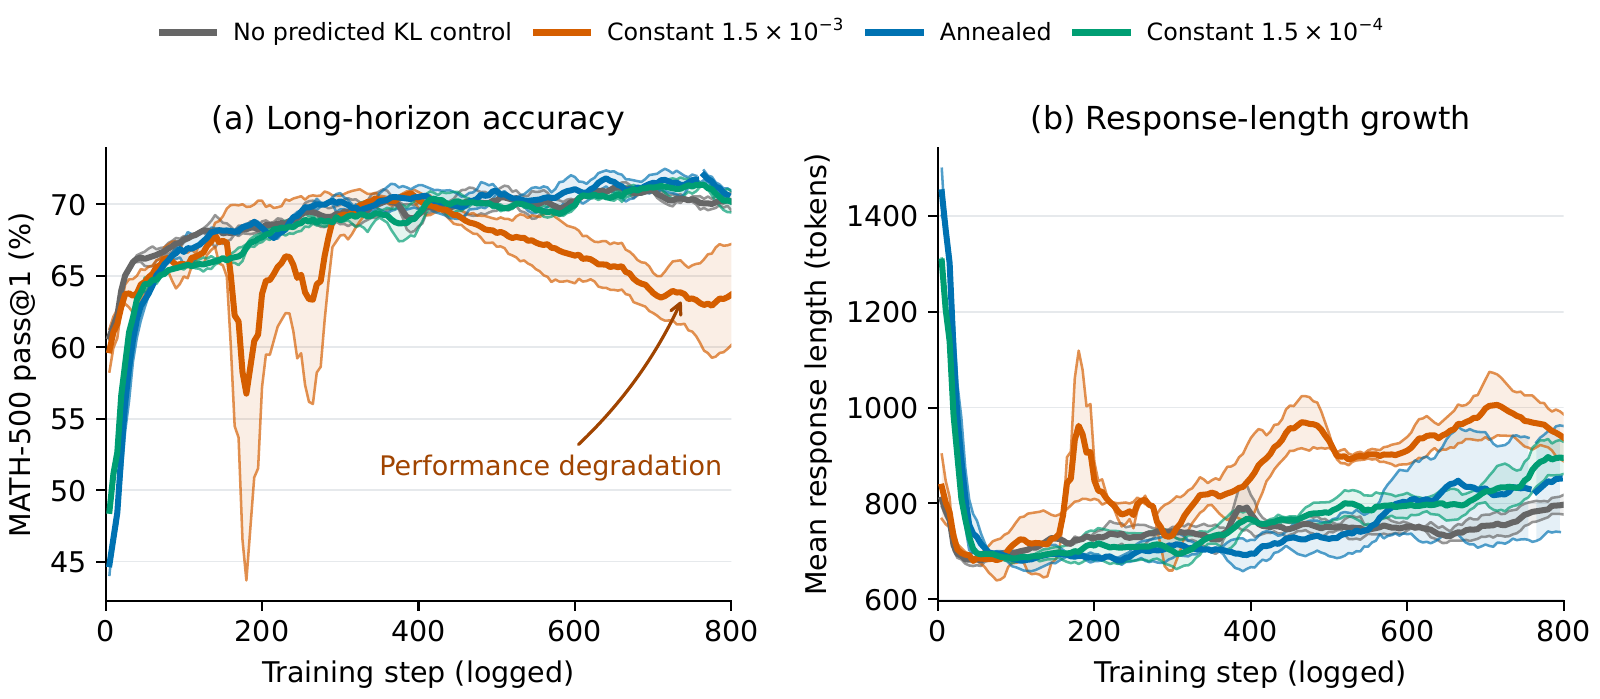
1.5B, SGD, rank 256 refresh, 2 seed, step 700–800 평균 pass@1:
| 설정 | pass@1 | 응답 길이 |
|---|---|---|
| KL control 없음 (relative update norm 6e-5 고정) | 70.30% | 774 |
| 상수 budget 1.5e-3 (큼) | 63.43% ↓ | 976 |
| 상수 budget 1.5e-4 (작음) | 71.03% | 858 |
| Annealed 2e-4 → 2e-5 | 71.47% | 832 |
- budget이 크면 성능이 무너진다. 그림에서 읽은 값으로 step ~180에 ~57%까지 급락하고, step 400 이후 점차 떨어진다.
- 저자들의 단서: no-control도 안정적이었다. annealed run은 따로 수집했고 초기 budget도 다르다. 그래서 이 결과는 “잘 보정된 KL control이 이득이 있다”는 정도를 시사할 뿐이다. KL control이 안정성에 필수라거나 annealing 자체가 이득의 원인이라는 것은 확립하지 못했다고 밝힌다.
한계와 해석
저자들이 밝힌 한계
- predicted KL은 국소 근사다. 실제 KL과 다를 수 있다(§2.3).
- mismatch subtraction은 휴리스틱이다(부록 D).
- 27B에서는 Dense가 OOM이어서 메모리 절감률이나 throughput을 비교할 수 없다(§4.2).
- LoRA와의 비교는 recipe 차이 때문에 parameterization의 효과를 분리하지 못한다(부록 D.4).
- KL ablation은 seed가 2개뿐이고, annealed run은 초기 budget이 다르다(§4.4.3).
- DAPO 데이터의 중복 제거는 학습 데이터 내부에서만 했다. MATH-500과의 의미적 decontamination은 하지 않았다(부록 C.1).
AI의 해석
이하는 논문의 주장이 아니라 정리자(Claude)의 해석이다.
“압축 동기화”는 실험으로 검증되지 않았다. 방법 섹션은 rollout 동기화 payload가 $O(dr)$로 줄어든다고 강조한다. 하지만 부록 D의 메인 설정에는 “full-weight policy synchronization”이라고 적혀 있다. 통신 절감은 설계상의 장점일 뿐, 이 논문에서 측정한 결과는 없다.
- 비교에 변수가 여러 개 섞여 있다. Dense와 LoGRA는 gradient 압축 말고도 많은 점이 다르다.
- optimizer: Adam vs momentum 없는 RowAdam
- step-size 규칙: LR schedule vs predicted-KL + mismatch subtraction
- 학습 대상: 전체 파라미터 vs attention/MLP만 1.5B에서 LoGRA가 4%p 앞선 것은 압축 덕이라기보다 step-size 규칙 차이 때문일 가능성이 커 보인다. Figure 2를 보면 Dense 1.5B는 LR 1e-6에서 아직 덜 학습된 상태다. “Dense + predicted-KL” 같은 ablation이 없어서 기여를 분해할 수 없다.
가장 가까운 baseline이 빠져 있다. related work에서 직접 대조하는 GaLore와 Flora는 실험 비교 대상에 없다. 메모리 측면에서도 8-bit Adam, Adafactor, dense SGD, CPU offloading처럼 “Adam state를 줄이는” 단순한 대안과 비교하지 않았다. 7B 절감분(~14.5 GiB/GPU)의 상당 부분은 Adam moment를 없앤 효과일 수 있다. dense SGD + KL control과 비교하면 압축 자체의 기여를 더 정확히 볼 수 있었을 것이다.
- reconstruction cosine은 사실상 이론값 그대로다. Rademacher $A$에서 $E[A^\top A]=I$이므로 $SA$는 $G$의 unbiased estimator다. 그리고 임의의 행렬에 대해 $\cos(G, GA^\top A)\approx 1/\sqrt{1+(k-1)/r}$가 된다.
- Qwen2.5-1.5B를 대입해 보자. 입력 차원은 q/k/v/o/gate/up 6개 행렬이 $k=1536$, down이 $k=8960$이다. 이 식으로 직접 계산하면 rank 256에서 약 0.348, rank 4에서 약 0.047이다. 논문 값(0.348, 0.046)과 거의 정확히 일치한다.
- 따라서 Figure 5(b)(c)의 heatmap은 gradient의 구조(low-rankness 등)를 잡아낸 것이 아니다. r과 k만으로 결정되는 값이다. 그래서 층, 시점, fixed/refresh에 관계없이 균일하게 나온다.
- 이렇게 보면 LoGRA는 “gradient가 low-rank라서 압축한다”기보다 랜덤 부분공간 gradient estimator + 작은 KL-controlled step에 가깝다. 이것이 잘 작동한다는 것 자체는 흥미롭다. TL;DR의 “정보량이 적은 reward” 직관과도 맞는다. 다만 논문의 서술(“captures sufficient task-relevant signal”)은 이 해석과 결이 조금 다르다.
peak memory 변동이 크다. Figure 3을 보면 LoGRA의 메모리는 주기적인 스파이크가 있다(7B peak 22.26 ± 4.98). 어디서 오는지 설명이 없다. 💭 predicted-KL probe(JVP)나 RowAdam 단계에서 일시적으로 버퍼가 생기는 것으로 추정된다. 실제 배포 시 필요한 메모리는 평균이 아니라 peak 기준이다. 그러니 “45.7%”보다는 peak 기준 절감(31.85 → 22.26, 약 30%)이 더 현실적인 숫자일 수 있다.
27B 실험은 “가능하다”는 시연이다. seed 하나, baseline 없음, 200 update에서 MATH-500 +4%p 정도다. 그리고 Qwen3.8-27B의 Pass@4(81.87%)는 7B(85.13%)보다 낮다. 4,096 토큰 context 한도가 thinking 계열 모델에 불리했을 가능성이 있다. 💭 27B가 “학습이 된다”는 것은 보였지만 “잘 된다”고 하기에는 근거가 약하다.
RL 셋업의 일반성. prompt당 response 1개 + global baseline은 요즘 주류인 GRPO(group sampling)와 다르다. GRPO나 multi-turn agent RL로 확장할 때는 메모리 병목이 activation과 KV(긴 context) 쪽으로 옮겨간다. 그 경우 LoGRA의 이득은 상대적으로 작아질 수 있다.
- 원고 완성도. 아직 덜 다듬어진 흔적이 보인다.
- §4.2에 “20,000 updates”라고 썼는데 그림과 표는 200–300 update다.
- “Figure~\ref{fig}(a)” 참조가 깨져 있다.
- Table 1(67.87)과 Table 2(68.47)의 1.5B Pass@1이 다르다. 집계 구간이 0–200 vs 300 step으로 다르기 때문이다.
- 부록에 같은 문장이 중복되어 있고, LaTeX 소스에
\experimentgap매크로가 남아 있다. 수치를 인용할 때는 어느 표의 값인지 확인하는 게 좋다.
더 생각해볼 질문
아래는 AI가 정리 과정에서 제안한 후속 질문입니다. 본인이 직접 작성한 의견이나 논문에서 검증한 결과로 표시하지 않습니다.
- Agent Plasticity와의 대비: Agent Plasticity는 weight를 고정하고 artifact로 자기개선한다. LoGRA는 weight 업데이트를 싸게 만드는 방향이다. weight 업데이트 비용이 충분히 낮아지면, artifact 기반 self-improvement와 weight 기반 self-improvement의 trade-off는 어떻게 달라질까?
- KL budget = plasticity 노브? predicted-KL budget은 “한 step에 정책이 얼마나 변해도 되는가”를 직접 정한다. 이것을 continual/self-improving agent에서 plasticity–stability 조절 장치로 쓸 수 있을까? 예: 새 task에 들어갈 때 budget을 키우고, 안정화되면 annealing.
- Seed + 작은 factor로 하는 동기화는 비동기 RL이나 여러 rollout worker(혹은 multi-agent) 환경에서 통신량을 줄이는 데 유용해 보인다. 실제로 측정해 볼 가치가 있다.
- Finding 3과 💭4를 합치면, cosine 0.35짜리 noisy gradient로도 RL이 Dense와 비슷하게 된다. 그렇다면 RL 신호가 필요로 하는 “유효 차원”은 얼마나 작은가? sparse reward의 agent task(긴 horizon)에서도 같은 결론일까?
- multi-turn agent RL에서는 activation 메모리가 지배적이다. LoGRA를 activation 절감 기법(checkpointing, sequence parallel)과 합치면 실제로 어디까지 내려갈까?
참고자료
용어 정리
| 용어 | 뜻 |
|---|---|
| Gradient sketch | gradient $G$에 랜덤 행렬 $A^\top$를 곱해 열 차원을 $k\to r$로 줄인 압축 표현 $S=GA^\top$ |
| Rademacher projection | 원소가 $\pm1/\sqrt r$인 랜덤 행렬. $E[A^\top A]=I$ |
| Projection refresh | 매 update마다 $A$를 새 seed로 다시 뽑는 것. 누적 update가 rank $r$에 갇히지 않게 한다 |
| Predicted-KL step control | update를 적용하기 전에 $\alpha^2 q(D)$로 정책 KL을 예측하고, $\alpha=\min{\alpha_{\max},\sqrt{\delta/q}}$로 step 크기를 정하는 방식 |
| KL budget $\delta$ | step당 허용하는 평균 예측 KL. 상수로 두거나 annealing한다 |
| JVP | Jacobian-vector product. update 방향을 따라 logit이 변하는 속도 $\dot z$를 계산하는 데 쓴다 |
| Mismatch subtraction | rollout 엔진과 trainer의 log-prob 차이를 KL budget에서 빼는 휴리스틱 |
| RowAdam | 행 단위 second moment만 두고 momentum은 없는 sketch optimizer |
| Dense Adam | 압축 없이 full gradient와 per-parameter Adam moment를 쓰는 baseline |
| Pass@k | 문제당 k개 샘플 중 하나라도 맞을 확률(여기서는 문제당 샘플 4개로 추정) |