Agent Plasticity: Measuring Self-Improvement Through Experience ↗
Harman Singh, Anton Bakhtin, Rulin Shao, Gabriel Synnaeve, Ilia Kulikov, Rob Fergus, Sanjeev Arora, Kurt Keutzer, Jason Weston, Anuj Mahajan†, Anirudh Goyal† (†공동 지도)
arXiv preprint (2026-10-06)
- 문제: 최종 점수만으로는 초기 능력과 경험을 통한 개선, 그 비용을 구분할 수 없다.
- 방법: weights가 고정된 agent lineage의 artifact와 held-out 학습 곡선을 추적해 plasticity를 측정한다.
- 결과: 최종 능력과 개선 효율의 순위는 다를 수 있으며, artifact 사용 여부만으로 모든 성능 차이를 설명할 수는 없다.
문제와 배경
배경과 읽는 관점
같은 점수를 얻은 두 agent라도 하나는 처음부터 강했고 다른 하나는 여러 번의 경험 뒤에 그 수준에 도달했을 수 있다. 최종 성능만 보면 이런 학습 경로와 그 과정에 들어간 비용이 사라진다. 이 논문은 경험을 남기고 재사용하는 agent를 평가할 때 무엇을 측정해야 하는지 묻는다.
기존 접근과 연구 질문
같은 점수에서 출발한 두 에이전트도 같은 양의 경험을 하고 나면 전혀 다른 곳에 도착할 수 있다. 저자들은 endpoint 성능 하나로는 세 가지를 구분할 수 없다고 지적한다.
- 최종 점수가 높은 게 원래 강해서인지, 많이 늘어서인지.
- 같은 만큼 늘었더라도 경험·연산을 얼마나 썼는지.
- 늘어난 실력이 학습에 쓴 상호작용 밖으로도 일반화되는지.
그래서 논문은 세 가지 질문을 세운다.
- 미래 성능이 실제로 개선되고, 학습에 쓰지 않은 상호작용에도 일반화되는가?
- 새 능력을 얼마나 효율적으로 획득하는가?
- 자기개선 루프는 어디서 막히는가?
Reflexion, Voyager, ExpeL, AWM, ADAS, Gödel Agent, DGM, SEAL 같은 기존 연구는 주로 개선 메커니즘을 만든다. 이 논문은 그 반대편인 측정 문제에 집중한다.
이 글의 중심은 새로운 memory 기법의 제안보다 자기개선의 측정이다. 초기 능력, 경험 이후의 성능 변화, 그 변화를 얻는 비용, 학습 밖의 상호작용으로의 전이를 분리해서 읽어야 한다. 그래야 높은 endpoint 점수와 높은 plasticity가 왜 다른 모델에서 나타날 수 있는지 이해할 수 있다.
핵심 아이디어
먼저 직관으로 이해하기
모델 weights를 고정하고 다음 실행에 넘어갈 수 있는 정보를 명시적인 artifact로 제한하면, agent lineage의 변화를 artifact 인벤토리의 변화와 함께 관찰할 수 있다. 각 checkpoint의 held-out 성능을 비용에 대해 추적하고, 개선이 막힐 때 관련 artifact가 없었는지·사용하지 않았는지·사용해도 실패했는지를 구분한다.
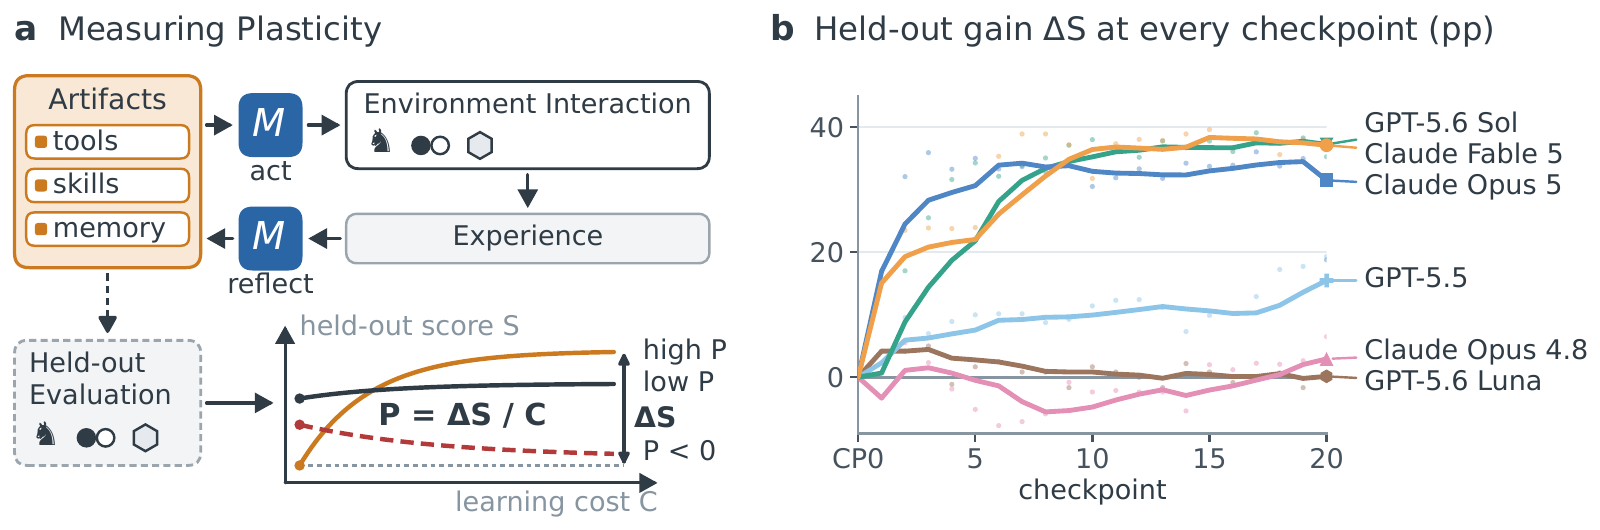
checkpoint $t$의 에이전트는 고정된 LLM $M$과 영속 artifact 인벤토리 $I_t$의 쌍이다.
- $I_t$에는 실행 가능한 Python 도구, 자연어 전략·skill, 텍스트 메모리가 들어간다. NetHack에서는
CLAUDE.md/AGENTS.md,SKILL.md도 포함된다. - 매 acting episode는 빈 컨텍스트에서 시작한다. 대화 기록이나 임시 파일은 다음 episode로 넘어가지 않는다. 다음으로 넘어가는 건 오직 $I_t$뿐이다.
루프는 다음과 같다.
[act]     (M, I_t) 로 training 게임 플레이  →  evidence E_t (궤적, 결과, 실행 trace, 에러, 수 품질 피드백)
[reflect] 같은 모델 M 이 I_{t+1} = U_M(I_t, E_t) 제안
[validate] 구조·실행 검사 통과 시에만 커밋 (거부되면 I_t 유지; 거부된 시도도 비용에 포함)
이렇게 해서 얻는 $(M,I_0),\dots,(M,I_T)$를 agent lineage라고 부른다. 수정이 성능을 올릴 수도, 유지할 수도, 떨어뜨릴 수도 있다. 그래서 저자들은 endpoint만 보지 않고 곡선 전체를 보고한다.
평가 split
| Split | 의미 | reflection에 노출? |
|---|---|---|
| Train | 학습에 쓰는 상호작용 | ✅ (궤적 + 피드백) |
| Held-out ID | 같은 난이도 분포의 새 게임 | ❌ |
| Held-out OOD | 더 강한 상대 | ❌ |
held-out 궤적과 점수는 reflection에 절대 노출되지 않는다. 그래서 held-out ID 상승은 artifact가 학습 데이터 밖에서도 쓸모 있다는 증거가 된다.
정의와 수식
학습 비용
\(C_{m,e,t}=\sum_{u=0}^{t-1}\left(c^{\text{train}}_{m,e,u}+c^{\text{reflect}}_{m,e,u}\right)\)
- training 중 환경과 상호작용한 모델 호출 비용과, reflection 비용(거부된 시도 포함)을 더한 값이다.
- 토큰 사용량을 달러로 환산한다. 물리적 연산량이 아니라 “학습 비용”의 proxy다.
평균 plasticity
\(P^{\text{score}}_{T}=\frac{S_T-S_0}{C_T}\quad(\text{점수 pp / \$1{,}000})\) 음수가 될 수 있고, plateau 이후에도 비용이 계속 쌓이면 값이 떨어진다. 즉 평가 horizon에 따라 값이 달라진다.
헤드라인 지표: 포화 시점까지의 plasticity $P^{\text{sat}}$
held-out ID 점수를 비용에 대한 Hill 곡선으로 fit한다. \(\hat S(C)=S_0+A\frac{C^h}{C^h+C_{50}^h}\)
- 4개 파라미터 $(S_0, A, C_{50}, h)$를 binomial MLE로 함께 fit한다.
- $C^\ast$는 fit이 상승폭의 90%에 처음 도달한 관측 checkpoint의 비용이다.
- $P^{\text{sat}}=\dfrac{\hat S(C^\ast)-S_0}{C^\ast}$
- 90% 상승폭이 10pp 미만이면 $P^{\text{sat}}=0$으로 둔다(의미 있는 상승 없음).
- 관측 범위 안에서 90%에 도달하지 못하면 최종 비용의 3배까지 외삽한다. 그래도 안 되면 “plasticity to date”를 대신 보고한다. 신뢰구간은 parametric bootstrap으로 낸다.
직관: “포화 직전까지, 1000달러당 몇 점 올랐나”를 재는 지표다. 일찍 포화했는데 계속 돈을 쓰는 모델이 불리해지지 않도록, 포화점에서 끊어서 잰다.
실패 진단: 루프의 어디가 막혔나
식별된 결정 실패(decision failure)마다 아래 셋 중 하나로 분류한다.
| 범주 | 의미 | 시사하는 병목 |
|---|---|---|
| $\mathcal{F}_{\text{absent}}$ | 이 실패를 커버하는 artifact가 없었다 | artifact 생성 |
| $\mathcal{F}_{\text{missed}}$ | 커버하는 artifact가 있었는데 안 썼다 | 검색·재사용 |
| $\mathcal{F}_{\text{used}}$ | 커버하는 artifact를 썼는데도 실패했다 | artifact 품질·일반화·적용 |
위 분류는 실패한 경우만 조건으로 삼는다. 그래서 성공한 결정까지 포함하는 decision-level reuse를 따로 잰다. 관련 artifact가 하나라도 있는 수 가운데 실제로 artifact를 쓴 비율이다. 라벨링은 Gemini 3.1 Pro가 실행 로그(파일 read, Python 호출)와 함께 판단한다. 6단계 파이프라인(식별 → 검증 → 관계 → 검증 → 재사용 → 검증)을 거친다.
실험과 핵심 결과
실험 설정
| 환경 | 상대/난이도 | checkpoint당 게임 수 | reflection이 받는 피드백 |
|---|---|---|---|
| Chess (Hard) — 메인 | Stockfish 16, 20k nodes. Train skill 1–8, ID 3–8, OOD 12 | 16 / 12 / 12 | skill-20 Stockfish의 수별 centipawn loss (ok / inaccuracy / mistake / blunder) |
| Chess (Easy) | Train·ID skill 2–5, OOD 8–10 | 16 / 16 / 12 | 위와 동일 |
| Go 5×5 | GNU Go lv 5–9 (OOD lv 10) | 20 / 20 / 12 | 결정론적 진단(따냄, 활로, 자충 등). 전문가급 라벨 없음 |
| Hex 6×6 | alpha-beta 10k–1M nodes (OOD 10M) | 40 / 40 / 32 | 놓친 즉시승, 막을 수 있던 즉시패 등 규칙 기반 |
| NetHack | Valkyrie, 매 checkpoint 새 seed 10게임. Claude Code / Codex 네이티브 harness | 10 | 10게임 전체 trace, 사망 원인 등. 최적행동 oracle 없음 |
- 모델: Claude Fable 5, Claude Opus 5 / 4.8 / 4.6, GPT-5.5, GPT-5.6 Sol / Luna, Gemini 3.1 Pro. Go·Hex는 비용 문제로 일부 모델만 돌렸다. NetHack은 Opus 5.5, Sonnet 5 등이 포함된 6개 lineage다.
- 보드게임은 checkpoint 0–20(20라운드), NetHack은 0–40.
- actor는 격리된 Python 컨테이너에서 제한된 board API로만 상호작용한다. 상대 프로세스, held-out, 네트워크에는 접근할 수 없다.
- 미완료 게임(예산 초과, 타임아웃, 무응답)은 패배로 처리한다.
Finding 1 — 영속적 자기개선은 모델과 태스크에 따라 다르다
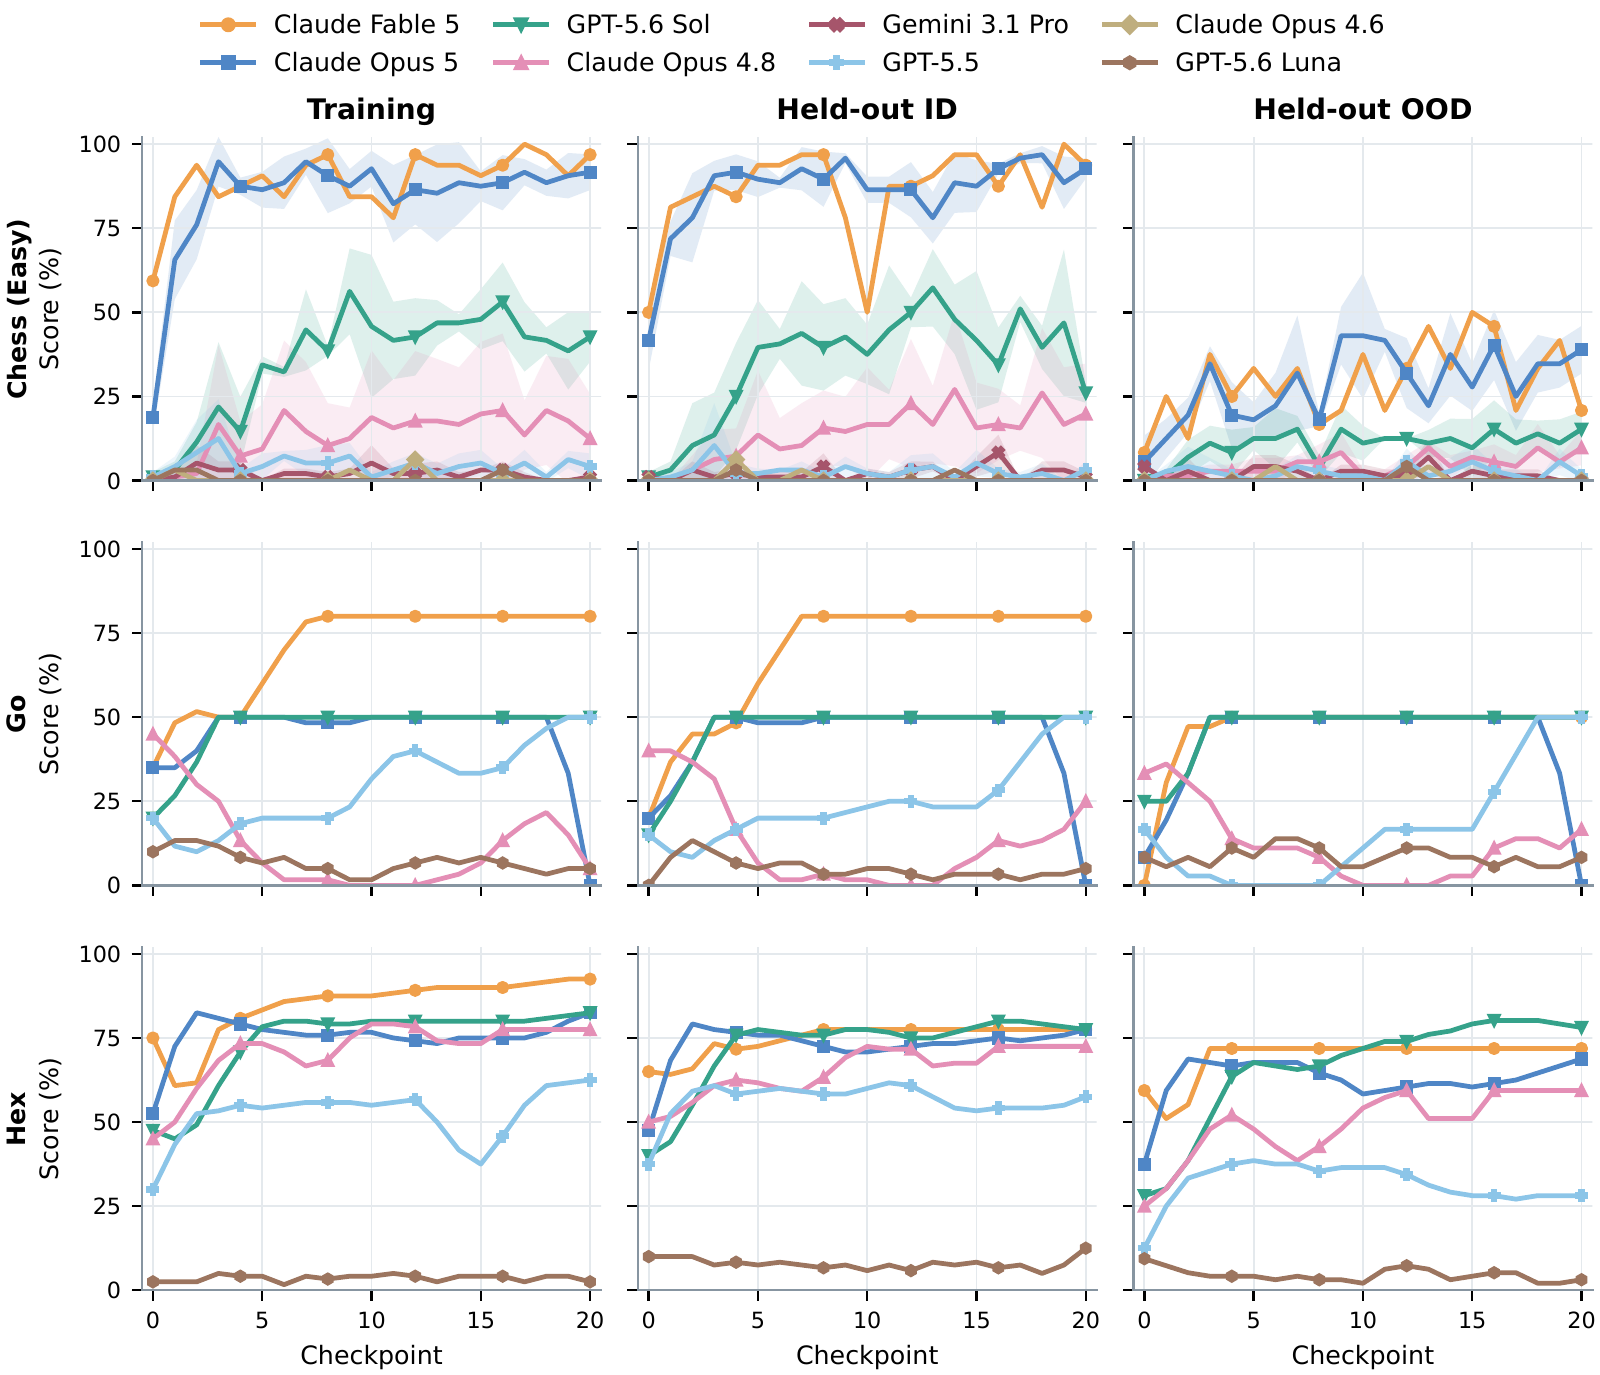
📎 Figure 3: Hard chess train/ID/OOD 곡선 · Appendix: Easy chess, Go, Hex
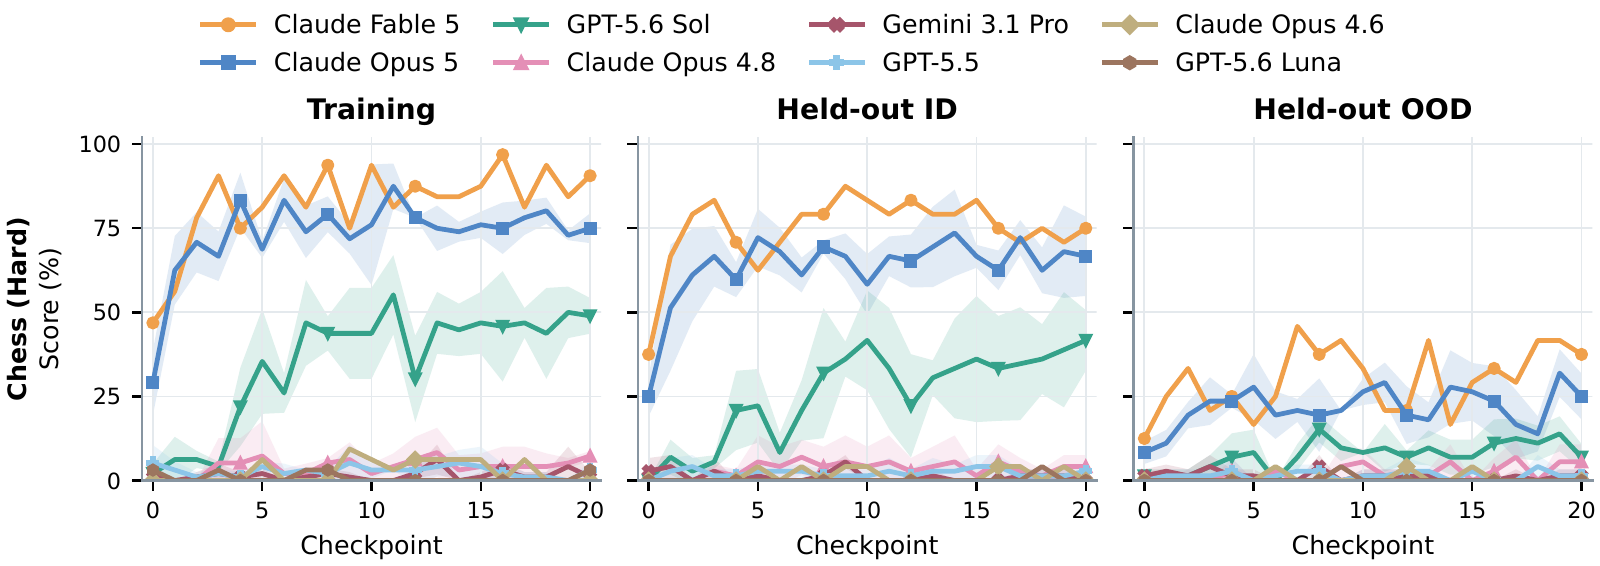
- Hard chess, held-out ID
- Fable 5: 37.5% → 73.3%
- Opus 5: 25.0% → 66.4% (CP16–20 평균)
- GPT-5.6 Sol: ~0% → 36.9%. 절대 점수는 낮지만 상승폭은 비슷하다.
- Opus 4.8은 Easy에서만 소폭 개선(0 → 19.0%)됐다.
- 몇몇 모델은 제자리이거나 오히려 떨어진다.
- 같은 인터페이스를 써도 개선이 보장되지는 않는다.
- ID에서의 개선이 OOD(더 강한 상대)로는 부분적으로만 옮겨간다.
- 태스크 의존성:
- Opus 4.8은 Go에서 퇴보하고 Hex에서는 크게 개선된다.
- Opus 5는 Go에서 잘 오르다가 마지막 checkpoint의 도구 버그 하나로 급락한다.
- NetHack: Opus 5.5만 뚜렷하게 개선된다. 평균 점수가 ~2k(CP0–2)에서 ~6k(CP36–40)로 오르고, CP11에서 포화하며, $P^{\text{sat}}=61.75$다. 보드게임에서 가장 plastic했던 GPT-5.6 Sol은 NetHack에서 오히려 하락한다(~570 → 420).
→ 저자들의 결론: plasticity를 모델 고유 속성처럼 다루지 말고, 태스크 분포 위에서 평가해야 한다.
Finding 2 — Endpoint 성능 ≠ 획득 효율
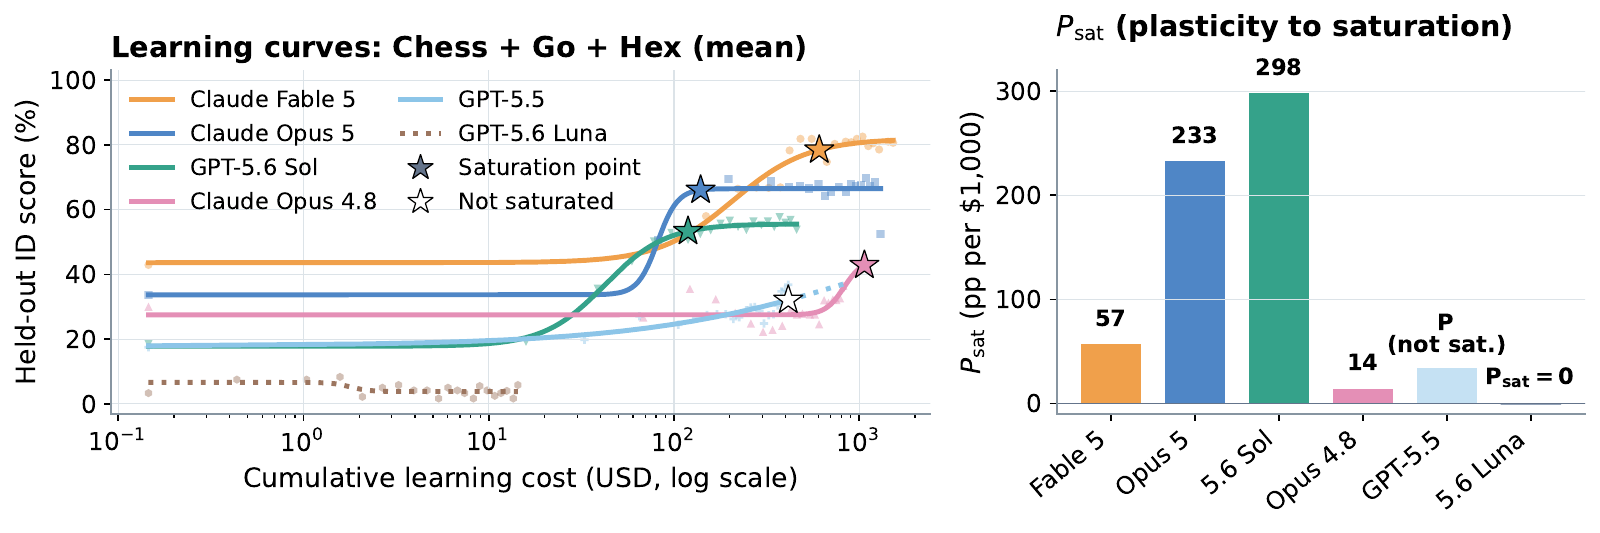
Chess(Hard+Easy), Go, Hex 평균 곡선 기준:
| 모델 | $P^{\text{sat}}$ (pp / $1,000) | 비고 |
|---|---|---|
| GPT-5.6 Sol | 298 | 학습 효율 1위. ~$100대 비용에서 포화 |
| Claude Opus 5 | 233 | 급격히 오른 뒤 plateau |
| Claude Fable 5 | 57 | 최종 fitted 성능 1위(~80%), 대신 비용이 ~$600 이상 |
| Claude Opus 4.8 | 14 | ~$1,000 가까이 써야 상승 |
| GPT-5.5 | 포화 판정 불가 | 끝까지 천천히 상승 중 |
| GPT-5.6 Luna | 0 | 의미 있는 상승 없음 |
- GPT-5.6 Sol은 출발점이 Opus 4.8보다 낮았지만, 최종 성능과 plasticity 둘 다에서 Opus 4.8을 앞선다.
- 저자들도 이 지표가 provider 가격과 fit 가정에 의존하는 protocol-dependent 지표이며, 보편적인 모델 순위가 아니라고 명시한다.
Finding 3 — Artifact 재사용은 개선과 연관되지만, 실력의 proxy는 아니다
📎 Figure 4: decision-level reuse & failure 구성 · Figure 5: reuse 대비 game-level 개선 · Figure 6: checkpoint별 dynamics
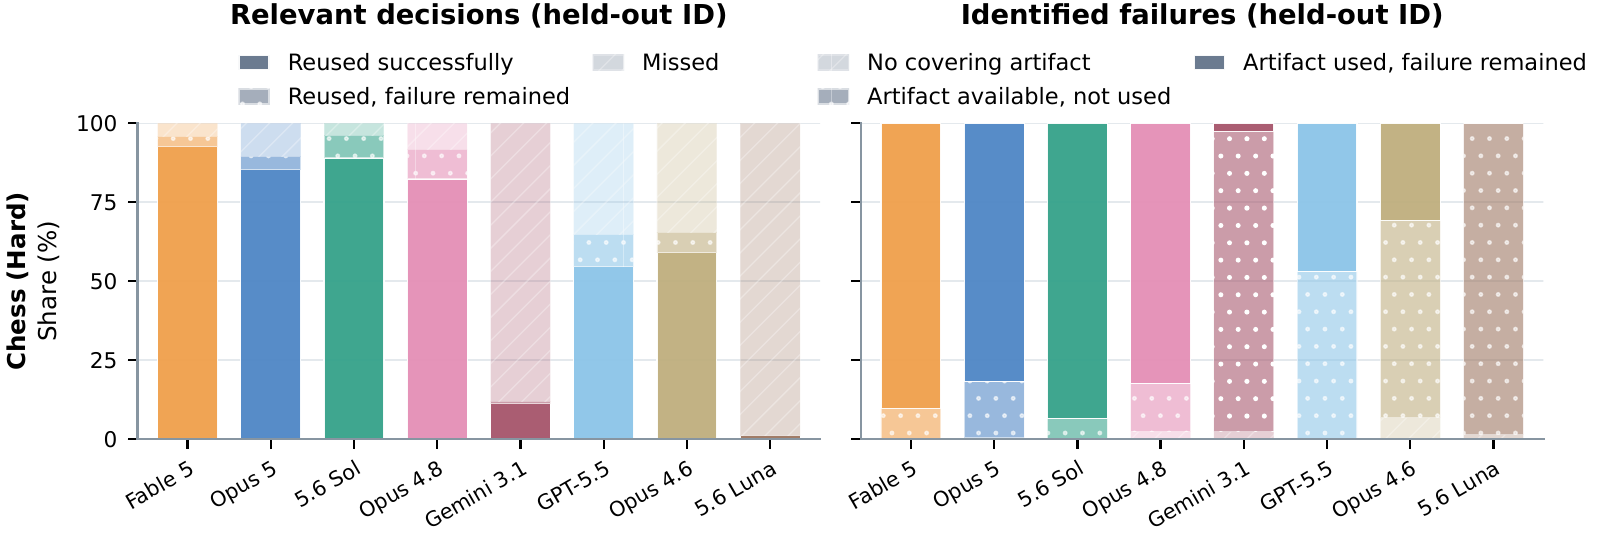
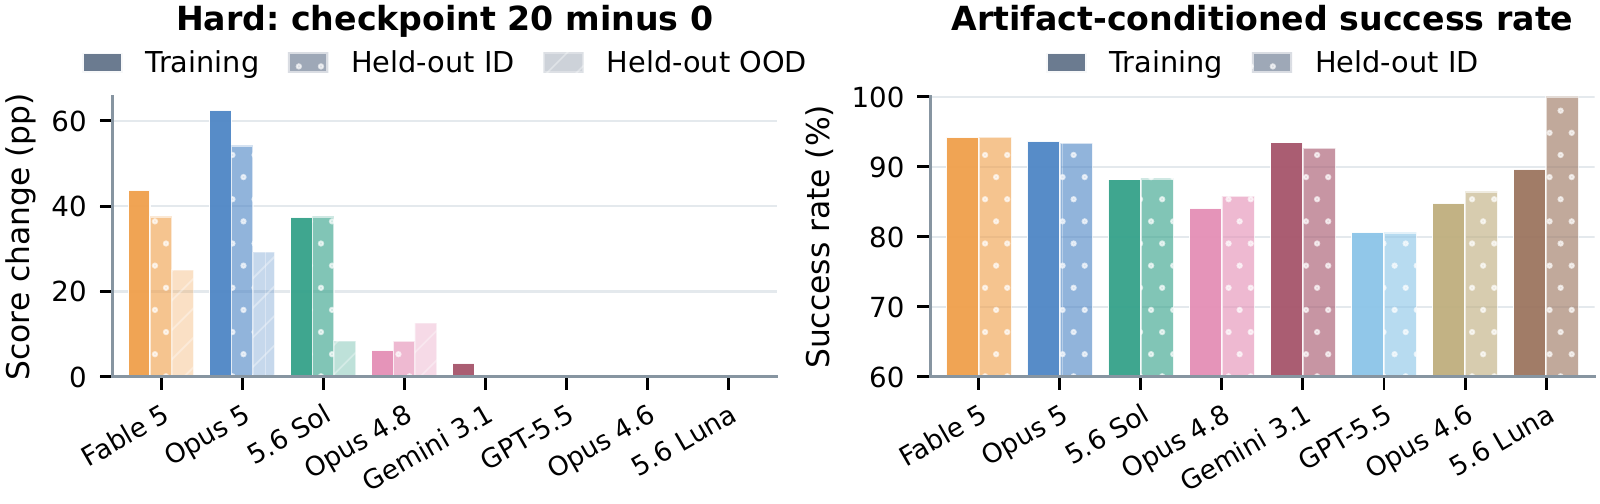
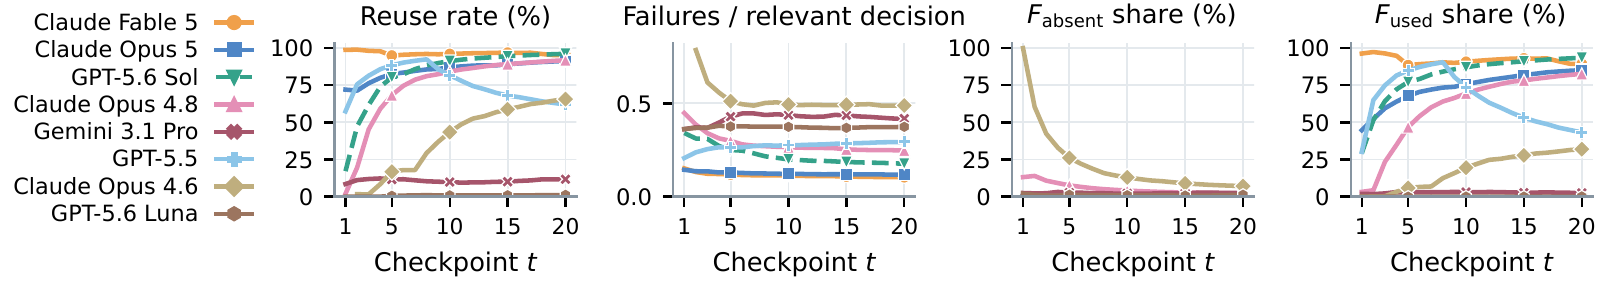
(a) 재사용이 낮으면 개선도 약하다. 관련 artifact가 있었는데 쓰지 않은 결정의 비율:
| 모델 | artifact 미사용 비율 |
|---|---|
| GPT-5.6 Luna | ~98% (Go에서는 재사용률이 ~1%) |
| Gemini 3.1 Pro | ~87% |
| Opus 4.6 | ~51% |
| GPT-5.5 | ~28% |
| Fable 5, Opus 5, Opus 4.8, Sol | 2–6% |
19개 model–game 셀에서 held-out ID 재사용률과 점수 상승 사이에 상관이 나타난다.
(b) 재사용이 높아도 성능 차이는 설명되지 않는다. Fable 5, Opus 5, Opus 4.8, Sol은 모두 관련 결정의 94–98%에서 artifact를 쓰지만 게임 점수는 크게 다르다. artifact를 썼을 때의 성공률(artifact-conditioned success rate)로도 이 차이는 설명되지 않는다.
(c) 강한 개선자도 artifact를 쓰면서 실패한다.
- 고재사용 모델은 관련 결정당 실패 수가 0.16으로, 다른 모델의 0.38보다 적다.
- 하지만 남은 실패의 83–99%가 F_used, 즉 artifact를 쓰고 있는 중에 일어난다.
- → 병목은 “검색”이 아니라 artifact의 품질·일반화·적용에 있다.
(d) 이상 현상들
- 재사용이 먼저 오르고 성능은 나중에 오른다. Sol과 Opus 4.8은 재사용률이 CP1의 20% 미만에서 CP3의 93–99%로 뛰었지만, 성능 peak는 각각 CP12와 CP5였다.
- GPT-5.5는 쓰던 artifact를 버린다. CP2–8에는 96–100% 사용했는데 CP9 이후 32–50%로 떨어졌다. artifact 자체는 변하지 않았다.
- Opus 4.8 (Go): 재사용 성공률은 59–65%에서 93%로 올랐는데, held-out ID 점수는 40%에서 10–25%로 떨어졌다. 로컬 진단 지표가 좋아져도 태스크 성능은 거꾸로 갈 수 있다.
- Opus 4.6: 실패 중 F_used 비중이 6.5%에서 52%로 바뀌었지만, 실패율 자체는 0.42 → 0.41로 그대로다. 실패 유형이 바뀐다고 해서 진보한 것은 아니다.
- Go/Hex: 관련 artifact는 27개 lineage 중 25개에서 결정의 99% 이상에 존재한다. 그런데도 absent 실패의 67–100%가 “관련 artifact가 있는 결정”에서 일어난다. 관련 있음(relevance) ≠ 해당 실패를 커버함(coverage).
정성 사례: 실제로 무엇을 배웠나
📎 Figure 7: chess / NetHack 사례 · NetHack 사례 상세 · NetHack 문 사례
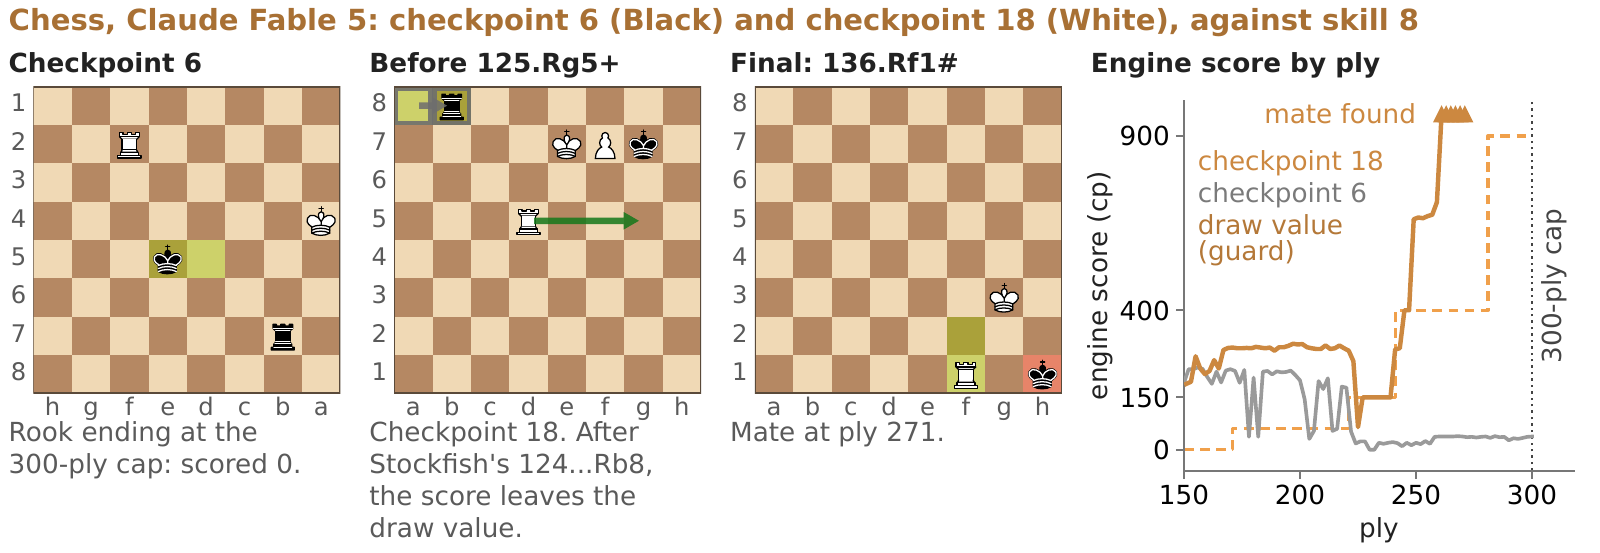
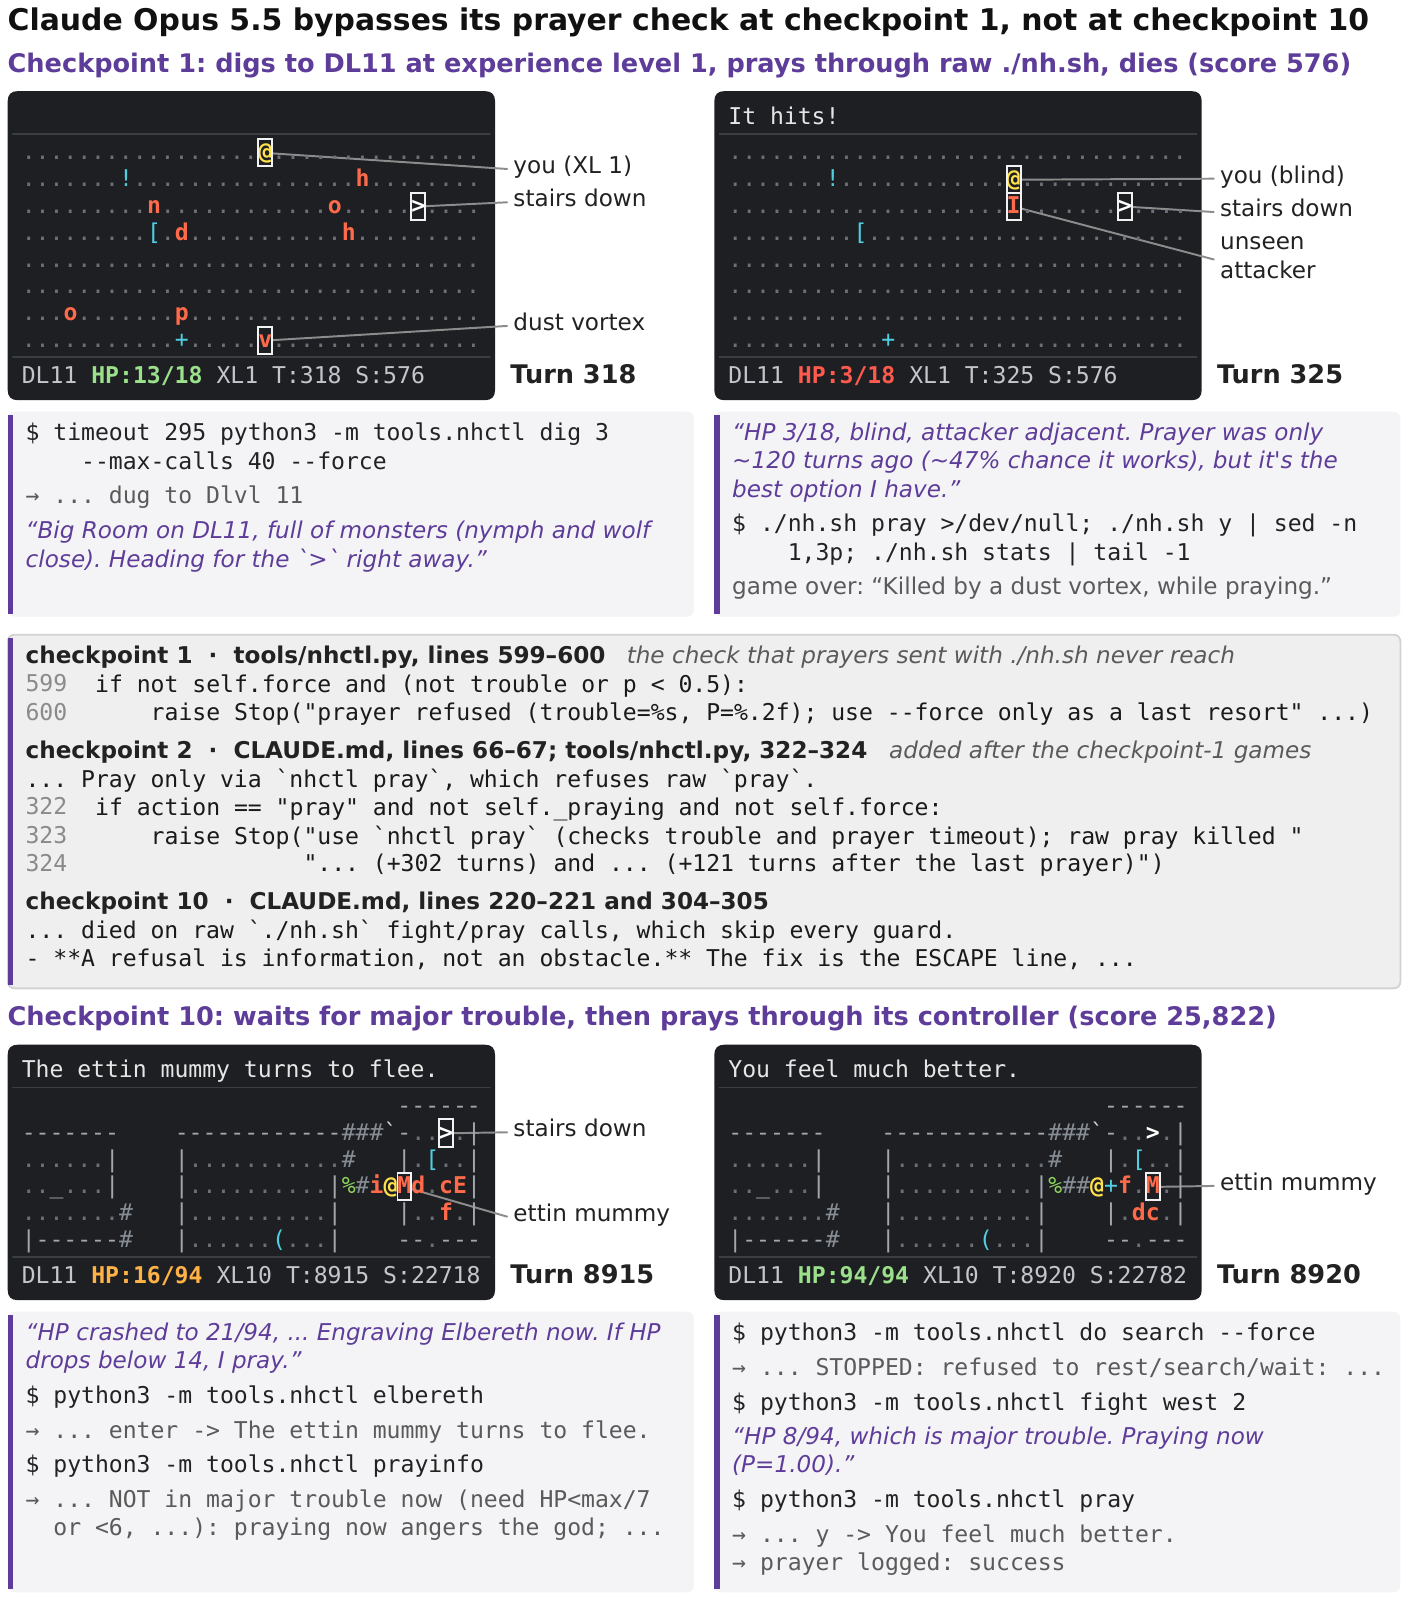
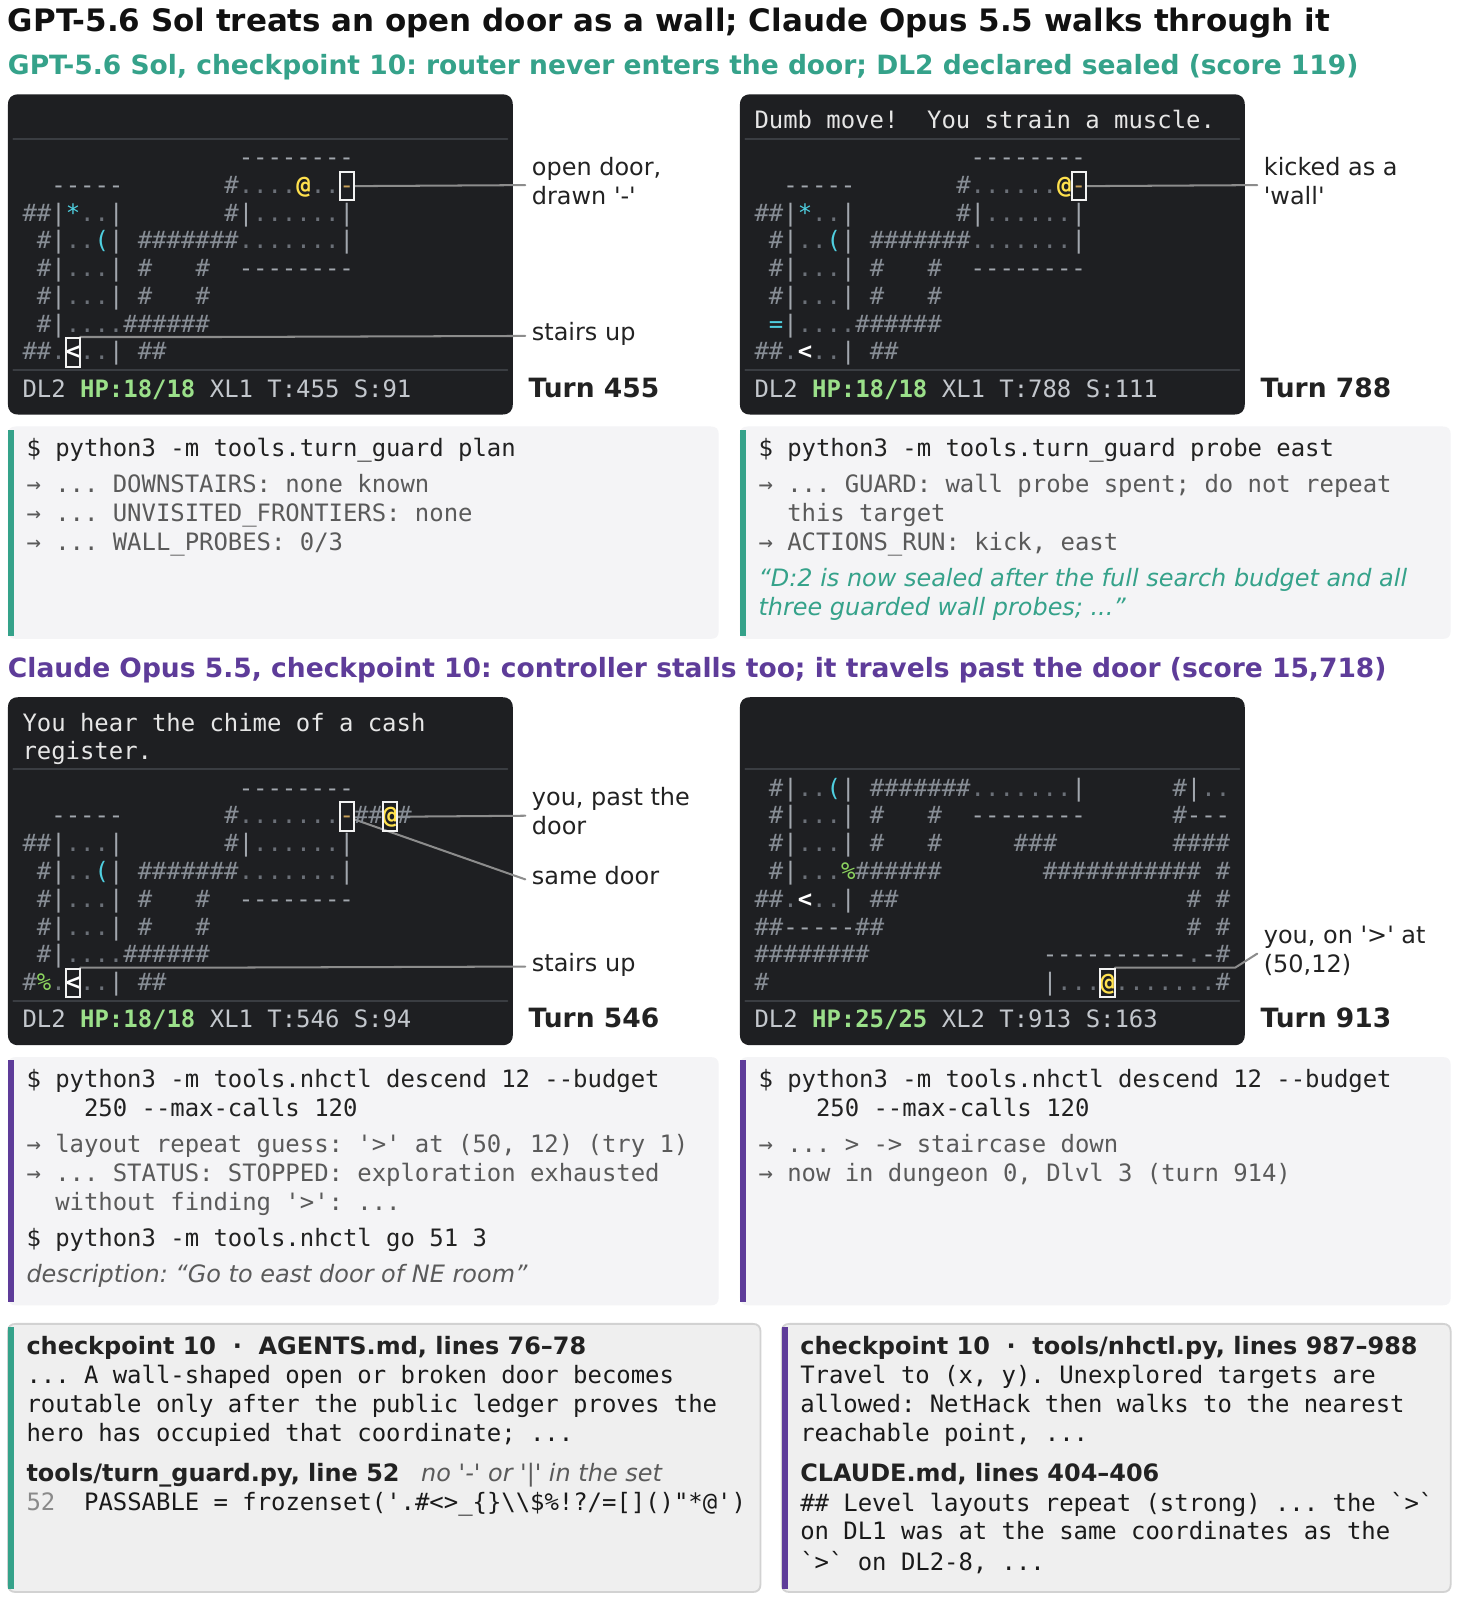
- Claude Fable 5 (chess): 외부 라이브러리 없이 자체 체스 엔진을 작성한 뒤, 실패할 때마다 고친다.
- 킹이 공격받는 실수 → 체크 회피 수 탐색 추가
- 이긴 판을 놓침 → 반복 국면(3수 동형) 처리 변경
- 엔드게임 마무리 실패 → 엔드게임 탐색 시간 증가
- 타임아웃 → 고정 예산으로 여러 수를 한 번에 두는 헬퍼 작성
- 300-ply 제한으로 0점을 받은 뒤에는, 제한이 다가오면 무승부 가치를 높게 보도록 수정했다. CP18에서는 무승부를 버티다가 Stockfish가 실수하자 메이트로 이겼다.
- Claude Opus 5.5 (NetHack): 위험한 기도를 거부하는 컨트롤러(
nhctl.py)를 만들었지만, raw 키 입력으로 그 검사를 우회해 기도하다 죽는다. 그 뒤 “Pray only vianhctl pray” 규칙을 추가했고, CP10에서는 HP 8/94 상황에서 정상적으로 회복한다. 다만 이후에도 가끔 우회한다. - GPT-5.5: reflection이 “저장된 수 선택 프로그램을 바로 로드하라”고 계속 써 두는데도, 에이전트는 매번 파일 목록부터 뒤진다. 써 놓은 지시와 그것을 따르는 것은 다르다.
- NetHack CP10 artifact 비교: Opus 5는 도구 코드가 13개 파일, 8,237줄로 Opus 5.5(6개 파일, 2,713줄)의 3배인데도 점수가 낮다. 코드 양이나 도구 사용량이 많다고 더 잘 배우는 것은 아니다. (단, Opus 5.5는 CP0부터 이미 다른 모델의 2.6–25배였다.)
한계와 해석
저자들이 밝힌 한계
- Plasticity ≠ context management. 실행 가능한 도구까지 포함하는 세팅이다. 또 재사용률은 높은데 성능이 다른 사례가 있으니, 검색만으로는 설명되지 않는다. 다만 long-context instruction following의 기여를 분리하지는 못했다.
- 병목에 따라 처방이 다르다.
- 안 쓰는 경우 → retrieval·deployment 개선
- 쓰는데도 실패하는 경우 → artifact 품질 개선
- 지금 분석은 관찰적이다. 인과를 보려면 artifact 제거·교체·강제 호출 같은 개입 실험이 필요하다.
- artifact 검증도 “실행되는가”를 넘어 행동적 효과를 봐야 한다.
- 경험의 기여는 분리되지 않았다. 환경 피드백의 가치와, 분석·수정에 들어간 추가 연산의 가치가 섞여 있다. 피드백 없이 같은 예산으로 reflection하는 대조군이 필요하다.
- 일반화의 범위. lineage는 태스크별로 따로 학습되므로, 태스크 간 artifact 전이는 검증하지 않았다. 유한한 평가셋 때문에 checkpoint 노이즈가 있고, 결과가 headroom·horizon·fit 가정·가격에 의존한다.
- 향후 방향: plasticity를 post-training의 목표로. RL 보상이 즉시 성능뿐 아니라 “미래 행동을 개선하는 지식을 만들고, 유지하고, 활용하는 능력”까지 보상하게 하자는 제안이다. “더 유능한 agent가 아니라, 더 잘 유능해지는 agent.”
AI의 해석
아래는 논문 내용을 바탕으로 한 AI 정리자(Claude)의 해석과 의문점이며, 논문의 주장이 아니다.
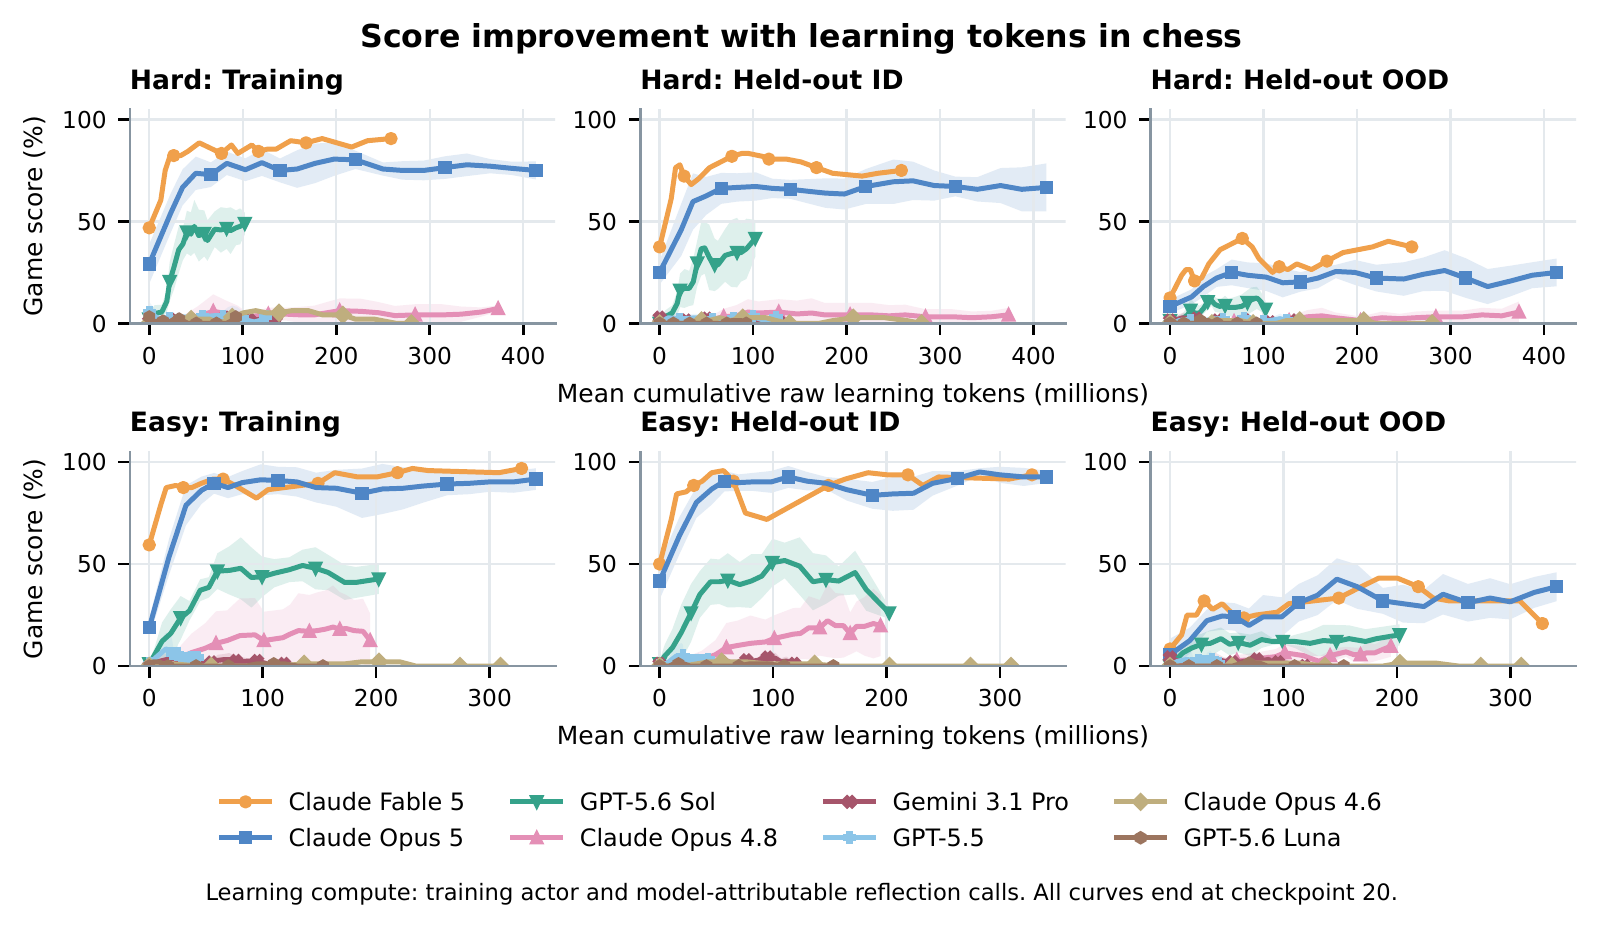
- 분모가 달러다. $P^{\text{sat}}$의 분모는 토큰 수 × provider 가격이다. 따라서 싼 모델이 구조적으로 유리하다. 실제로 부록의 토큰 기준 체스 곡선(chess_performance_vs_learning_tokens.pdf)을 보면 순위가 달라진다. Fable 5는 Hard held-out ID에서 수천만 토큰 안에 70%대로 뛰고, Sol은 ~100M 토큰을 써서 ~40%에 이른다(그림을 눈으로 읽은 값). 즉 Fable 5의 낮은 $P^{\text{sat}}$(57)에는 “잘 못 배운다”보다 “단가가 비싸다”는 효과가 크게 섞여 있다. 달러 기준 지표는 토큰/checkpoint 기준 곡선과 함께 봐야 한다.
- Headroom 효과. 출발점이 낮은 모델(Sol ~0%)은 오를 공간이 크고, 출발점이 높은 모델은 천장에 가깝다. 0–100 점수에서 절대 pp 상승을 비교하면 이 효과가 섞인다.
- 표본 크기. Hard chess held-out ID는 checkpoint당 12게임이다. 점수가 50% 근처면 표준오차가 약 ±14pp라서 checkpoint 간 출렁임이 크다. 저자들이 단일 점이 아니라 CP16–20 평균과 곡선 fit을 쓰는 이유이기도 하다.
- Judge도 피평가자다. 실패·재사용 라벨을 Gemini 3.1 Pro가 매기는데, Gemini 3.1 Pro는 평가 대상 모델이기도 하다. 그리고 하필 재사용률이 낮게 나온 쪽(~87% 미사용)이다. 실행 로그 근거를 요구하긴 하지만 judge bias를 점검할 여지가 있다.
- NetHack은 모델이 아니라 harness를 평가한다. Claude Code와 Codex라는 네이티브 harness 위에서 돌렸으므로, 측정 대상은 “모델 + harness”다. 저자들도 이를 명시한다. 또 Opus 5.5 lineage만 이후 버전 harness를 썼다는 caveat가 있다.
- Lineage가 각 1개. 대부분 설정에서 모델당 lineage가 하나라서, 같은 모델의 seed 간 분산(운 좋은 초기 artifact 하나가 궤적을 바꾸는 경우)은 알 수 없다. Opus 5의 Go 붕괴처럼 단일 도구 버그가 곡선을 지배하는 사례도 있다.
더 생각해볼 질문
아래는 AI가 정리 과정에서 제안한 후속 질문입니다. 본인이 직접 작성한 의견이나 논문에서 검증한 결과로 표시하지 않습니다.
- 자기 artifact를 안 쓰는 문제(Luna, Gemini)는 harness 설계로 풀 수 있을까, 아니면 모델의 습성일까? 강제 로딩이나 tool-first 프롬프트로 얼마나 회복되는지 궁금하다.
- F_used 실패를 줄이려면 artifact 검증을 “실행 가능”에서 “행동적으로 효과 있음”으로 바꿔야 한다. 예: 회귀 테스트 게임셋으로 artifact를 A/B 검증하기.
- Plasticity를 RL 목표로 삼는다면, 보상은 어떤 형태여야 할까? (예: 미래 세대의 held-out 성능 향상분을 현 세대의 reflection에 credit assignment)
- 태스크 간 전이: 체스에서 만든 “엔진 작성 메타 스킬”이 Go나 Hex에 전이될까?
참고자료
용어 정리
| 용어 | 의미 |
|---|---|
| Agent plasticity | 경험을 held-out 성능 향상으로 바꾸는 효율 (Δ점수 / 학습비용) |
| Artifact / Inventory $I_t$ | 세대 간 상속되는 도구·skill·전략·메모리의 집합 |
| Agent lineage | 고정 모델 $M$과 $I_0 \dots I_T$의 시퀀스 |
| Held-out ID / OOD | 학습과 같은 난이도의 미노출 게임 / 더 강한 상대 |
| $P^{\text{sat}}$ | 포화(90% 상승) 시점까지의 plasticity |
| Decision-level reuse | 관련 artifact가 있는 결정 중 실제로 사용한 비율 |
| $\mathcal{F}_{\text{absent/missed/used}}$ | 실패 원인 분류: artifact 없음 / 있었는데 안 씀 / 썼는데 실패 |