When Successful Strategies Fail: Adaptation to Environmental Novelty in Terminal Agents ↗
Janvijay Singh, Vaishnavi Shrivastava, Dilek Hakkani-Tür, Ece Kamar, Asli Celikyilmaz
arXiv preprint (2026-09), ICLR 2027 템플릿 원고
- 문제: 원래 목표가 같아도 환경에 대한 가정 하나가 깨지면 terminal agent의 전략이 실패할 수 있다.
- 방법: AGNI는 성공 trajectory의 가정에서 novelty를 만들고 base·novel·disclosed 조건을 비교한다.
- 결과: 기본 성능 순위만으로 적응 성능을 설명하기 어렵고, 진단과 전략 수정 단계가 주요 병목으로 나타난다.
문제와 배경
배경과 읽는 관점
잘 작동하던 실행 전략도 권한, 도구 동작, 파일 형식에 대한 가정이 깨지면 실패할 수 있다. 사용자가 목표를 바꾸지 않아도 환경만 바뀌어 기존 절차를 더는 실행할 수 없는 상황이다. 이런 변화에서 필요한 것은 새 지시를 기다리는 것이 아니라, 관측된 실패를 통해 무엇이 달라졌는지 알아내고 원래 목표를 계속 수행하는 능력이다.
기존 접근과 연구 질문
- LLM agent는 점점 절차적 지시가 아니라 고수준 목표만 받아 긴 작업을 수행한다(§1). 그러려면 agent가 직접 전략을 짜야 하고, 그 전략에는 instruction에 적히지 않은 환경 가정(사용 가능한 자원, 인터페이스 동작, 권한 등)이 들어간다.
- 이런 가정이 맞는지는 상호작용해 봐야만 알 수 있다. 그래서 신뢰할 수 있는 agent라면 처음 세운 전략을 실행하는 데서 끝나지 않고, 가정이 틀렸을 때 그것을 알아채고 전략을 고쳐 원래 목표를 달성해야 한다(open-world learning 관점, Langley 2020 등 인용).
- 저자들이 terminal agent를 고른 이유는 두 가지다.
- 간단한 파일 처리부터 ML까지 task가 이질적이고, 도구와 자원이 open-ended다.
- 실제 소프트웨어는 인터페이스, 의존성, 설정, 워크플로가 계속 바뀐다. 그래서 적응 능력이 실무적으로 중요하다.
- 기존 robustness 연구와 다른 점(§2): 기존 연구는 tool 제거, 인터페이스 변경 같은 perturbation family를 미리 정해 둔다. AGNI는 성공 trajectory가 실제로 기대던 가정에서 perturbation을 끌어낸다. 그래서 novelty가 strategy-dependent하다. 어떤 가정이 깨졌는지 알기 때문에 trajectory 안에서 적응이 어디서 막히는지도 세밀하게 분석할 수 있다.
이 논문은 perturbation의 이름만 미리 정하는 대신, 실제 성공 trajectory가 의존한 가정에서 변화를 만든다. 그래서 원래 문제를 푸는 실력과 가정이 깨진 뒤의 복구 능력을 비교하고, 변화를 발견하는 단계와 발견한 변화에 대응하는 단계를 나눠 분석할 수 있다.
핵심 아이디어
먼저 직관으로 이해하기
목표와 grader를 유지한 base–novel task pair를 만들고, 원래 전략이 기대던 조건 하나만 바꾼다. 기존 oracle이 실패하고 수정된 oracle은 성공하는지 검사해 단순히 불가능해진 task를 걸러낸다. 이후 base·novel 성능뿐 아니라 변화를 알려 준 disclosed 조건도 비교해 적응의 병목을 분석한다.
문제를 정의하는 변수와 지표
Terminal task: $\mathcal T=(I,E,G)$. $I$는 instruction, $E$는 실행 환경(주로 Docker container), $G$는 deterministic grader다. Trajectory는 $\tau=(o_0,r_1,a_1,o_1,\dots,r_T,a_T,o_T)$이다(r = reasoning, a = action, o = observation).
Environmental novelty: 성공 trajectory $\tau$가 의존하는 가정 집합 $\mathcal A(\tau,E)$에서 하나 $\alpha$를 골라, $E\to E’$로 바꿔 $\alpha$가 더는 성립하지 않게 만든다. 이때 목표와 성공 기준은 보존한다. 예: /workspace를 read-only로 만든다.
Adaptation = task-consistent recovery: 바뀐 조건에 맞게 전략을 고쳐 원래 task를 완수하는 것이다. 특정 복구 방법을 요구하지는 않는다. 위 예에서는 쓰기 권한을 복구해도 되고 다른 경로를 써도 된다. Agent는 novelty에 대해 아무 안내도 받지 않고 상호작용으로 스스로 발견해야 한다(autonomous setting).
세 가지 변형과 지표
\[\mathcal T_{\text{base}}=(I,E,G),\quad \mathcal T_{\text{novel}}=(I,E',G),\quad \mathcal T_{\text{disc}}=(I_{\text{disc}},E',G)\]- $I_{\text{disc}}$는 무엇이 바뀌었는지만 알려 주고 어떻게 대응할지는 알려 주지 않는다.
- Adaptation gap $\Delta_{\text{adapt}}=P_{\text{base}}-P_{\text{novel}}$: 클수록 novelty에 약하다. 다만 base 실력에 따라 달라지므로 base/novel 절대값과 함께 읽어야 한다고 저자들이 명시한다.
- Disclosure gain $\Delta_{\text{disc}}=P_{\text{disc}}-P_{\text{novel}}$: 변화를 “알게 되면” 회복되는 몫이다. 변화를 찾아내는 어려움과 알고 나서 대응하는 어려움을 분리하려는 지표다.
- Recovery fraction $\rho_{\text{rec}}=\Delta_{\text{disc}}/\Delta_{\text{adapt}}$.
AGNI 파이프라인
그림: Figure 1 개요
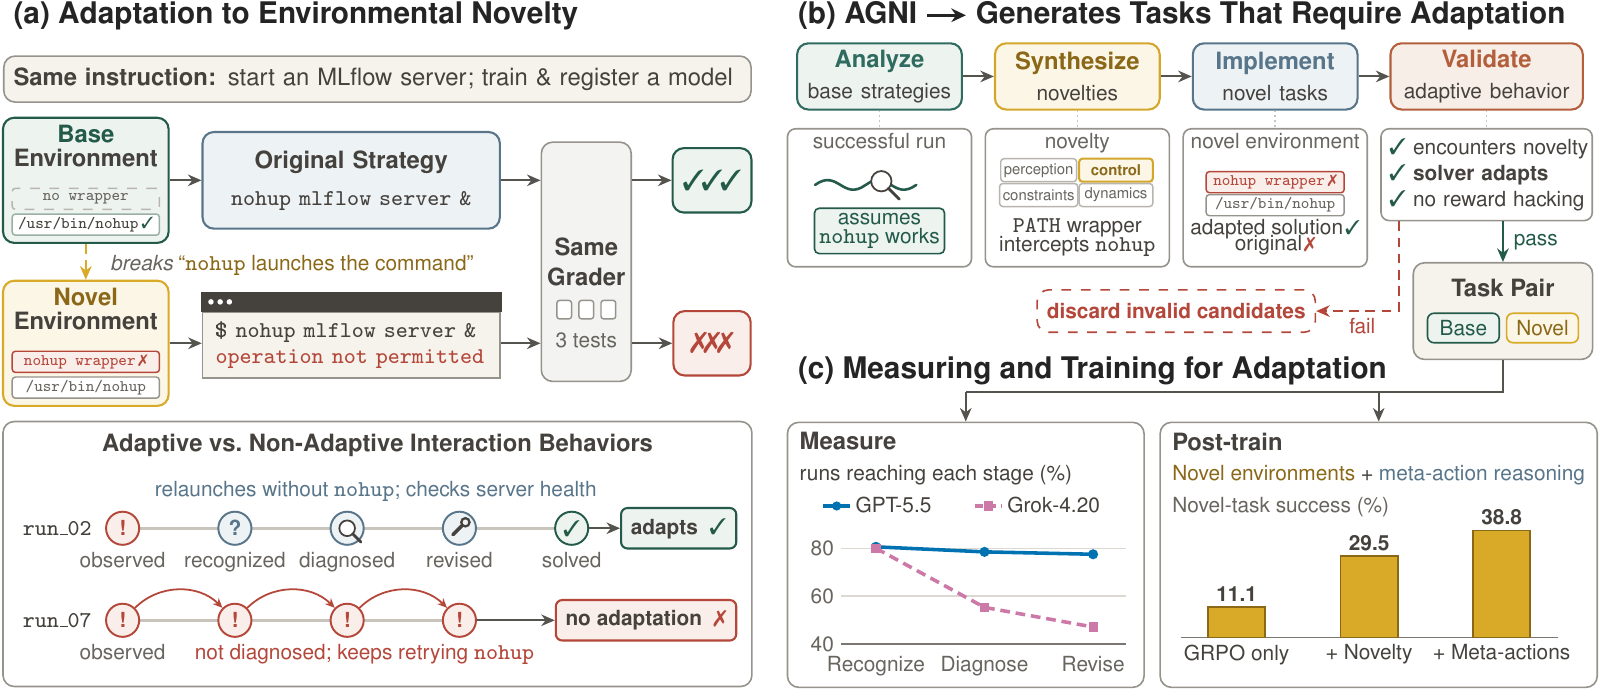
모든 LLM 역할은 GPT-5.5가 맡는다(solver는 high reasoning, 나머지는 medium). Solver의 능력이 남길 수 있는 task의 난이도 상한을 정하기 때문에 solver에 effort를 더 줬다(§4).
| 단계 | 하는 일 | 걸러내는 조건 |
|---|---|---|
| (a) Base 전략 분석 | Solver로 base task trajectory를 $K=8$개 샘플링한다. Analyzer가 oracle solution과 trajectory를 보고 사용 명령·도구·경로, 성공/실패 분기점, 환경 가정을 추출한다. 가정마다 진술, 근거, 왜 깨지기 쉬운지, 깨지면 무엇을 알아채야 하는지를 적는다. | 성공 trajectory가 하나도 없으면 버린다 |
| (b) Novelty 합성 | 4개 차원 중 해당하는 것을 고른다. Perception(무엇이 보이나: 자원의 존재·위치), Control(어떻게 행동하나: 도구·명령·인터페이스), Constraints(무엇이 허용되나: 권한·자원 한도·쓰기 가능 위치), Dynamics(환경이 어떻게 반응하나: 런타임·의존성 semantics). 차원당 후보를 $N_{\text{spec}}=5$개 생성한다. 이때 이전에 기각된 후보의 이력 $\mathcal H_d$를 함께 준다. | 구현 가능성과 예상 행동 변화(각 1–5점)로 필터링하고 중복을 제거한다 |
| (c) 구현·검증 | $E’$와 적응된 oracle $S’$를 생성한다(repair는 1회까지). instruction과 grader 수정은 금지한다. | $G(S’,E’)=1$(풀 수 있음), $G(S,E’)=0$(원래 전략은 무효), solver가 $E’$에서 K개 중 1개 이상 성공 |
| (d) 적응 행동 검증 | Observer가 base/novel 성공 trajectory를 비교해 의도한 행동 변화가 있는지 본다. Trajectory analyzer가 step 단위로 적응 여부와 reward hacking을 판정한다. | 성공 trajectory는 모두 적응 증거가 있어야 한다. reward hacking 시도가 하나라도 보이면(실패한 trajectory여도) 기각한다 |
- Base task당 최대 $N_{\text{keep}}=8$개 variant를 남긴다. Solver harness는 Terminus-2(Harbor 0.6.6), 최대 32 turn이다(Table 5, 부록 C.1).
- 평가셋 큐레이션(부록 C.6): base 난이도, 상대 난이도 $\delta=(P_{\text{base}}-P_{\text{novel}})/P_{\text{base}}$, 발생 개연성(occurrence plausibility), 구현 충실도(realization fidelity), mechanism family로 joint stratification해서 샘플링한다. 난이도는 GPT-5.4-mini와 Ministral-14B로 추정했다. GPT-5.4-mini만으로는 ET base가 1.0인 task가 많아 spread가 부족했기 때문이다.
- 최종 규모: 학습용 ET 4,000 pair, 평가용 ET-eval 140 / TB-Lite 118 / TB-2 87 pair.
- Realism(부록 D, Table 16): GPT-5.5 judge가 1–5점으로 채점했다. 최종 345 pair 기준 개연성 평균 3.77(4점 이상 72%), 충실도 평균 4.44(4점 이상 87%)다. 이 점수는 acceptance에는 쓰이지 않고 stratification에만 쓰였다.
Novelty 예시 (부록 C.7, Table 7–14)
| # | 출처 / task | 깨진 가정 | 적응한 run | 적응 못 한 run |
|---|---|---|---|---|
| 1 | TB-Lite mlflow-register | nohup으로 서버를 띄울 수 있다 → /usr/local/bin/nohup wrapper가 막음 | 로그에서 nohup이 원인임을 찾아 python3 -m mlflow server … &로 직접 실행, health 체크 | nohup 재시도 반복 |
| 2 | TB-Lite log-summary | 로그가 UTF-8이다 → UTF-16LE로 저장 | (GPT-5.4-mini) 0이라는 결과를 의심하고 바이트를 확인해 UTF-16으로 디코딩 | (GPT-5.5) grep 반복, “단어가 없다”고 결론 |
| 3 | TB-Lite crypto verifier | 스크립트를 직접 실행할 수 있다 → shebang에 \r 추가 | bash script.sh로 우회 | – |
| 4 | TB-Lite broken-python | pip가 index를 검색한다 → /etc/pip.conf에 no-index = true | 설정을 찾아 제거 | Python 버전 탓으로 보고 완료 선언 |
| 5–8 | ET / TB-2 | TAR_OPTIONS로 경로 prefix 추가, CSV 헤더 중복, SPRING_DATASOURCE_URL override, git rerere로 옛 결정 재사용 |
실험과 핵심 결과
실험 설정
| 축 | 내용 |
|---|---|
| 모델 | GPT-5.5(high), GPT-5.4-mini(high), Kimi-2.6(default), DeepSeek-V4-Flash(None), GPT-OSS-120B(default), Grok-4.20(non-reasoning), Mistral-Large-3 |
| Harness | Terminus-2 고정, 최대 32 turn, 응답당 8,192 token |
| 샘플링 | model–task당 $K=5$ rollout, temperature/top-p는 기본값, seed 없음 |
| 지표 | pass@1, $\Delta_{\text{adapt}}$, $\rho_{\text{rec}}$, interact@1, 단계별 도달률 |
Finding 1. Curated novelty는 다른 모델의 전략에도 걸린다 (Q5.1, 부록 E.2, Table 19)
- 가정은 GPT-5.5의 trajectory에서 뽑았으니 다른 모델에는 무관할 수 있다는 우려가 있었다. 그런데 novel rollout 중 바뀐 구성요소를 실제로 건드린 비율(interact@1)이 세 평가셋 모두 90.7–99.0%였다. novelty를 우회해 성공한 비율(bypass@1)은 ≤ 2.7%였다.
Finding 2. Novelty는 모든 모델에서 성능을 크게 깎고, base 순위는 적응 순위를 예측하지 못한다 (Q5.2, Table 1)
| 모델 | ET Base | ET Novel | ET Δ | TB-Lite Base | TB-Lite Novel | TB-Lite Δ | TB-2 Base | TB-2 Novel | TB-2 Δ |
|---|---|---|---|---|---|---|---|---|---|
| GPT-5.5 | 97.0 | 74.5 | 22.5 | 93.2 | 71.7 | 21.5 | 88.8 | 79.7 | 9.1 |
| GPT-5.4-mini | 94.5 | 61.9 | 32.6 | 65.0 | 39.5 | 25.5 | 75.9 | 46.6 | 29.3 |
| Kimi-2.6 | 92.7 | 74.7 | 18.0 | 83.6 | 58.3 | 25.3 | 73.8 | 61.4 | 12.4 |
| DeepSeek-V4-Flash | 89.4 | 74.2 | 15.1 | 70.2 | 49.3 | 20.8 | 66.0 | 54.0 | 12.0 |
| GPT-OSS-120B | 78.6 | 29.4 | 49.2 | 52.7 | 17.6 | 35.1 | 28.0 | 13.3 | 14.7 |
| Grok-4.20 | 71.9 | 35.5 | 36.4 | 48.3 | 16.6 | 31.7 | 40.0 | 16.6 | 23.4 |
| Mistral-Large-3 | 64.5 | 23.6 | 40.9 | 32.4 | 10.3 | 22.1 | 21.1 | 6.9 | 14.3 |
| 평균 | 84.1 | 53.4 | 30.7 | 63.6 | 37.6 | 26.0 | 56.2 | 39.8 | 16.5 |
- 순위 역전: ET에서 GPT-5.4-mini는 base 94.5%로 Kimi-2.6(92.7)과 DeepSeek-V4-Flash(89.4)보다 높다. 그런데 novel에서는 61.9%로, 74.7%와 74.2%인 두 모델보다 크게 낮다. GPT-OSS-120B와 Grok-4.20도 base(78.6 vs 71.9)와 novel(29.4 vs 35.5)에서 순서가 뒤집힌다. base 대비로 정규화해도 역전은 유지된다고 한다.
- 저자들의 결론: base 환경 성능은 적응 능력을 과대평가할 수 있다.
Finding 3. Reasoning effort는 대체로 도움이 되지만 모델에 따라 다르다 (Q5.3, Table 2, ET-eval)
| 모델 | Effort | Base | Novel | Δ |
|---|---|---|---|---|
| GPT-5.4-mini | Low / Med / High | 85.4 / 91.4 / 94.5 | 41.5 / 53.8 / 61.9 | 44.0 / 37.6 / 32.6 |
| GPT-OSS-120B | Low / Med / High | 75.0 / 78.6 / 84.2 | 22.2 / 29.4 / 35.3 | 52.8 / 49.2 / 48.9 |
| Kimi-2.6 | None / Low / Med / High | 83.0 / 90.1 / 92.7 / 91.8 | 65.5 / 72.7 / 74.7 / 70.8 | 17.6 / 17.4 / 18.0 / 21.0 |
- Low에서 High로 올리면 novel이 GPT-5.4-mini는 +20.4%p, GPT-OSS-120B는 +13.1%p 오르고 gap도 줄어든다.
- Kimi-2.6은 비단조적이다. novel은 medium에서 최고, gap은 low에서 최소다. 저자들은 overthinking 문헌과 일치한다고 해석한다.
Finding 4. 무엇이 바뀌었는지 알려 주면 gap의 약 72%가 회복된다 (Q5.4, Figure 3, ET-eval)
그림: cross_model_adaptation_bars.pdf
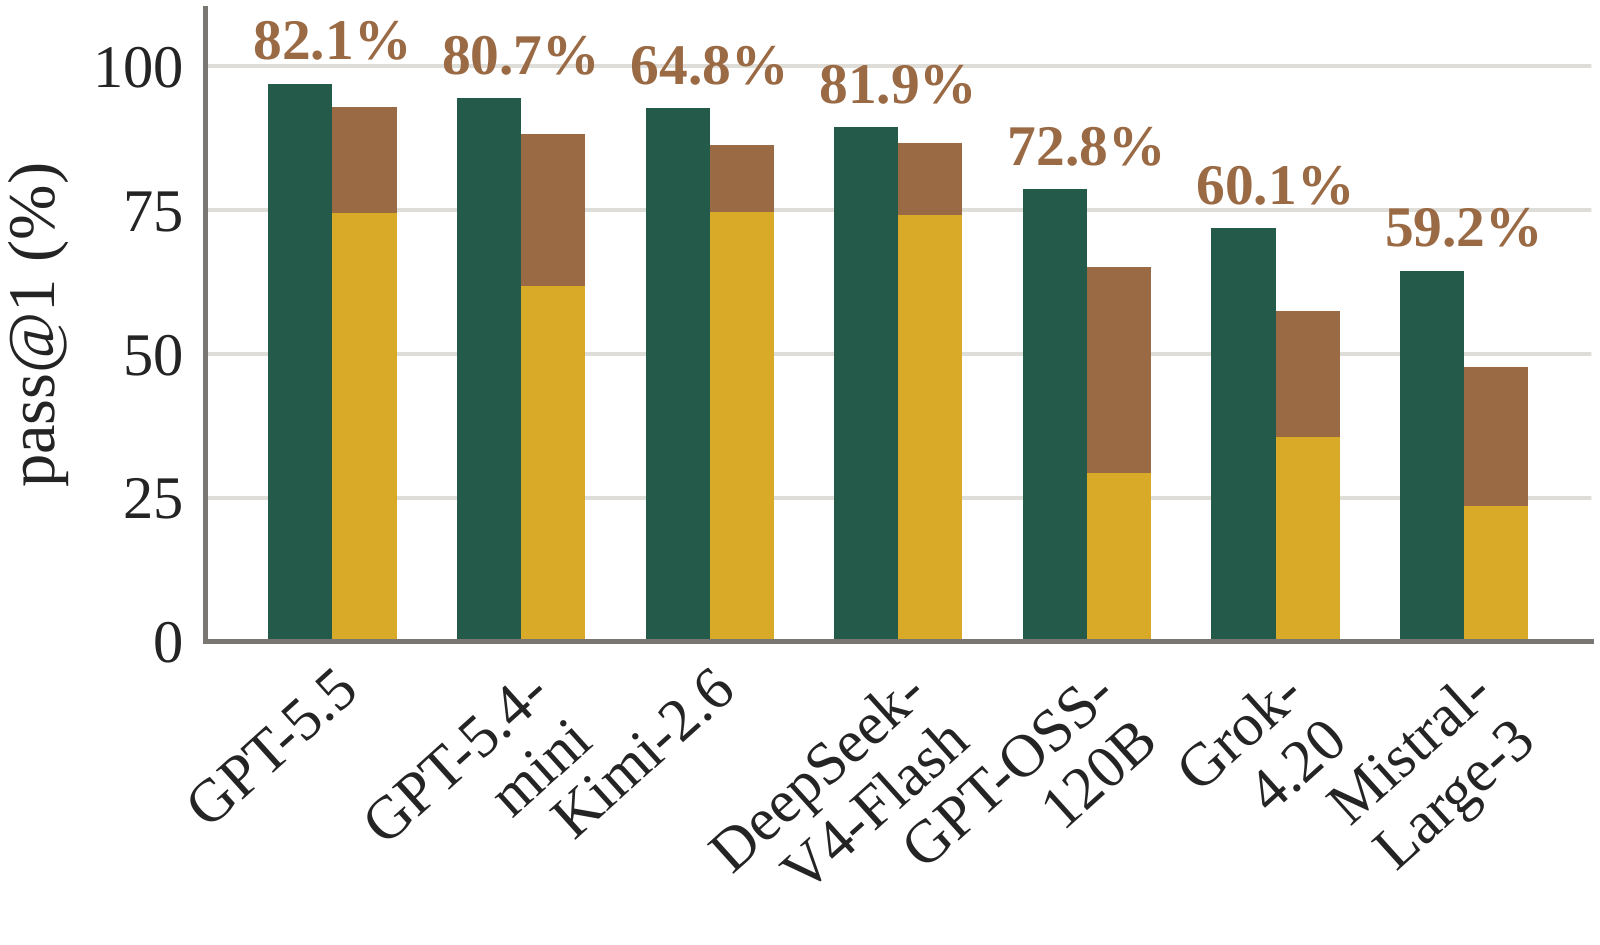
- 모든 모델에서 disclosure가 성능을 올린다. 평균 $\rho_{\text{rec}}$ = 71.7%, 범위는 59.2–82.1%다.
- 모델별 $\rho_{\text{rec}}$(그림 라벨): GPT-5.5 82.1%, GPT-5.4-mini 80.7%, Kimi-2.6 64.8%, DeepSeek-V4-Flash 81.9%, GPT-OSS-120B 72.8%, Grok-4.20 60.1%, Mistral-Large-3 59.2%.
- 저자들이 강조하는 점은 두 가지다. 이 설정은 adaptation 자체를 재는 것이 아니라 변화를 알 때 회복 가능한 몫을 잰다. 그리고 남는 ~28%는 알고 있어도 실행이 어려운 부분이다. 또 undisclosed 상태에서의 하락이 “변화를 못 봤다”는 뜻은 아니다(→ Finding 5).
Finding 5. 갈림길은 “인식”이 아니라 “진단 → 전략 수정” (Q5.5, Figure 4, Table 20–22)
그림: turns_split_violin.pdf, behavior_funnel.pdf
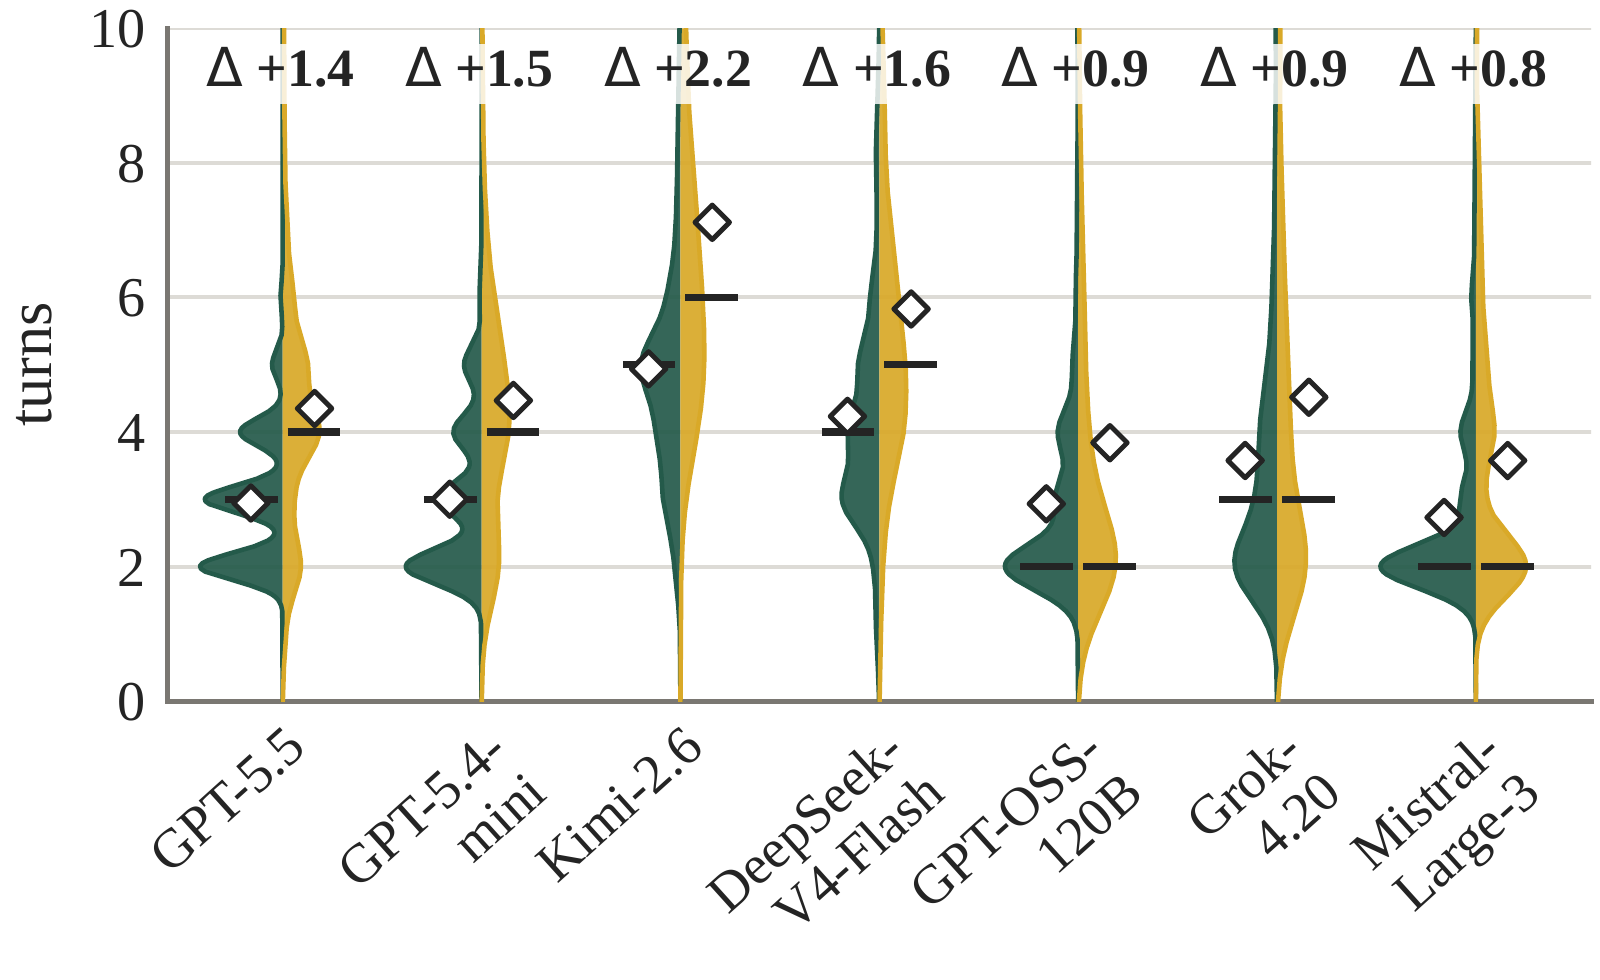
(a) 상호작용 길이: 모든 모델이 novel에서 더 오래 상호작용한다. 평균 추가 turn은 강한 적응자(GPT-5.5 +1.4, Kimi-2.6 +2.2, DeepSeek-V4-Flash +1.6)가 1.4–2.2이고, 약한 적응자(GPT-OSS-120B +0.9, Grok-4.20 +0.9, Mistral-Large-3 +0.8)는 1 미만이다. GPT-5.4-mini는 +1.5다.
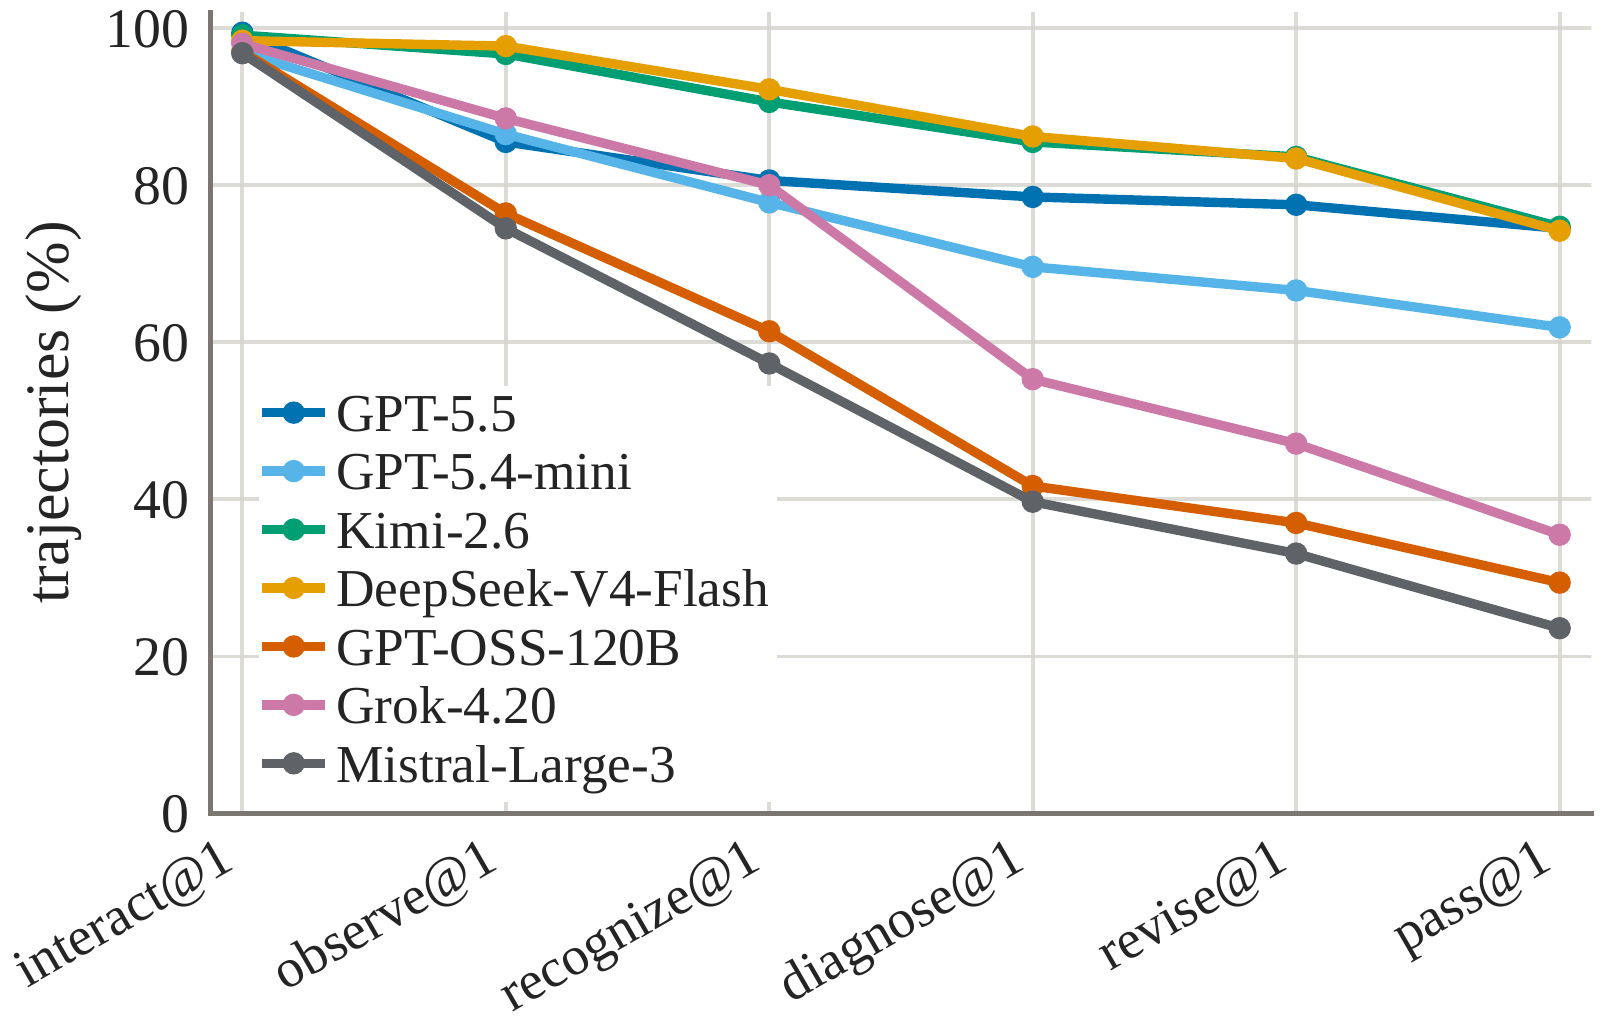
(b) 단계별 funnel: GPT-5.5 judge가 novel trajectory의 각 turn에 단계를 붙였다. 단계는 interacted → observed → recognized → diagnosed → revised → solved 순이다(정의는 부록 E.4 Table 21, 라벨링 절차는 부록 F).
- GPT-5.5와 Grok-4.20은 recognize 비율이 거의 같다(80.6% vs 80.0%). 차이는 그 다음에 벌어진다. diagnose는 78.5% vs 55.3%, revise는 77.5% vs 47.1%다.
- 그림에서 읽은 값으로는 Kimi-2.6과 DeepSeek-V4-Flash가 observe ~97%, diagnose ~86%로 GPT-5.5보다 앞 단계 도달률이 높다. 반면 GPT-OSS-120B와 Mistral-Large-3는 observe 단계부터 ~75%로 떨어진다.
(c) 재시도와 조기 종료 (Table 20, 22, ET-eval):
| 모델 | Retry 경험 비율 | Retry 지속성 $P(\text{Retry}_{t+1}\mid\text{Retry}_t)$ | Diag→Rev | Diag→Retry | Premature Done | Pass|Rev+Diag | Pass|Rev w/o Diag |
|---|---|---|---|---|---|---|---|
| GPT-5.5 | 9.8 | 9 | 71 | 5 | 14 | 96 | 68 |
| Kimi-2.6 | 18.1 | 6 | 41 | 4 | 11 | 87 | 50 |
| DeepSeek-V4-Flash | 17.4 | 10 | 47 | 5 | 12 | 86 | 70 |
| GPT-5.4-mini | 15.2 | 50 | 57 | 11 | 20 | 86 | 59 |
| GPT-OSS-120B | 27.8 | 40 | 30 | 10 | 21 | 64 | 22 |
| Grok-4.20 | 40.7 | 45 | 31 | 14 | 16 | 64 | 20 |
| Mistral-Large-3 | 28.1 | 35 | 27 | 17 | 31 | 57 | 16 |
- 약한 적응자는 실패한 접근을 더 자주, 더 끈질기게 반복한다. 약한 모델일수록 실패나 부분 성공 직후 바로 종료하는 경향도 강하다(Mistral 31%).
- 모든 모델에서 진단을 거친 revise가 진단 없는 revise보다 성공률이 높다. 예: GPT-5.5 96 vs 68, Mistral 57 vs 16.
Finding 6. 일반 agentic post-training은 절대 성능은 올리지만 gap은 줄이지 못한다 (Q6.1, Figure 5, Figure 8, 부록 G)
설정(§6, 부록 G, Table 23): Qwen3-8B와 Qwen3-14B를 쓴다. ET에서 서로 겹치지 않는 4,000 task 집합 $T_1, T_2$를 만들고, AGNI로 $T_1$의 novel 버전 $T_1’$를 생성했다.
\[D_{\text{clean}}=T_1\cup T_2,\quad D_{\text{novel-unpaired}}=T_2\cup T_1',\quad D_{\text{novel-paired}}=T_1\cup T_1'\]- 세 데이터셋은 크기가 같다. 평가 task는 학습과 겹치지 않는다. checkpoint는 별도의 ET base task 100개로 고른다.
- 하이퍼파라미터는 ECHO 논문을 따른다. lr 1e-6, batch 16, prompt당 rollout 16, KL 없음, clip 0.2/0.28, 학습 시 최대 16 turn과 16k context, 8B는 최대 500 step, 14B는 최대 300 step.
- ECHO는 GRPO에 terminal output 예측 auxiliary loss($\lambda=0.05$)를 더해 world model을 학습하는 방법이다. 공저자 Shrivastava가 1저자인 선행 연구다.
그림: posttraining_q1_bars.pdf, 14B
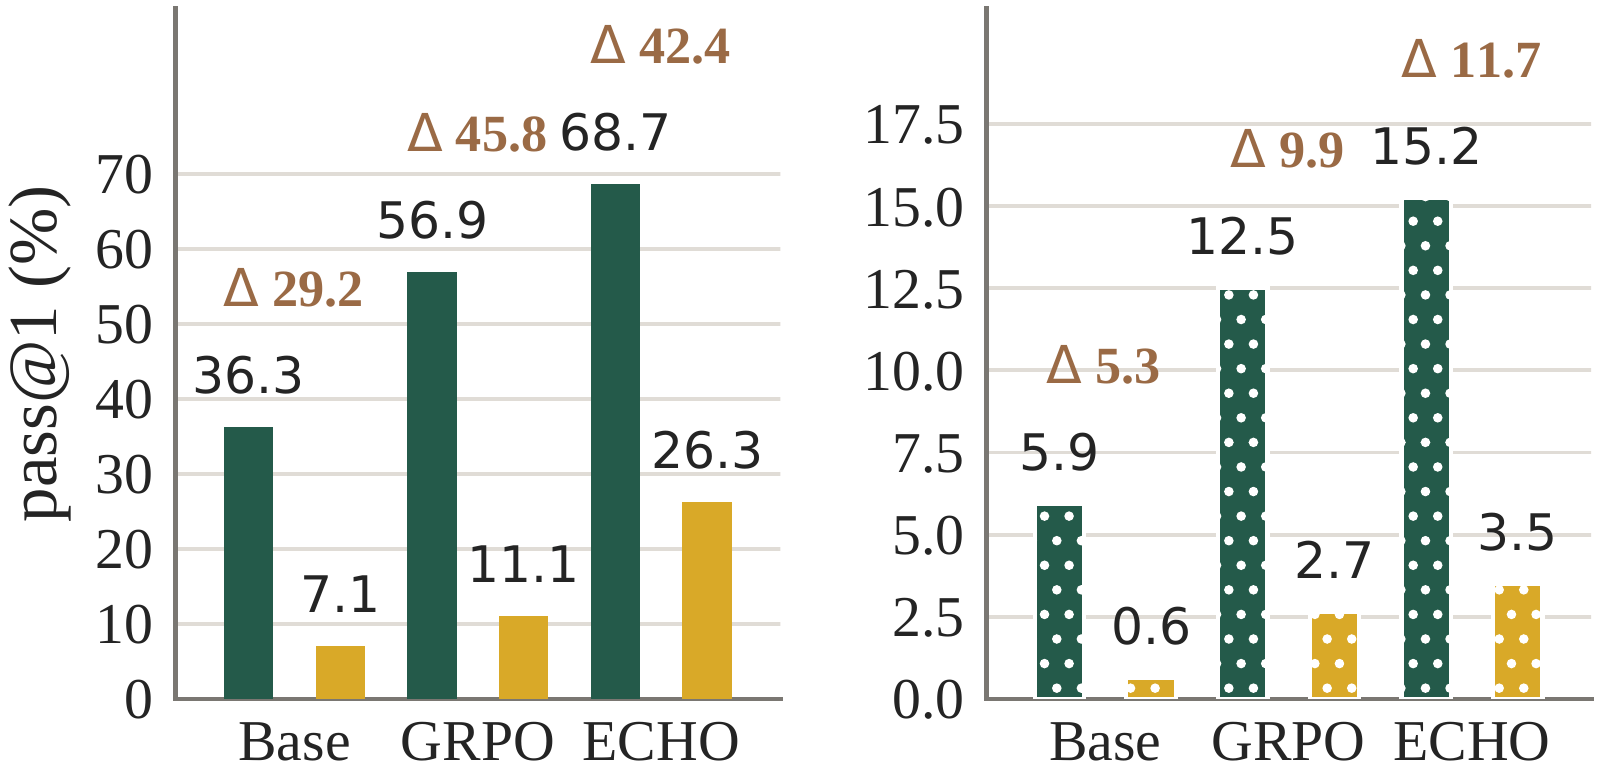
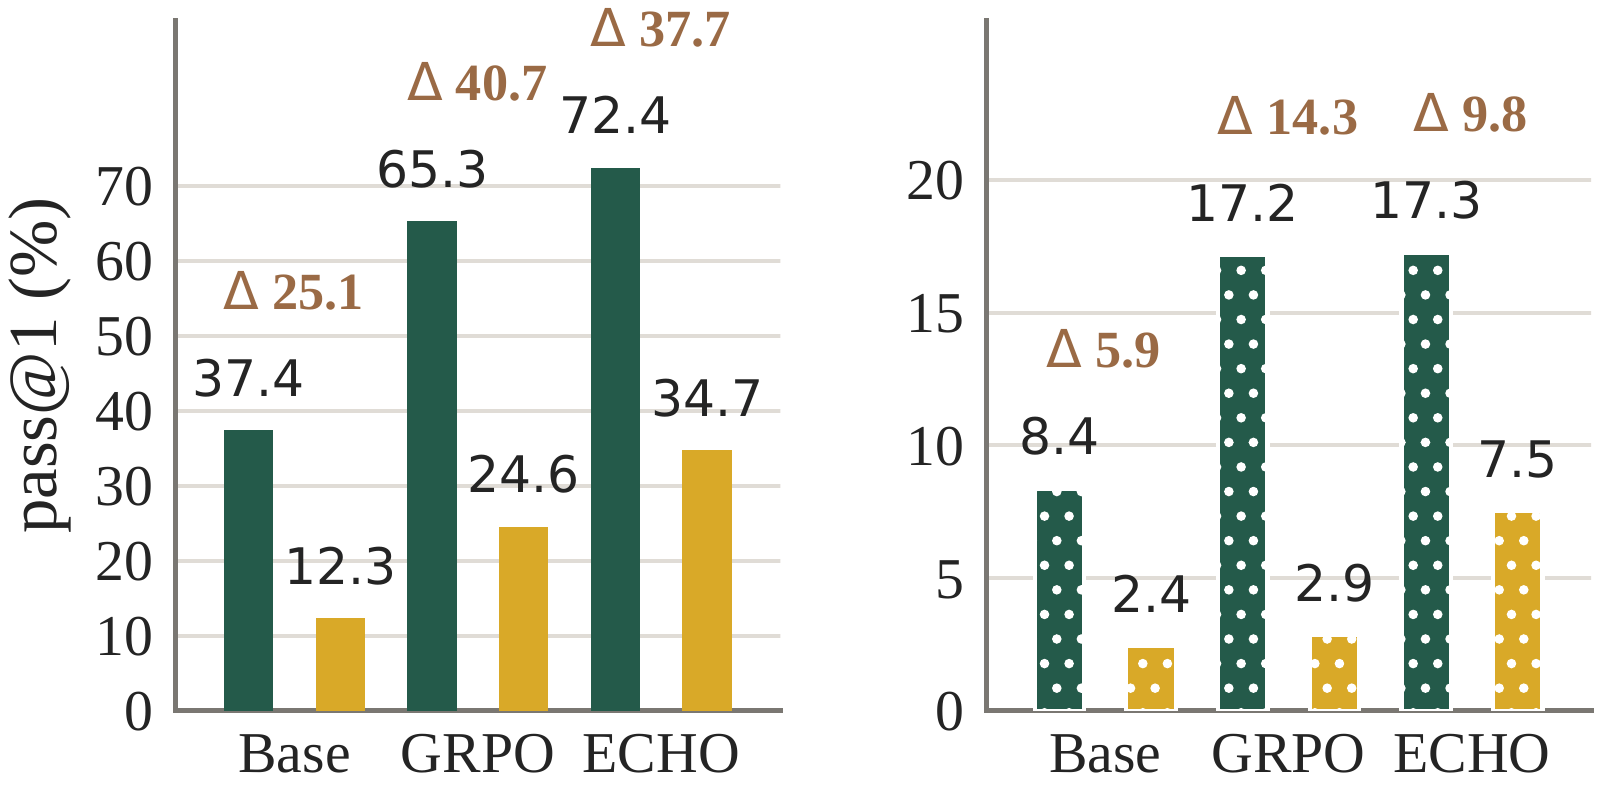
| 모델 | 방법 | ET Base | ET Novel | ET Δ | TB-Lite Base | TB-Lite Novel | TB-Lite Δ |
|---|---|---|---|---|---|---|---|
| Qwen3-8B | 학습 전 | 36.3 | 7.1 | 29.2 | 5.9 | 0.6 | 5.3 |
| Qwen3-8B | GRPO (clean) | 56.9 | 11.1 | 45.8 | 12.5 | 2.7 | 9.9 |
| Qwen3-8B | ECHO (clean) | 68.7 | 26.3 | 42.4 | 15.2 | 3.5 | 11.7 |
| Qwen3-14B | 학습 전 | 37.4 | 12.3 | 25.1 | 8.4 | 2.4 | 5.9 |
| Qwen3-14B | GRPO (clean) | 65.3 | 24.6 | 40.7 | 17.2 | 2.9 | 14.3 |
| Qwen3-14B | ECHO (clean) | 72.4 | 34.7 | 37.7 | 17.3 | 7.5 | 9.8 |
- Base가 novel보다 훨씬 많이 올라 gap이 오히려 커진다(8B ET 29.2 → 45.8 / 42.4).
Finding 7. Novelty-augmented 데이터는 base를 유지하면서 novel을 크게 올린다 (Q6.2, Figure 6)
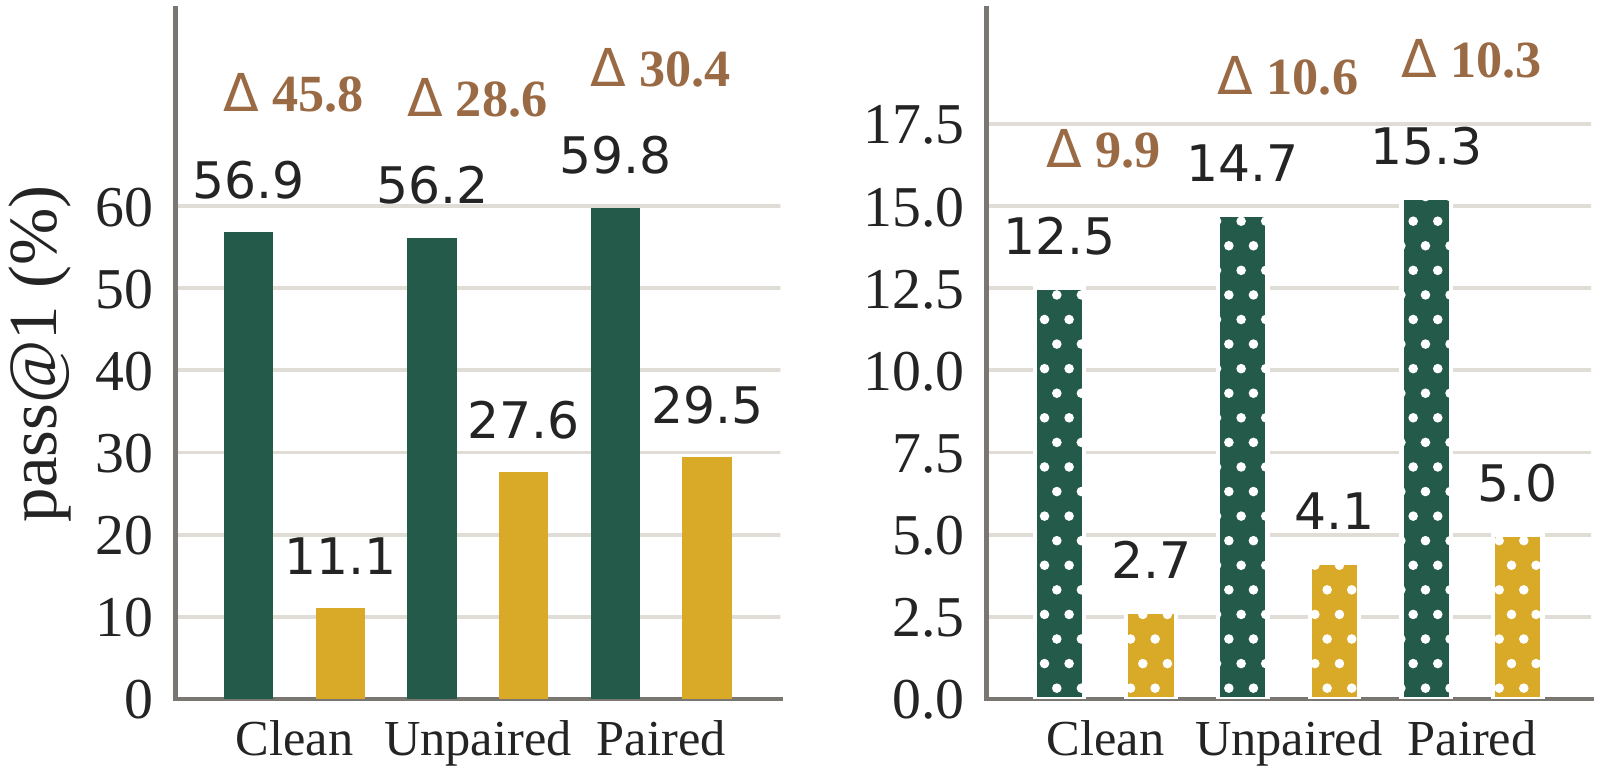
| Qwen3-8B GRPO | ET Base | ET Novel | ET Δ | TB-Lite Base | TB-Lite Novel | TB-Lite Δ |
|---|---|---|---|---|---|---|
| Clean | 56.9 | 11.1 | 45.8 | 12.5 | 2.7 | 9.9 |
| Novel-unpaired | 56.2 | 27.6 | 28.6 | 14.7 | 4.1 | 10.6 |
| Novel-paired | 59.8 | 29.5 | 30.4 | 15.3 | 5.0 | 10.3 |
- Unpaired는 base를 거의 그대로 둔 채 novel을 11.1 → 27.6으로 올린다. Paired는 novel(29.5)과 base(59.8)가 모두 가장 높지만 gap은 unpaired보다 약간 크다.
- 저자들의 해석: 같은 task를 두 환경에서 보여 주는 paired 대비가 “언제 환경 변화 때문에 전략을 바꿔야 하는지”를 배우는 데 도움이 될 수 있다(may).
- Qwen3-14B(Table 24)도 clean → paired에서 ET novel이 24.6 → 35.5, TB-Lite novel이 2.9 → 5.5로 오른다.
Finding 8. Meta-action 추론은 효과가 있고, process reward는 행동만 바꾼다 (Q6.3, Table 3, Figure 7)
META prompt(부록 G.4): bash tool에 필수 필드 meta_action ∈ {EXECUTE, INSPECT, DIAGNOSE, REVISE, VERIFY}를 추가한다. <think>에서 meta-action을 먼저 정하고 그에 맞는 명령을 고르도록 지시하며, 언제 각 값을 쓰는지 설명도 붙인다. 모든 실험은 Qwen3-8B, $D_{\text{novel-paired}}$이고 ET-eval novel은 pair당 8 rollout이다.
| 방법 | Base | Novel | Δ |
|---|---|---|---|
| GRPO on $D_{\text{novel-paired}}$ | 59.82 | 29.46 | 30.36 |
| + META prompt (추론 시에만) | 61.25 | 32.59 | 28.66 |
| + META prompt로 학습 (outcome reward만) | 64.29 | 37.86 | 26.43 |
| + Recovery & Verify reward | 69.55 | 38.00 | 31.55 |
| + Diagnosed Exploration reward | 53.93 | 25.14 | 28.79 |
| + Exploration & Completion reward | 66.96 | 38.80 | 28.16 |
- Process reward 설계(부록 G.3): $R=r+S$이며 $r$은 0/1 task reward다. 실패한 rollout에서는 credit의 25%만 준다.
- Recovery & Verify: 실패 후 DIAGNOSE/REVISE 태그를 달고 같은 명령이 성공하면 +0.1, 마지막 변경 이후 read-only VERIFY를 하면 +0.1.
- Diagnosed Exploration: 실패 후 새로운 mutating fix마다 +0.1(최대 2회). 명령이 실패하면 −0.05, 같은 명령을 반복하면 −0.05.
- Exploration & Completion: Diagnosed Exploration에 더해, 성공했을 때에 한해 마지막 변경 후 검증하면 +0.2,
done을 부르면 +0.1.
- 행동 변화(Figure 7, 1,120 rollout/arm, posttraining_q3_behavior.pdf):
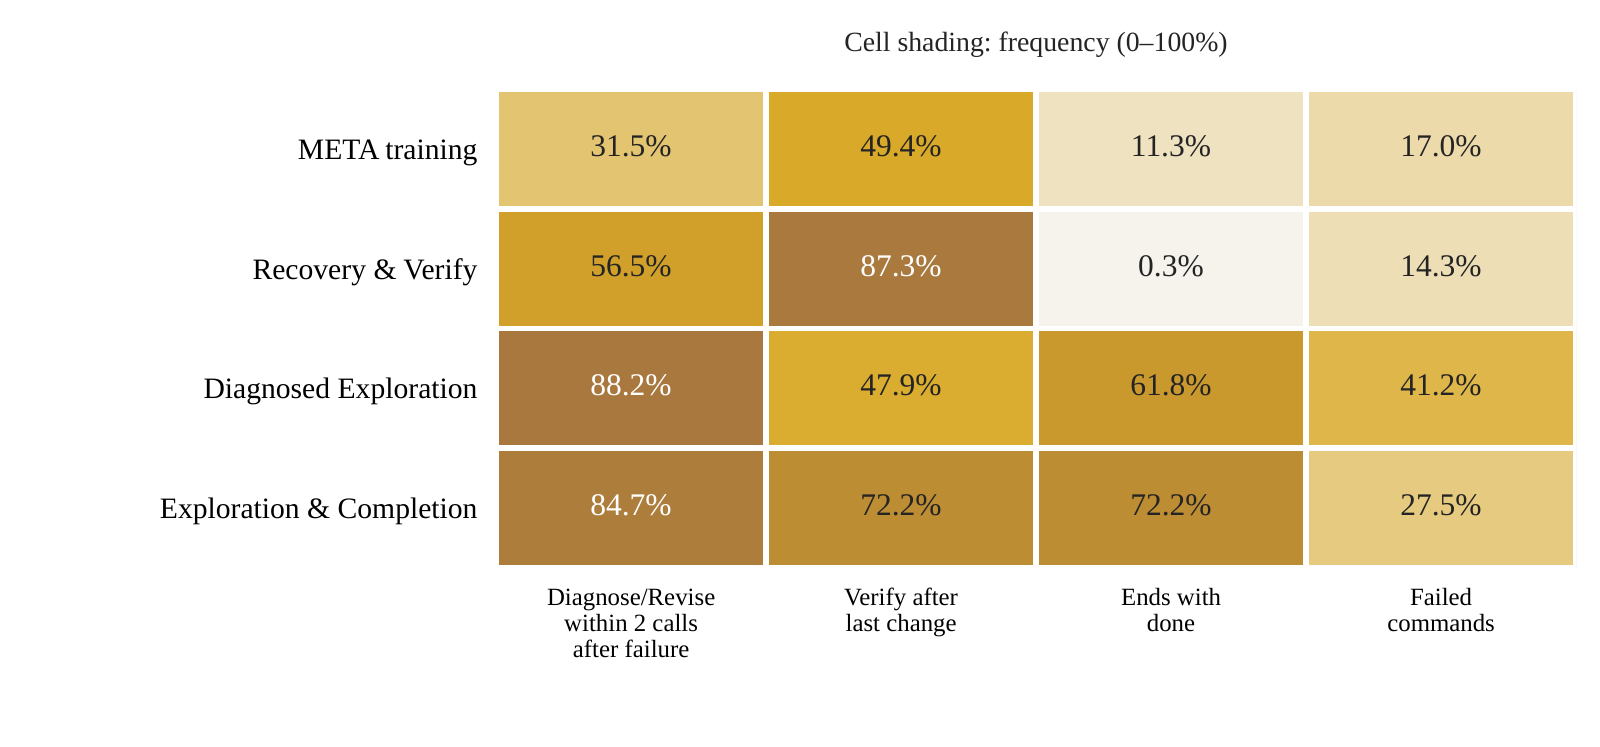
| arm | 실패 후 2 call 내 Diagnose/Revise | 마지막 변경 후 Verify | done으로 종료 | 실패한 명령 비율 |
|---|---|---|---|---|
| META 학습 | 31.5% | 49.4% | 11.3% | 17.0% |
| Recovery & Verify | 56.5% | 87.3% | 0.3% | 14.3% |
| Diagnosed Exploration | 88.2% | 47.9% | 61.8% | 41.2% |
| Exploration & Completion | 84.7% | 72.2% | 72.2% | 27.5% |
- Reward는 겨냥한 행동을 크게 바꾼다. 하지만 novel pass@1 향상은 미미하거나(+0.14, +0.94%p) 오히려 하락한다(Diagnosed Exploration −12.7%p). Diagnosed Exploration은 “fix를 시도”하는 행동을 늘리면서 실패한 명령 비율도 2.4배로 늘렸다.
- 저자들도 이 reward가 관찰 가능한 명령 패턴에 주는 것이지, 진단이 맞았는지를 판단하는 것은 아니라고 밝힌다.
한계와 해석
저자들이 밝힌 한계
- 이 평가는 제한된 형태의 적응만 잰다. terminal task에서 curated된 단일 환경 변화로부터 회복하는 능력이다. 여러 변화가 동시에 일어나는 경우, 매우 긴 horizon, open-ended 배포 환경에서의 신뢰성은 보여 주지 않는다. 측정된 실패율도 이 단순한 테스트에서의 수치일 뿐이다.
- LLM으로 환경을 큐레이션하고 평가했기 때문에 체크로 다 걸러지지 않는 bias가 있을 수 있다.
- 계산 비용 때문에 post-training은 모델 2개, 제한된 설정에서만 했다.
- 더 넓은 방향: 사용자가 실행 방법까지 위임하는 만큼, 성공 여부뿐 아니라 실행 과정의 전략과 행동(자원 효율, 안전)을 평가해야 한다. AGNI 같은 파이프라인을 honeypot 접근 경계 준수, 불확실성 아래 대안 전략 고려, 반증이 쌓일 때 전략 포기 같은 행동을 시험하는 데로 확장할 수 있다.
- Ethics(부록 A.2): 적응 능력이 좋아지면 오용 가능성도 커진다. 생성된 환경과 명령은 격리해서 실행해야 한다.
AI의 해석
이하는 논문의 주장이 아니라 정리자의 해석과 검산이다. 수치 검산 결과, Table 1–3의 평균과 Δ, 본문의 모든 차이값은 반올림 오차(≤0.1) 안에서 일치했다.
- 평가셋 구성에 쓰인 모델이 평가 대상이기도 하다.
- GPT-5.5는 AGNI의 solver, analyzer, judge를 모두 맡는다. novel task는 “GPT-5.5가 8번 중 1번 이상 풀었다”는 조건을 통과한 것만 남는다. 그래서 평가셋 난이도의 상한이 GPT-5.5 능력에 맞춰져 있고, GPT-5.5의 novel 점수(특히 TB-2의 Δ 9.1)는 구조적으로 유리할 수 있다.
- GPT-5.4-mini는 평가셋 stratification에서 $P_{\text{base}}$와 $\delta$를 추정하는 sampler였다(부록 C.6). 자기 점수로 “novelty 난이도 low/med/high”를 균형 맞춰 뽑은 셋에서 다시 평가된 것이다. 후보 pool에 GPT-5.4-mini가 쉽게 푸는 pair가 많았다면, 균형 샘플링이 GPT-5.4-mini에게만 어려운 pair를 상대적으로 더 뽑았을 수 있다. Finding 2의 대표 사례인 “GPT-5.4-mini 순위 역전”은 이 선택 효과와 분리해서 봐야 한다. 단, GPT-5.4-mini는 retry 지속성(50%)이 가장 높아 행동 분석과는 일관된다.
- Funnel 비교에 reasoning 모드 차이가 섞여 있다. Grok-4.20은 non-reasoning, DeepSeek-V4-Flash는 None effort로 평가됐고 GPT-5.5는 high다(Table 17). “recognize는 같은데 diagnose가 다르다”는 비교(GPT-5.5 vs Grok)는 모델 고유 능력과 test-time reasoning 유무가 섞인 결과다. 또 judge는 “가시적 reasoning이나 명령으로 뒷받침될 때만” 단계를 인정한다. 그래서 reasoning을 덜 드러내는 모드가 diagnose를 과소 라벨링받을 위험이 있다. 반대로 None 모드인 DeepSeek이 높은 단계 도달률을 보인 점은 이 우려를 일부 덜어 준다.
- GPT-5.5가 GPT-5.5 trajectory를 채점한다. 단계 라벨링 judge가 평가 대상 모델과 같다. 사람이 라벨링한 subset이나 judge 간 일치도는 보고되지 않았다.
- Post-training의 “held-out”은 task 수준이지 novelty 유형 수준이 아니다. $T_1’$와 ET-eval은 같은 생성기(AGNI)와 같은 4개 차원, mechanism family에서 나온다. ET-eval에서 novel이 2.7배(11.1 → 29.5)로 오른 것에는 “AGNI가 만드는 novelty의 분포”를 학습한 효과가 섞였을 수 있다. 더 정직한 전이 테스트인 TB-Lite에서는 novel이 2.7 → 5.0%p로 절대값이 매우 작고, gap은 오히려 9.9 → 10.3–10.6으로 약간 늘었다. “gains transfer”는 novel pass@1의 상대 상승에 대한 말이다. 그리고 seed 반복이나 신뢰구간이 없다(118 pair × 5 rollout에서 2%p 차이).
- META 효과의 원인이 분리되지 않았다. META prompt는 라벨 필드만 추가한 것이 아니다. “실패하면 DIAGNOSE, 접근이 막히면 REVISE, 중요한 결과는 VERIFY” 같은 행동 지침도 함께 넣었다. 개선이 intent를 명시적으로 추론해서인지, 지침이 담긴 prompt 덕분인지 알려면 “지침만 있고 필드는 없는” 대조군이 필요하다. 또 Figure 1(c)의 “+ Meta-actions 38.8”은 META 학습(37.86)이 아니라 Exploration & Completion process reward arm의 수치다.
- Process reward의 base 쪽 신호를 보면: Recovery & Verify는 novel은 그대로인데 base는 64.29 → 69.55로 가장 크게 올렸고, 이 arm은
done을 거의 부르지 않는다(0.3%). 💭 검증 행동은 base에 도움이 되지만, novel에서 막히는 지점(진단의 정확성)은 패턴 기반 reward로는 건드리지 못한다는 해석과 맞는다. 저자 결론(“행동은 바뀌나 적응 향상은 제한적”)은 타당해 보인다. - Novelty 유형별 분석이 없다. Perception/Control/Constraints/Dynamics 차원별 gap, mechanism family별 gap이 보고되지 않았다. 부록 예시 2(UTF-16)처럼 명령은 성공하지만 결과가 틀리는 verification-dependent novelty와 에러가 나는 novelty는 성격이 다를 것이다. 저자들도 부록 F에서 이 구분을 정의만 하고 따로 수치화하지는 않았다.
- “적응” 정의는 관대하다. Read-only 디렉터리의 쓰기 권한을 복구하는 것도 적응으로 인정한다. 실제 배포에서는 환경을 고치는 것이 허용되지 않거나 위험할 수 있다(예: 시스템 pip.conf 수정). 저자들도 §7에서 안전과 행동 평가를 별도 축으로 언급하지만, 현재 지표는 “환경을 바꿔서라도 통과”와 “제약을 존중하며 우회”를 구분하지 않는다. Reward hacking 필터는 grader 조작만 막는다.
💭 종합하면, 가장 견고한 기여는 “성공 trajectory의 가정을 깨는” 방식으로 통제된 base–novel pair를 대량 생성하는 방법론과 “인식은 같아도 진단/수정에서 갈린다”는 trajectory 분석으로 보인다. 모델 순위 역전과 post-training 전이 결과는 흥미롭지만, 평가셋 구성 모델과 평가 대상의 겹침, 분산 미보고, TB-Lite의 작은 절대값 때문에 정량적 주장으로는 한 단계 약하다.
더 생각해볼 질문
아래는 AI가 정리 과정에서 제안한 후속 질문입니다. 본인이 직접 작성한 의견이나 논문에서 검증한 결과로 표시하지 않습니다.
- Generalization Tax와의 연결: 이 논문은 Liu et al. 2026을 novelty-augmented training의 선행 연구로 인용한다(§1). 두 논문 저자 목록에 같은 이름(Asli Celikyilmaz)이 있다. 저쪽의 state augmentation은 goal과 무관한 distractor를 넣어 state 정보량을 바꾸고, 이쪽은 전략이 기대는 가정을 깨뜨린다. 둘 다 “학습 환경을 변형하면 OOD가 보존·향상된다”는 메시지인데, 변형의 목표 지향성(무작위 노이즈 vs 전략 표적형)이 효과 크기를 가르는지 비교해 볼 만하다. 또 저쪽 Finding 6(thinking을 끄면 OOD 붕괴)과 이쪽 Finding 3(reasoning effort가 대체로 적응을 도움)은 같은 방향이다.
- Agent Plasticity와의 연결: 저쪽은 여러 에피소드에 걸친 경험 기반 개선이고, 이쪽은 한 에피소드 안에서 가정이 깨졌을 때의 회복이다. “같은 novelty를 다시 만났을 때 artifact/메모리 덕분에 더 빨리 진단하는가”를 재면 두 축을 잇는 평가가 될 수 있다.
- 진단 정확성에 대한 reward: 패턴 기반 process reward가 실패한 이유가 “진단이 맞았는지”를 보지 않아서라면, AGNI가 이미 알고 있는 깨진 가정 $\alpha$를 정답으로 써서 진단 정확성에 reward를 주는 것이 자연스러운 다음 단계다(privileged information을 이용한 process reward).
- Disclosure 이후 남는 ~28%: 변화를 알려 줘도 못 푸는 부분은 순수 실행 능력 문제인가, 아니면 instruction의 우선순위 처리 문제인가? disclosed 조건에서의 trajectory 분석이 있으면 좋겠다.
- Multi-novelty·장기 horizon: 저자들이 한계로 든 “여러 변화 동시 발생”에서는 진단 단계가 훨씬 어려워질 것이다. 첫 번째 가정을 고친 뒤 두 번째 실패를 같은 원인으로 오진하는 패턴이 나타날까?
- 환경을 고치기 vs 우회하기: 적응 방식을 “환경 수정형”과 “전략 우회형”으로 나눠 라벨링하면, 안전 관점의 적응 품질 지표를 만들 수 있다.
참고자료
용어 정리
| 용어 | 뜻 |
|---|---|
| Environmental novelty | task 목표와 grader는 그대로 두고, 성공 trajectory가 의존하던 환경 가정 하나를 무효화하는 변화 |
| Adaptation (task-consistent recovery) | 바뀐 조건에 맞게 전략을 수정해 원래 task를 완수하는 것. 특정 복구 방법은 요구하지 않음 |
| AGNI | Assumption-Guided Novelty Injection. 가정 추출 → novelty 합성 → 구현·검증 → 적응 행동 검증 파이프라인 |
| Base / Novel / Disclosed task | $(I,E,G)$ / $(I,E’,G)$ / $(I_{\text{disc}},E’,G)$ |
| Adaptation gap $\Delta_{\text{adapt}}$ | $P_{\text{base}}-P_{\text{novel}}$ (%p) |
| Disclosure gain / Recovery fraction | $P_{\text{disc}}-P_{\text{novel}}$ / 그것을 $\Delta_{\text{adapt}}$로 나눈 비율 |
| Perception / Control / Constraints / Dynamics | novelty 4개 차원: 무엇이 보이나 / 어떻게 행동하나 / 무엇이 허용되나 / 환경이 어떻게 반응하나 |
| interact@1 / bypass@1 | 바뀐 구성요소를 건드린 rollout 비율 / 건드리지 않고 성공한 rollout 비율 |
| Observed → Recognized → Diagnosed → Revised → Solved | 증거 노출 → 이상으로 인식 → 바뀐 조건 식별 → 바뀐 방법으로 장애 해소 → task 완수 |
| Retry persistence | novelty 관찰 후 $P(\text{Retry}_{t+1}\mid\text{Retry}_t)$ |
| Premature Done | 실패하거나 부분 성공한 step 직후 바로 완료를 선언 |
| Meta-action | 각 명령의 전략적 의도 라벨: EXECUTE, INSPECT, DIAGNOSE, REVISE, VERIFY |
| $D_{\text{clean}}$ / $D_{\text{novel-unpaired}}$ / $D_{\text{novel-paired}}$ | $T_1\cup T_2$ / $T_2\cup T_1’$ / $T_1\cup T_1’$ |
| ECHO | GRPO에 terminal output 예측 auxiliary loss를 더해 world model을 함께 학습하는 post-training 방법 |
| Endless Terminals (ET), TB-Lite, TB-2 | terminal task 소스. ET는 대규모 생성형(학습+평가), TB-Lite와 Terminal-Bench 2는 평가 전용 |
| Terminus-2 | 평가와 construction에 쓴 terminal agent harness |