MemCo: Memory-Centric Collaboration for Generalizing LLM Agents to Unseen Environments ↗
Xinting Liao†, Siyan Liu†, Rabab K. Ward, Holger R. Roth*, Xiaoxiao Li* († equal contribution, * corresponding)
arXiv preprint (2026-10), ICLR 2027 template 사용
- 문제: 공유 경험이 너무 구체적이면 다른 환경에 맞지 않고, 너무 추상적이면 행동을 정하기 어렵다.
- 방법: local 경험에서 공유 record를 추상화·검증해 global memory를 만들고 현재 상황에 맞춰 검색·조합한다.
- 결과: 여러 환경·backbone에서 개선을 보고하며, memory 양보다 선택과 조합 방식이 중요하게 나타난다.
문제와 배경
배경과 읽는 관점
다른 agent가 이미 겪은 실패와 성공을 공유하면 같은 시행착오를 반복하는 비용을 줄일 수 있다. 하지만 그 기록이 특정 방의 물건 위치에 묶여 있으면 다른 환경에서 틀린 행동을 유도하고, 너무 추상적이면 다음 행동을 정하는 데 도움이 되지 않는다. MemCo는 공유할 경험의 단위와 그것을 현재 상황에 맞춰 사용하는 방법을 함께 다룬다.
기존 접근과 연구 질문
- Reflexion, MemRL, A-Mem 같은 agent memory 연구는 대부분 개별 agent의 경험을 정리·재사용하는 방법을 다룬다. 이 경우 각 agent가 쓸 만한 trajectory를 스스로 모아야 하고, 경험이 적으면 guidance도 불완전해진다(§1).
- 여러 agent가 서로 다른 환경에서 일한다면 한 agent의 경험이 다른 agent에게 참고가 될 수 있다. G-Memory, PlugMem, MCMA 등이 경험 공유 가능성을 보여 줬다. 하지만 저자들은 공유된 경험이 그 자체로 유용하지는 않다고 지적한다. 핵심 질문은 두 가지다(§1).
- 공유 경험을 어떻게 쓸모 있는 메모리로 조직할 것인가 (construction)
- 그 메모리를 다른 agent의 현재 결정에 어떻게 맞춰 쓸 것인가 (use)
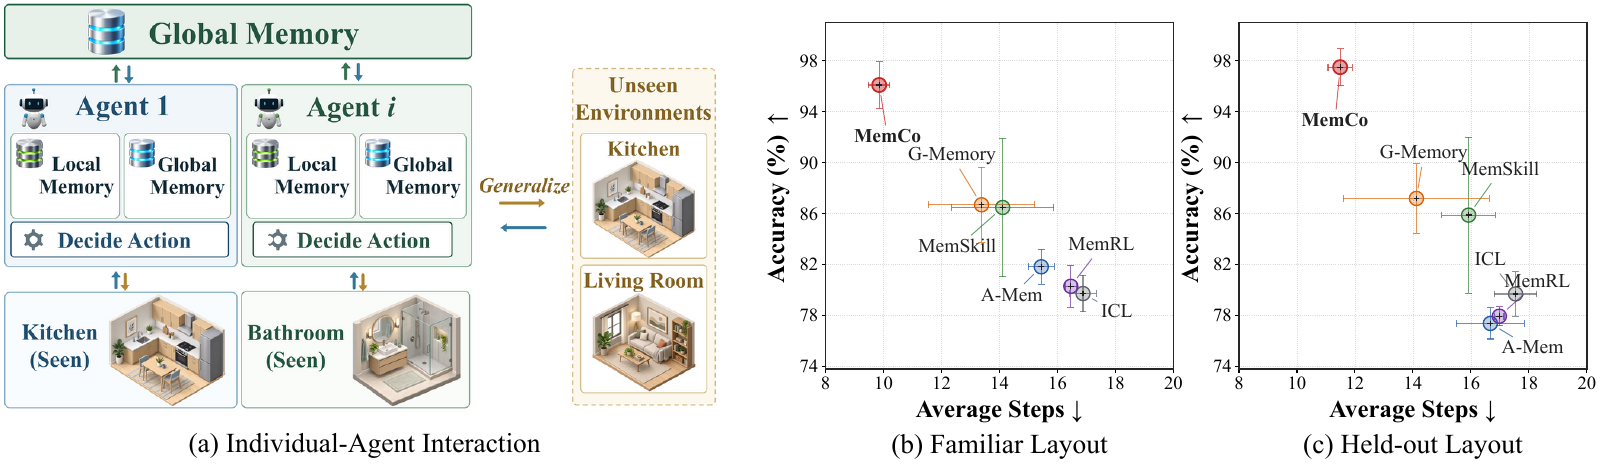
- 동기 실험(Figure 1(b)(c), Qwen3-32B ALFWorld): G-Memory는 ICL이나 isolated memory보다 낫지만, held-out layout에서는 개선 여지가 크다.
- 설정의 특징: 이 논문의 “unseen environment”는 agent 기준으로 정의된다. 평가 대상 agent가 경험을 쌓은 적 없는 환경이면 unseen이고, 다른 agent의 경험은 global memory로 들어와 있을 수 있다(§3.1, App. F.1). ALFWorld의 official
valid_unseen(held-out layout)은 이것과 별개의 두 번째 일반화 축이다.
이 글의 핵심은 local memory와 global memory를 단순히 많이 연결하는 데 있지 않다. 환경 고유의 사실을 남길 위치, 여러 agent의 근거를 합치는 조건, 현재 state·진행 단계·goal에 맞는 record를 골라 실제 행동에 연결하는 과정을 각각 구분한다.
핵심 아이디어
먼저 직관으로 이해하기
구체적인 관측과 실행 맥락은 local에 남기고, 역할 수준으로 추상화할 수 있는 record 중 충분한 근거가 모인 것만 global로 올린다. 실행 시에는 두 memory를 따로 검색한 뒤 현재 환경의 물체와 action에 다시 binding한다. 정보를 저장·공유하는 단계와 실제 결정에 쓰는 단계를 나눈 구조다.
전체 그림: Figure 2 — framework.pdf
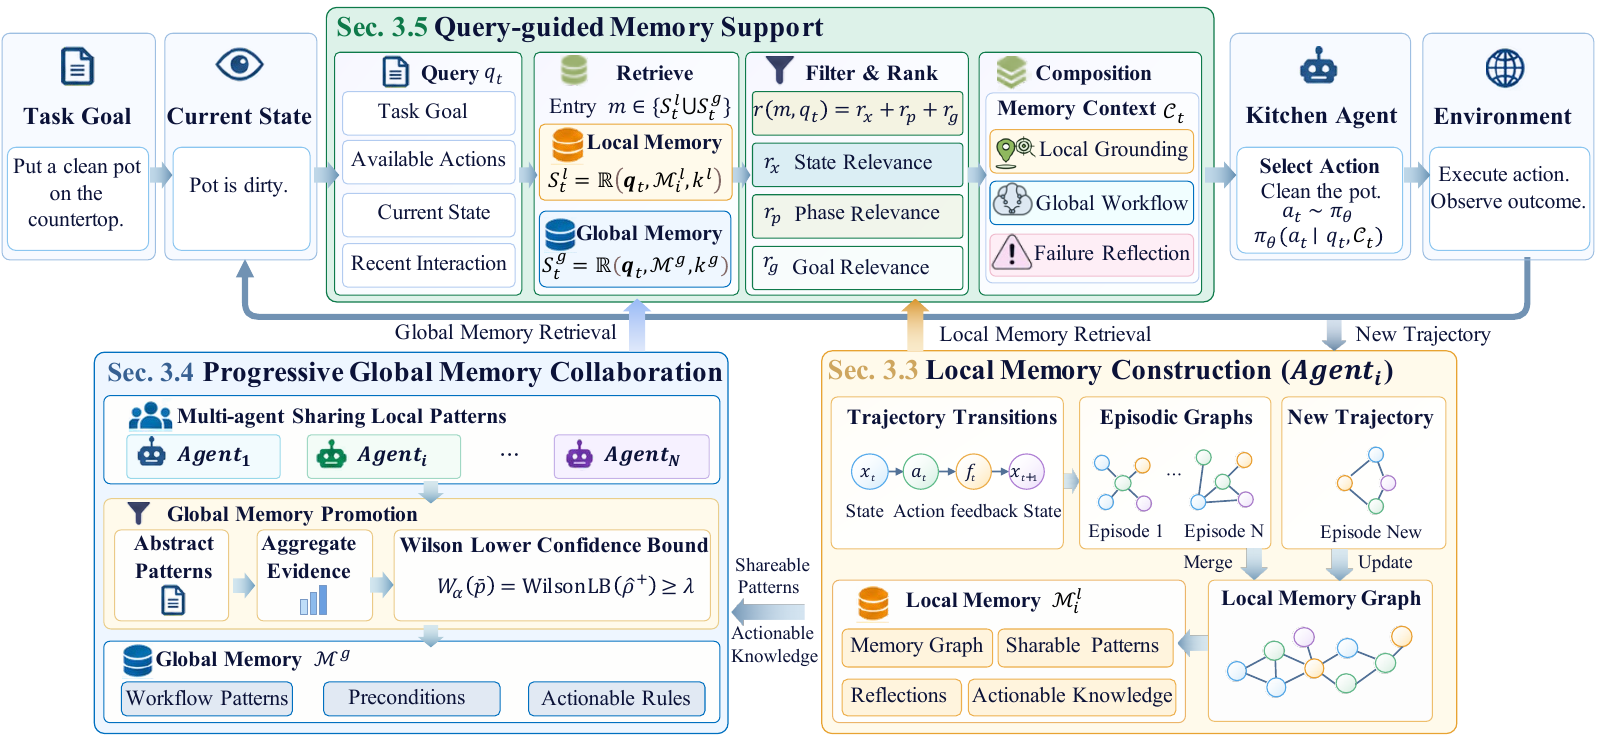
문제 설정 (§3.1)
- N개 agent가 각자 LLM policy
π_θ로 환경과 상호작용한다. step t에서 goalg, observationx_t, 가능한 action 집합A_t를 받고 actiona_t를 고르면, 환경은 feedbackf_t(progress / pause / failure / success)를 돌려준다. - 행동은 메모리에서 조합한 context
C_t에 조건부로 고른다:a_t ~ π_θ(a_t | g, x_t, A_t, C_t)(Eq. 1). - 모델 파라미터는 학습하지 않는다. 순수하게 메모리를 구성하고 검색하는 inference-time 방법이다.
Local Memory Construction (§3.3, App. B.2)
- 각 episode를 episodic graph로 만든다. 노드는 state
v^x, actionv^a, feedbackv^f이고, 간선은v^x_t → v^a_t → v^f_t → v^x_{t+1}순서로 잇는다. 실제 구현에서는 feedback을 별도 노드로 저장하지 않고 transition의 edge 통계에 붙인다(App. B.2.1). - 같은 agent의 episode들에서 type과 정규화된 내용이 같은 노드·간선을 merge해 local graph
G_i^l을 만든다(AlgorithmLocalMerge). - Local memory는
M_i^l = [G_i^l, P_i^l, E_i^l, R_i^l](Eq. 2)로 구성된다.P: pattern record. workflow(단계 순서), precondition(진행으로 이어진 조건–행동), repair(실패를 해결한 행동), failure(실패/정체로 이어진 행동)의 네 종류E: actionable knowledge(state–action–outcome 관계)R: concrete case와 reflection
- 공유 후보는
P ∪ E뿐이다.G와R은 환경 고유 맥락을 담고 있어 항상 local에 남는다. - Evidence 집계(App. B.2.4): record마다 각 occurrence가 그 record가 주장하는 relation을 지지(+)하는지 반박(−)하는지 표시한다. 같은 결과도 record에 따라 의미가 다르다. 예를 들어 “no progress”는 workflow에는 반박이지만 failure pattern에는 지지다. Promotion에 쓸 때는 episode당 최대 1표로 줄인다(같은 episode에 반박이 있으면 반박이 우선). 이 판정은 LLM 호출 없이 환경 인터페이스가 정규화한 신호로 deterministic하게 한다(App. B.2.5).
Progressive Global Memory Collaboration (§3.4, App. B.3)
- Abstract: concrete entity를 task role로 바꾸고(benchmark별 task-role mapping이 지원하는 경우), episode·scene anchor를 지운다. record type, applicability condition, action 순서, outcome은 보존한다. 예: “kettle 1의 현재 위치”는 local에 남고, “fill-then-heat 절차”는
target_object/heating_device같은 role로 공유한다(App. Table “Schematic household abstraction example”). - Exact-key merge: abstract record의 key는 (type, relation signature)로 정한다. embedding 유사도나 LLM 판단을 쓰지 않는다. 같은 “water source”를 언급하더라도 filling workflow와 cleaning workflow는 action·outcome이 다르므로 merge하지 않는다(App. B.3.3의 positive/negative merge 예시).
- Evidence 합산: 같은 key에 속한 local record들의 episode-reduced
n⁺,n⁻을 agent 전체에 걸쳐 더한다(Eq. 3). - Pre-promotion check: type별 structural completeness 검사와 low-information 검사를 통과해야 한다(App. B.3.2).
- Wilson promotion:
s = n⁺ + n⁻,ρ⁺ = n⁺/s일 때 one-sided Wilson lower boundW(Eq. 4)가W ≥ λ이면 global로 올린다(Eq. 6). 실제 구현에서는 매 snapshot마다 빈 global memory에서 다시 빌드하므로, 기준을 더는 통과하지 못하는 record는 자연히 빠진다(App. B.3.3).
Query-guided Memory Support (§3.5, App. B.4)
- query
q_t = Q(g, x_t, A_t, τ_<t)로 local과 global을 따로 검색한다. 상한은k^l = k^g = 5다(Eq. 7). - relevance는
r = r_x + r_p + r_g(Eq. 8)로 계산한다.r_x: 현재 state와 가능한 action과의 일관성r_p: task 진행 단계(phase)와의 호환성r_g: goal의 object/destination/tool role과의 정렬
- Hard filter와 soft ranking을 구분한다: 필요 조건이 현재 state와 모순되거나 action이
A_t에 매칭되지 않으면 제거한다. 남은 것은s_rank = r + Δ_ev + Δ_bind + Δ_src − p_soft로 정렬한다(App. B.4.2). 이때 Wilson 점수는 ranking에 들어가지 않고, global 소속 여부만 정한다. - Bounded selection: 각 facet에서 가장 강한 match를 1개씩 먼저 확보하고, 나머지 자리는 rank 순으로 채운다(App. B.4.3).
- Compose & Render: global record의 role을 현재 observation과 action에 binding한다(예:
target_object ↦ soap,water source ↦ basin,goal_destination ↦ vanity). 그다음 역할별로C_t = [c^ground, c^workflow, c^reflection]를 만든다(Eq. 9–10). prompt에서는 “Memory Decision Summary” 블록의Local memory / Global memory / Failure memory줄로 렌더링되는데, 이것은 출처가 아니라 역할 라벨이다(App. G).
정의와 수식
- Wilson lower bound (Eq. 4),
z = Φ⁻¹(1−α):W = [ sρ + z²/2 − z·sqrt( sρ(1−ρ) + z²/4 ) ] / (s + z²),s = 0이면W = 0 - Theorem 1 (finite-evidence correction):
ε_W = ρ⁺ − W = z·sqrt(W(1−W)/s) ≤ z / (2√s). evidence가 적을수록 경험적 지지율을 더 깎고, 그 보정은O(s^{-1/2})로 줄어든다. - Corollary (App. D.1):
W ≥ λ ⇔ ρ⁺ ≥ λ + z·sqrt(λ(1−λ)/s). 모든 표가 지지일 때 필요한 최소 evidence는s_min = ⌈z²λ/(1−λ)⌉이다. - Proposition (App. D.2): 입력이 고정되어 있으면 episode-reduced 집계와 promotion 결정은 처리 순서나 같은 annotation의 중복에 영향을 받지 않는다.
- 저자들의 단서(App. D.1): 위 항등식은 Wilson 식의 대수적 성질일 뿐이다. confidence 해석은 binomial 가정에 기대며, episode reduction이 episode 간 독립성을 보장하지는 않는다.
실험과 핵심 결과
실험 설정
| 항목 | 내용 |
|---|---|
| Benchmark | ALFWorld(Kitchen / Living Room / Bedroom / Bathroom 4 domain, 각 train 100, Familiar 20/17/20/20, Held-out 20/11/20/19), PDDL(Gripper 20 / Barman 20 / Blockworld 10 / Tyreworld 10 source, 통합 test 60), FEVER(Film/TV, Music 2 domain, 각 train 100, test 60), ScienceWorld(task family별, train variation ≤10, test 60) (App. F) |
| Agent 수 | domain당 1개. ALFWorld·PDDL 4개, FEVER 2개, ScienceWorld 10개 |
| 평가 프로토콜 | 각 agent는 자기 frozen local memory + 공유 global memory로 통합 test set 전체를 푼다. 따라서 자기 domain 과제와 남의 domain 과제가 섞여 있다. 평가 trajectory는 메모리에 다시 쓰지 않는다(App. F.5) |
| Baseline | ICL, A-Mem, MemRL, MemSkill, G-Memory |
| Backbone | Qwen3-4B, GPT-4o-mini, Qwen3-32B (Table 1). FEVER는 추가로 Claude-Haiku-4.5, Gemini-2.5-flash-lite, DeepSeek-v4-flash (Table 2a) |
| 하이퍼파라미터 | α = 0.05, λ = 0.35, k^l = k^g = 5, facet weight 모두 1. 모든 benchmark 공통 |
| 구현 | AutoGen. open model은 RTX PRO 6000 Blackwell 1장 |
| 지표 | Acc.(%), 평균 interaction steps. 주표는 3회 실행의 mean ± std |
Finding 1 — 12개 설정 중 정확도 1위 10개, 최소 step 9개 (Table 1)
선별한 수치 (Acc. / Steps):
| Backbone | Method | FEVER | PDDL | ALFWorld Familiar | ALFWorld Held-out |
|---|---|---|---|---|---|
| Qwen3-4B | 최강 baseline | 59.89 / 3.41 (MemSkill) | 46.58 / 29.03 (MemRL) | 62.23 / 18.73 (G-Memory) | 57.74 / 20.28 (MemSkill) |
| Qwen3-4B | MemCo | 60.17 / 3.38 | 53.01 / 29.16 | 84.21 / 13.33 | 82.84 / 13.77 |
| GPT-4o-mini | 최강 baseline | 63.00 / 6.33 (ICL) | 59.03 / 28.89 (MemSkill) | 42.21 / 24.05 (G-Memory) | 49.29 / 24.23 (G-Memory) |
| GPT-4o-mini | MemCo | 70.90 / 2.63 | 55.56 / 29.15 | 40.26 / 22.69 | 50.00 / 21.75 |
| Qwen3-32B | 최강 baseline | 68.64 / 6.49 (G-Memory) | 77.78 / 26.02 (MemRL) | 86.69 / 13.38 (G-Memory) | 87.19 / 14.12 (G-Memory) |
| Qwen3-32B | MemCo | 71.19 / 3.24 | 78.89 / 26.20 | 96.62 / 9.71 | 97.46 / 11.23 |
- 가장 큰 이득은 ALFWorld에서 나온다. Qwen3-4B held-out은 runner-up 대비 정확도 +43.47%, step −32.10%(모두 상대값). FEVER GPT-4o-mini는 +12.54%, −58.45%다.
- 진 곳: GPT-4o-mini에서 PDDL(MemSkill 59.03 > 55.56)과 ALFWorld Familiar(G-Memory 42.21 > 40.26). PDDL은 정확도가 올라도 step이 가장 적지는 않다. 저자들은 이를 “success와 efficiency가 항상 정렬되지는 않는다”고 해석한다.
- 통계(App. H): 12개 configuration 평균을 block으로 삼아 Friedman/Iman–Davenport 검정을 하면 Acc
p = 1.71×10⁻⁷, Stepsp = 4.58×10⁻³이다. Wilcoxon + Holm에서는 10개 비교 모두 adjustedp < 0.05이고, G-Memory 대비 Acc·Steps 모두 10승 2패,p_Holm = 0.0146이다. 평균 rank는 MemCo가 Acc 1.375, Steps 1.750으로 최고다. - 결과 그림: Figure 1 — alfworld_performance_with_backbone_comparison.pdf
Finding 2 — 다른 backbone에서도 FEVER 1위, ScienceWorld는 성공률 1위지만 progress는 2위 (Table 2)
- FEVER (Table 2a): Claude-Haiku-4.5는 69.49 (2위 A-Mem 62.71), Gemini-2.5-flash-lite는 72.04 (2위 MemRL 54.24), DeepSeek-v4-flash는 77.97 (2위 ICL 72.88). runner-up 대비 상대 +10.81%, +32.82%, +6.98%다. DeepSeek에서는 step이 3.04로 ICL(3.02)과 거의 같고, G-Memory는 이 설정에서 실행이 완료되지 않았다.
- ScienceWorld, Qwen3-32B (Table 2b): MemCo는 Success 30.47, Score 34.39로 1위다. 다만 Progress는 G-Memory(91.33)가 MemCo(82.90)보다 높고, step은 MemRL(5.21)이 가장 적다. 저자들의 해석은 “중간 진척이나 짧은 step이 최종 성공을 보장하지 않는다”이다.
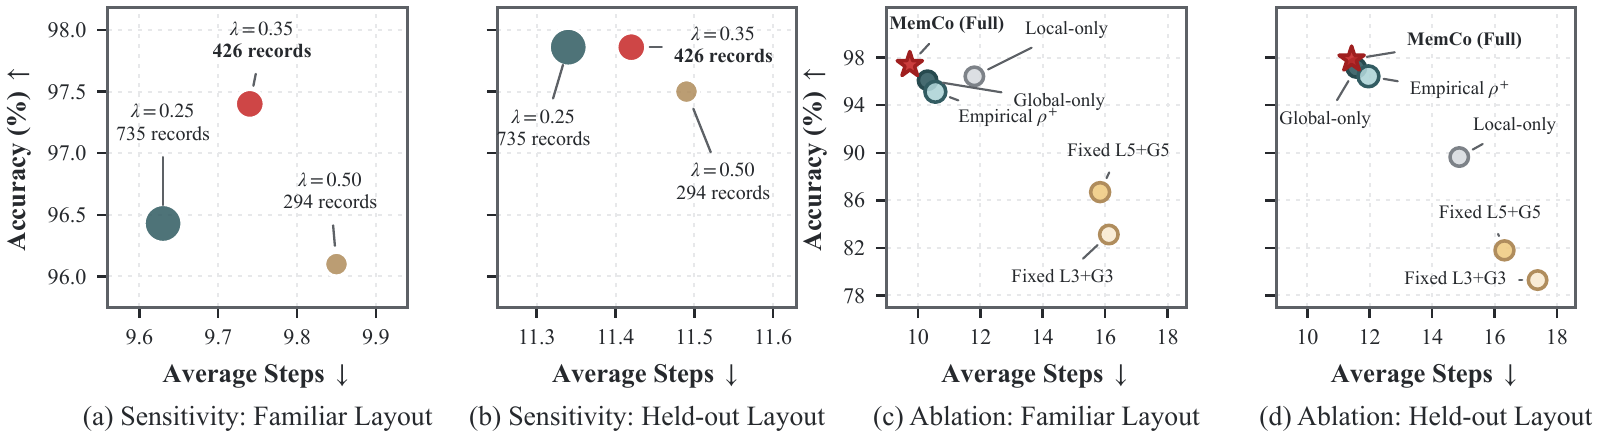
Finding 3 — Local과 global은 서로 보완한다 (Figure 4(c)(d), App. C.3)
Qwen3-32B ALFWorld, 같은 frozen local snapshot에서 비교:
| 설정 | Global records | Familiar Acc | Held-out Acc | Familiar Steps | Held-out Steps | Avg #Mem | Avg Mem Tok |
|---|---|---|---|---|---|---|---|
| Local-only | – | 96.43 | 89.64 | 11.81 | 14.87 | 0.70 | 72.96 |
| Global-only | 426 | 96.10 | 97.14 | 10.31 | 11.57 | 1.70 | 124.21 |
| Fixed concat L3+G3 | 426 | 83.12 | 79.29 | 16.12 | 17.38 | 6.00 | 146.58 |
| Fixed concat L5+G5 | 426 | 86.69 | 81.79 | 15.84 | 16.32 | 9.99 | 207.56 |
Empirical ρ⁺ promotion | 736 | 95.13 | 96.43 | 10.56 | 11.96 | 1.73 | 124.56 |
| MemCo | 426 | 97.40 | 97.86 | 9.74 | 11.42 | 1.70 | 123.23 |
- Local-only는 held-out에서 89.64%로 떨어지고, Global-only는 97.14%로 그 격차를 메운다. 둘을 합치면 정확도도 가장 높고 trajectory도 가장 짧다.
- 그림: Figure 4 — alfworld_lambda_and_component_ablation.pdf
Finding 4 — 메모리를 더 많이 넣으면 오히려 나빠진다 (같은 표)
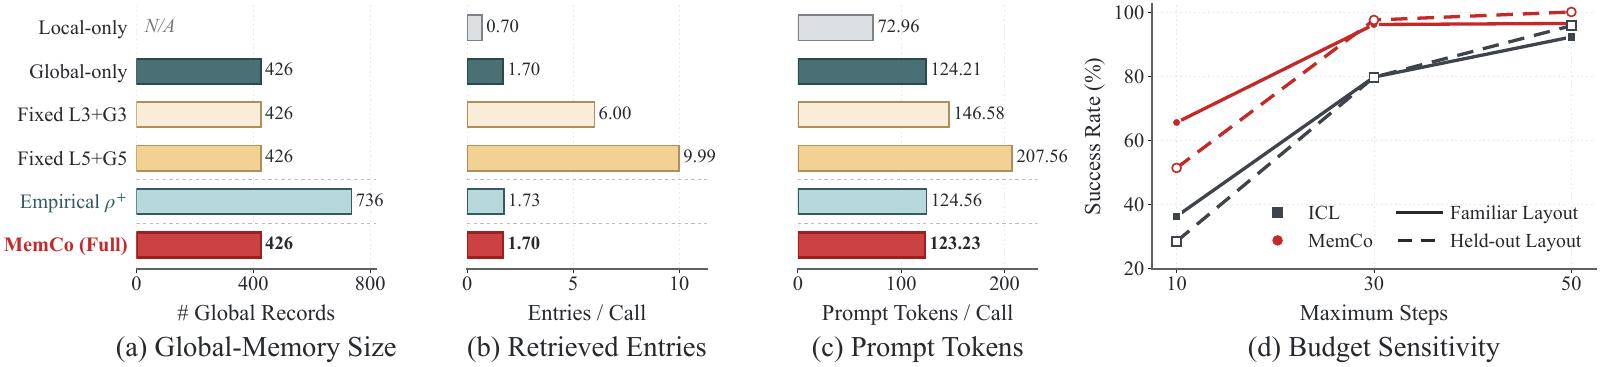
- L5+G5는 MemCo보다 메모리를 약 6배(9.99 vs 1.70 entry) 더 넣지만, Familiar −10.71%p, Held-out −16.07%p다. 저자들은 무엇을 골라 어떻게 조합하느냐가 중요하고, 덜 targeted된 메모리는 state-specific 결정에 irrelevant guidance를 끌어들인다고 해석한다.
- MemCo가 평균적으로 retrieval call당 주입하는 메모리는 1.70개, 약 123 token이다. 상한(5+5)에 비하면 매우 적다.
Finding 5 — Wilson promotion은 global bank를 줄이면서 성능을 조금 올린다
W대신ρ⁺로 같은 λ = 0.35를 적용하면 global이 736개에서 426개로 줄고, 정확도는 +2.27%p / +1.43%p, step은 −0.82 / −0.54다. 두 변형이 decision당 주입하는 entry 수는 비슷하므로(1.73 vs 1.70) 차이가 prompt 크기 때문만은 아니라고 저자들은 말한다.- λ sweep (App. C.2): λ 0.25 / 0.35 / 0.50에서 global record는 735 / 426 / 294개다. Familiar는 96.43 / 97.40 / 96.10, Held-out은 97.86 / 97.86 / 97.50으로 정확도가 거의 변하지 않는다. step이 가장 적은 것은 λ = 0.25다. 저자들도 이 결과를 “accuracy–compactness–efficiency trade-off”로 표현하며, 한 threshold가 모든 지표에서 최적이라고 주장하지 않는다.
Finding 6 — 작은 interaction budget에서 이득이 크다 (Figure 3(d), App. C.4)
| Budget | ICL Familiar | ICL Held-out | MemCo Familiar | MemCo Held-out |
|---|---|---|---|---|
| 10 | 36.36 | 28.57 | 65.58 | 51.43 |
| 30 | 79.72 | 79.69 | 96.10 | 97.50 |
| 50 | 92.21 | 95.71 | 96.43 | 100.00 |
- MemCo는 30 step에서 거의 포화하며, MemCo@30이 ICL@50보다 높다.
- 그림: Figure 3 — alfworld_memory_cost_and_budget_sensitivity.pdf
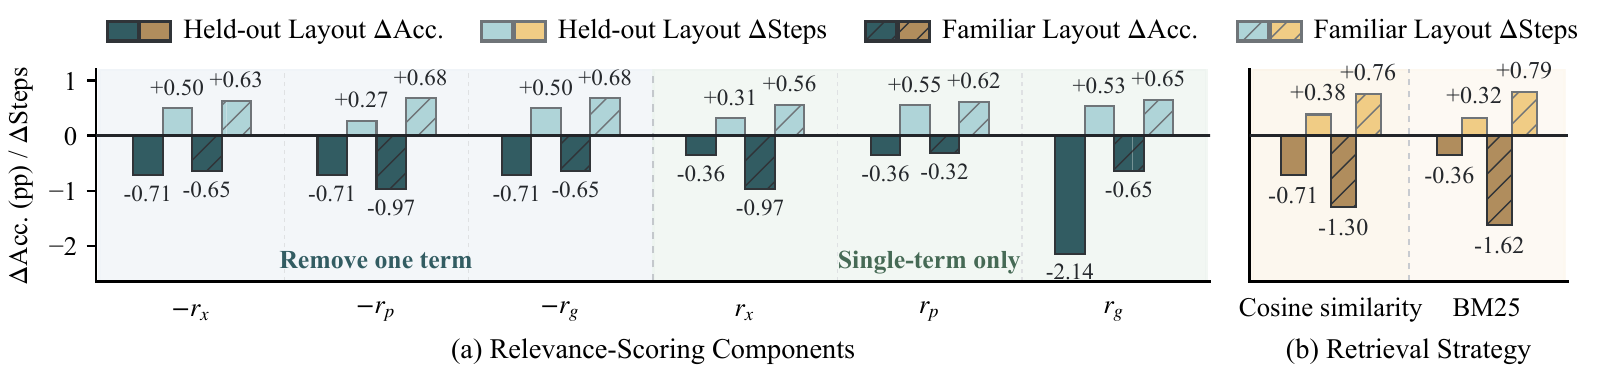
Finding 7 — 세 relevance facet과 explicit matching (Figure 5, App. C.5)
- facet 하나를 빼거나 하나만 남기면 정확도가 소폭 떨어지고 step이 늘어난다. 예:
−r_p는 96.43 / 97.14, step 10.42 / 11.69. cosine similarity(96.10 / 97.14)와 BM25(95.78 / 97.50)도 full MemCo보다 낮다. - 단, all-zero relevance(
r = 0) control도 96.43 / 97.14, step 10.37 / 11.96으로 full(97.40 / 97.86)과 차이가 작다. 저자들은 이 control이 “underperform”한다고만 적고, 본문 그림에서는 뺐다. - 그림: Figure 5 — eq11_relevance_ablation_heatmap.pdf
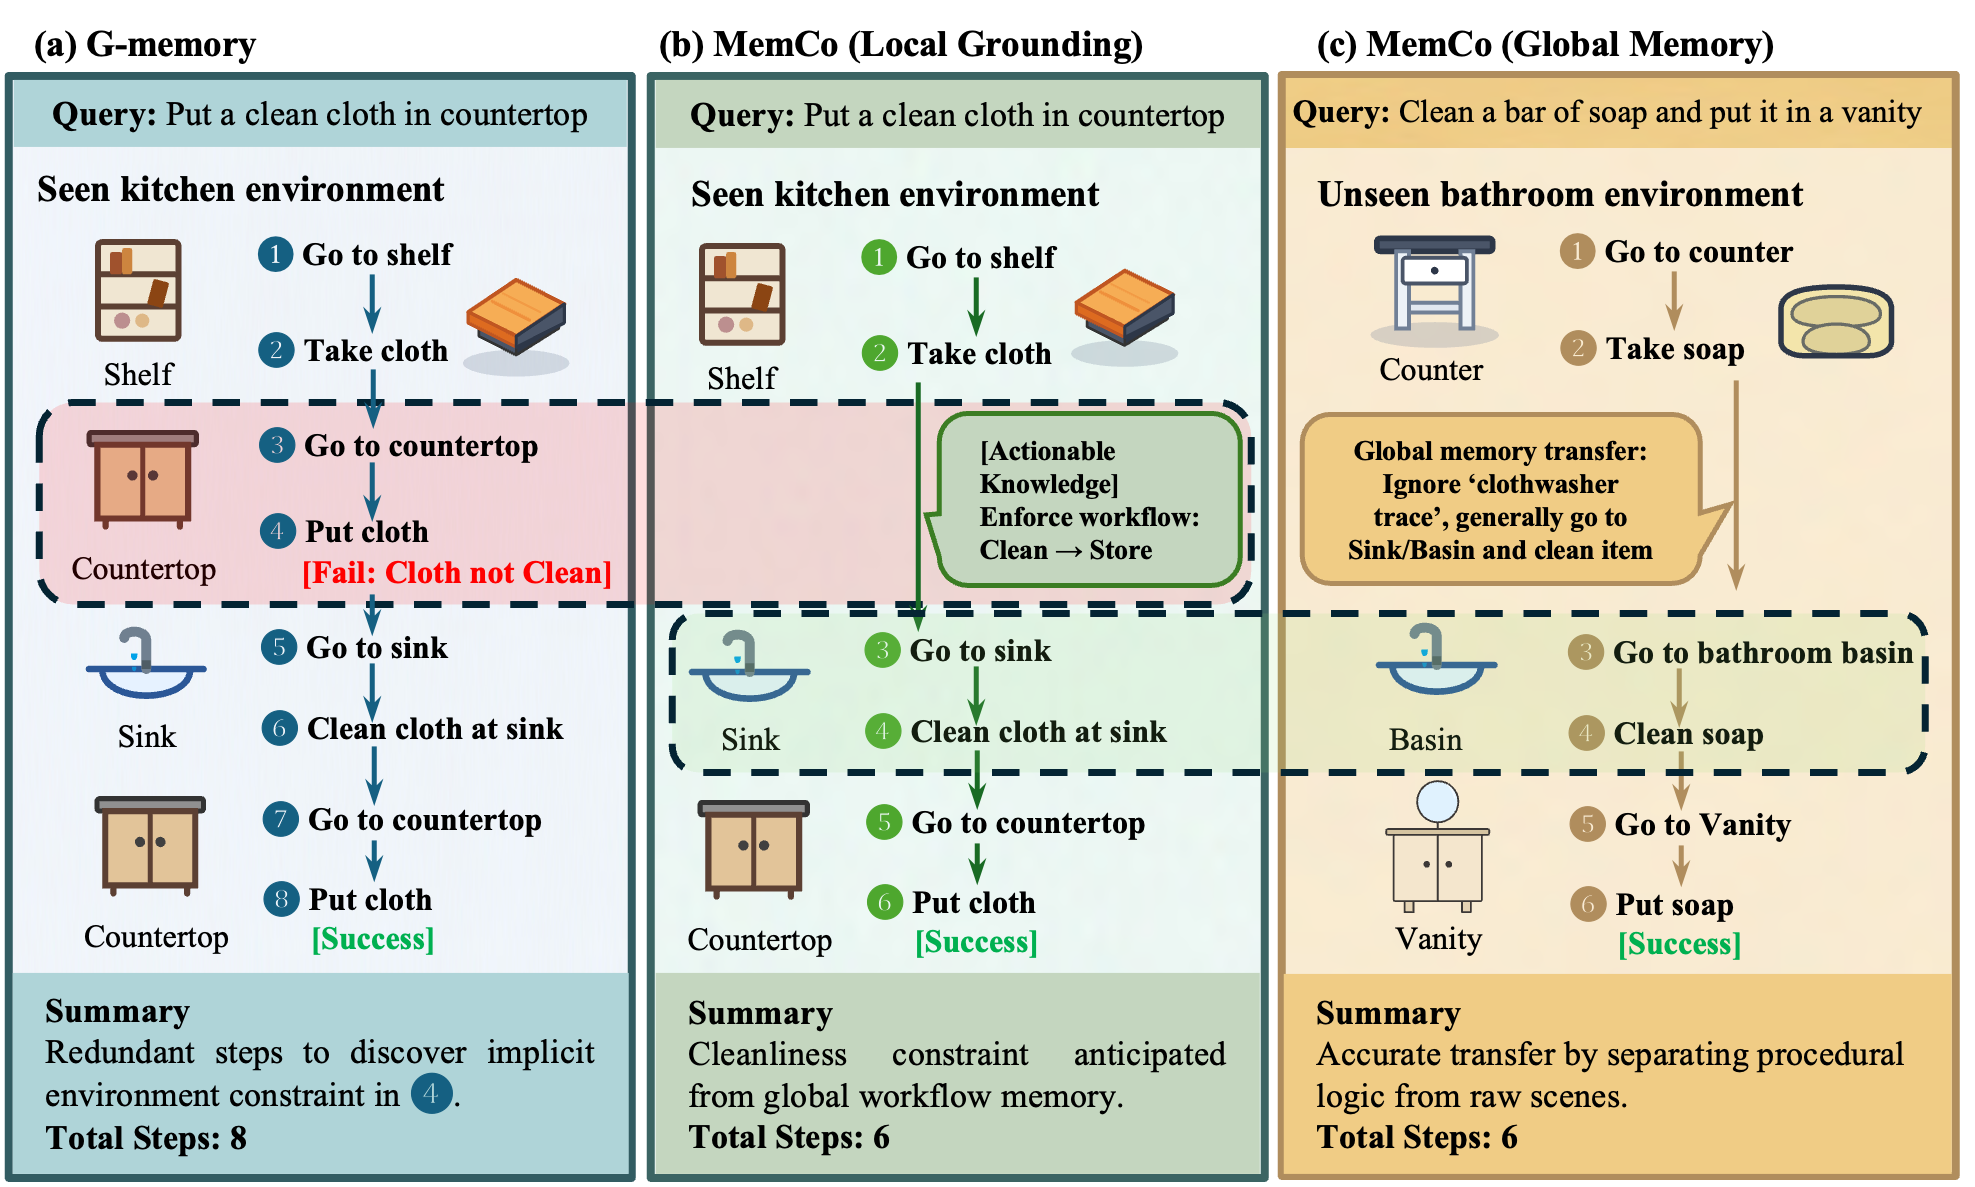
Finding 8 — Case study: 정리 순서는 global에서, 실행 grounding은 현재 환경에서 (§5, Figure 6)
- “Put a clean cloth in countertop” 과제에서 G-Memory는 cleaning 전에 placement를 시도한다. MemCo는 clean-before-store 순서와 local actionable knowledge를 함께 가져와 이 잘못된 행동을 피한다.
- 처음 보는 bathroom 환경(“Clean a bar of soap and put it in a vanity”)에서는 kitchen 고유 guidance(“clothwasher trace”, “go to kitchen sink”)를 제외하고, 공유 workflow의 role을 basin과 vanity에 binding해 6 step에 완료한다.
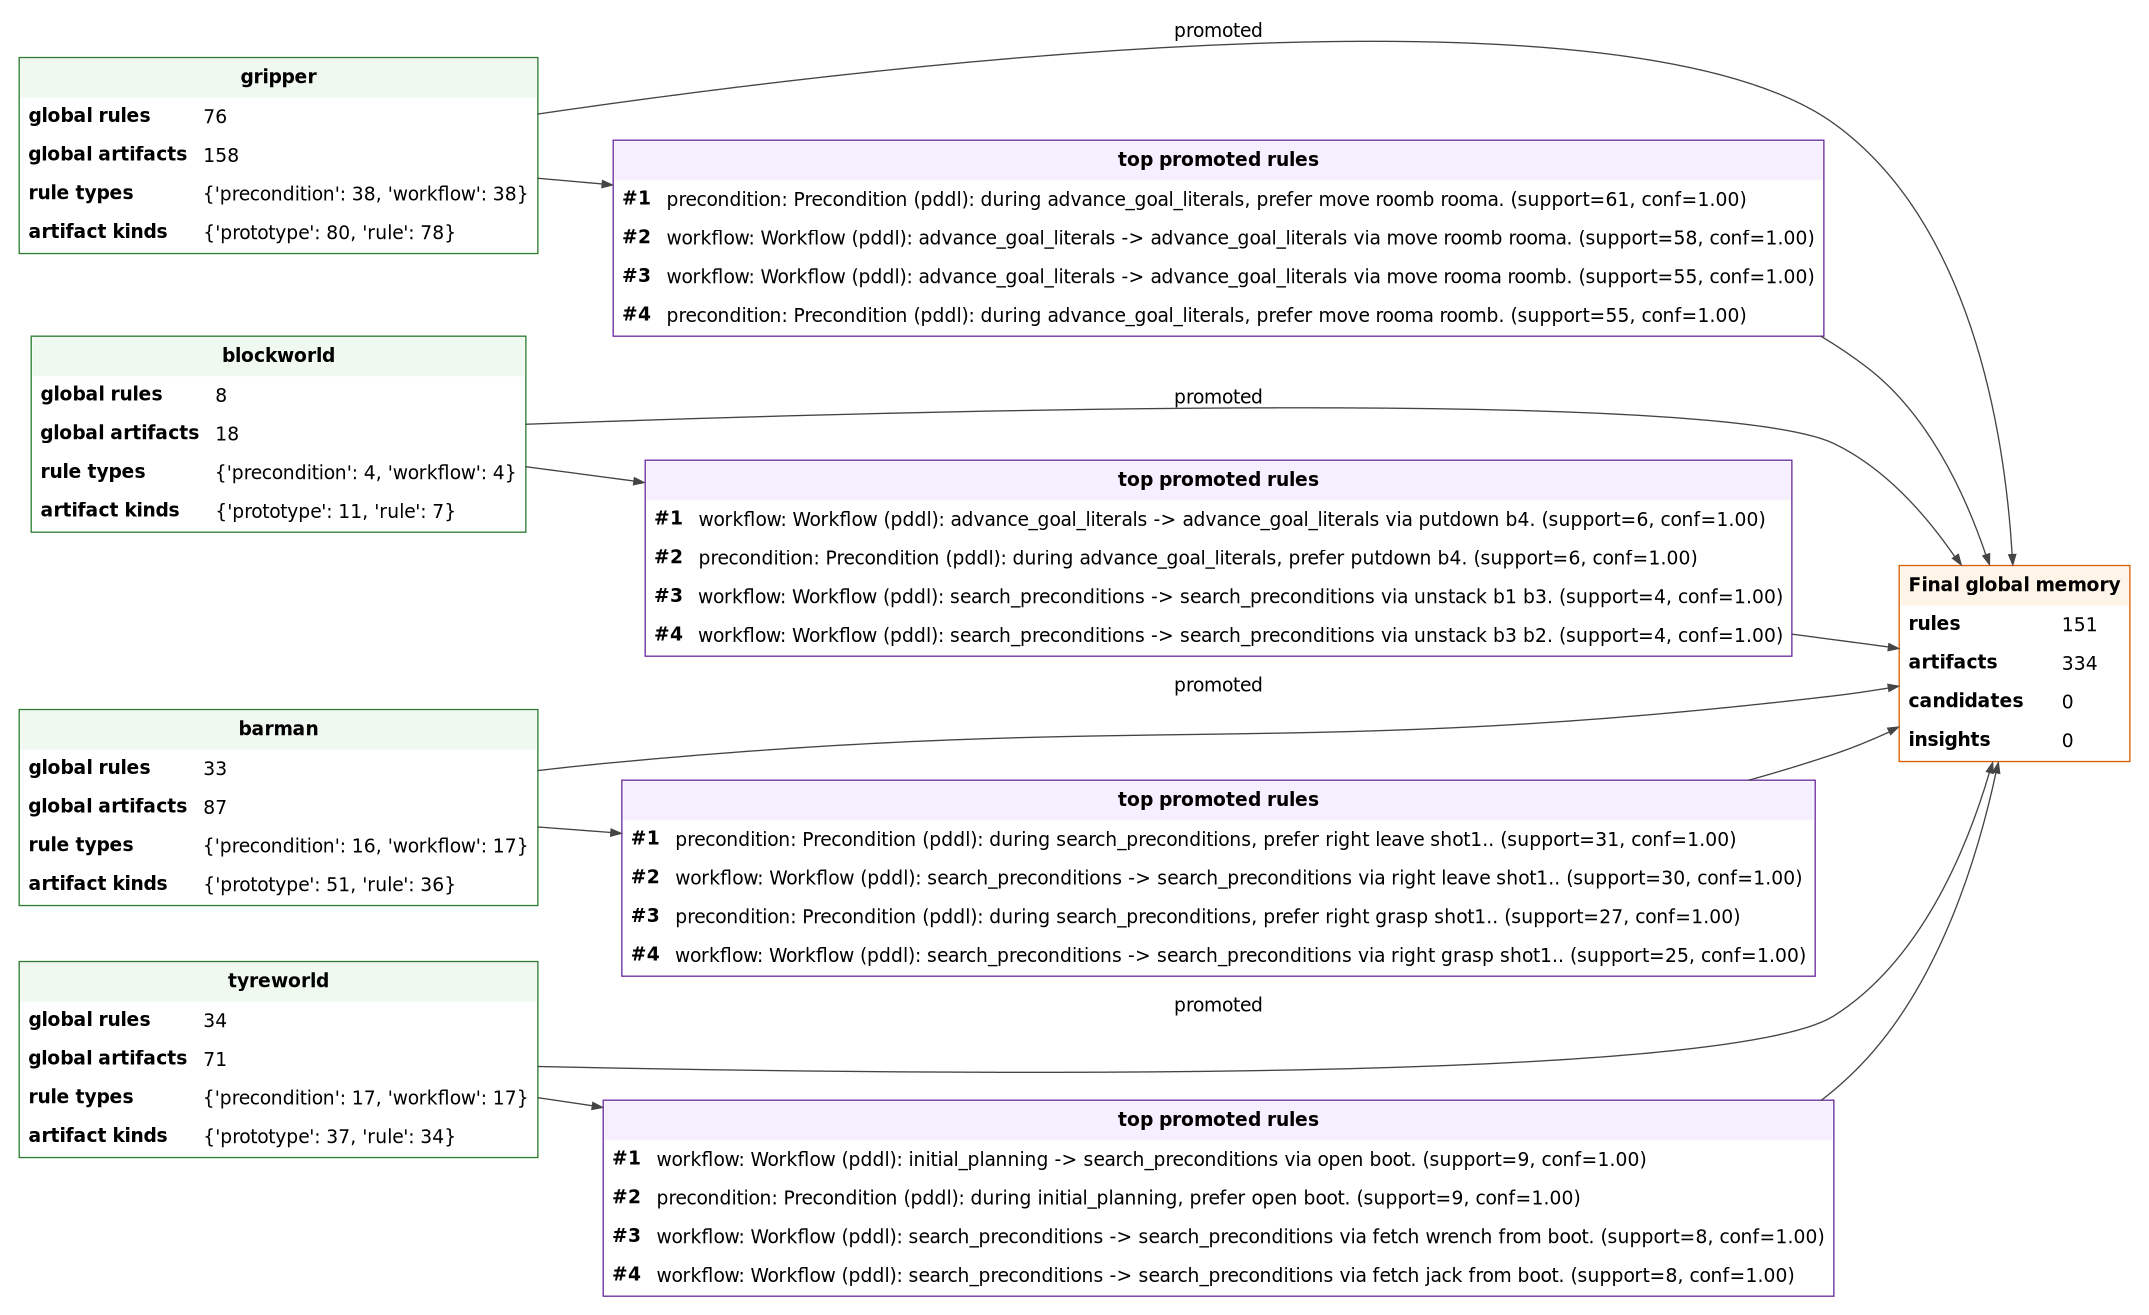
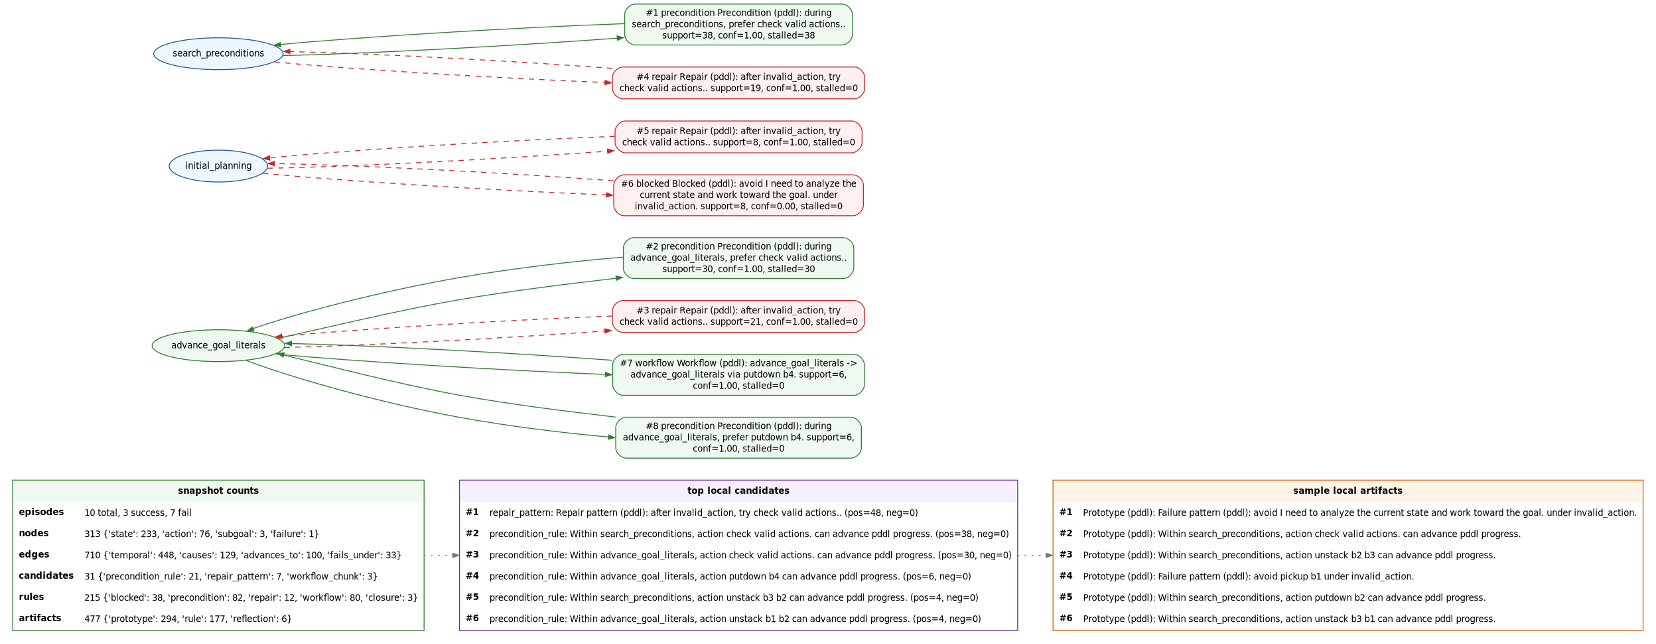
- 그림: Figure 6 — casestudy4.png. PDDL의 실제 global/local 메모리 시각화는 App. J에 있다(global, blockworld local 등).
한계와 해석
저자들이 밝힌 한계
- Cold start: global workflow memory를 bootstrap하려면 초기 interaction trace가 필요하다. 저자들은 이것이 retrieval 기반 경험 공유 시스템 전반의 공통 특성이라고 말한다(Limitations).
- Modality: 텍스트·symbolic benchmark에서만 평가했다. 시각 관찰이 있는 multimodal 환경으로의 확장은 future work다(Limitations).
- Ablation의 성격: mechanism·sensitivity 분석은 모두 같은 frozen local-memory snapshot 위의 within-snapshot 비교다. 주 실험의 독립 반복이 아니다(§4.2, App. C.1).
- 통계 검정의 단위: 12개 configuration 평균이 block이다. backbone과 task family를 재사용하므로 block 간 의존성이 있을 수 있다. 저자들은 p-value가 seed·task 단위의 독립 replication을 대신하지 않는다고 명시한다(App. H.3).
- Wilson의 해석: 대수적 bound는 성립하지만 confidence 해석은 binomial 근사에 기대며, episode 간 독립성은 보장되지 않는다(App. D.1). 비동기·streaming 구현에서 stale replacement가 안전하다는 보장도 없다(App. D.2).
- (주석 처리된 Broader Impacts 초안) 잘못되었거나 suboptimal한 action sequence가 공유를 통해 다른 agent로 퍼질 위험이 있다. 공유 workflow를 검증하는 방법이 필요하다.
AI의 해석
아래는 논문의 주장이 아니라 정리자(Claude)의 해석이다.
- “Collaboration”의 실체는 오프라인 지식 증류다. 평가 중에는 local/global 메모리가 모두 frozen이고(App. F.5), global memory는 acquisition이 끝난 local store들에서 한 번 빌드된다. agent들이 실시간으로 경험을 주고받는 구조가 아니라, domain별로 수집한 trajectory를 규칙 기반으로 abstract·merge해 공유 rule bank를 만드는 구조에 가깝다. 제목의 “collaboration”과 “progressive”는 이 점에서 다소 강한 표현이다.
- 방법의 상당 부분이 benchmark별 엔지니어링에 기대고 있다. abstraction은 “benchmark-specific task-role mapping”을 쓰고(§3.4), evidence의 부호는 환경 인터페이스가 정규화한 progress/failure 신호로 deterministic하게 판정한다(App. B.2.5).
r_x/r_p/r_g도 정규화된 field 비교다. 이 인터페이스(어떤 field가 task role이고 progress가 무엇인지)를 누가 얼마나 손으로 정의했는지가 성능에 크게 작용할 텐데, 소스에서 그 공수와 내용은 드러나지 않는다. 범용 memory 방법이라기보다 환경 schema를 아는 상태에서의 구조화 메모리로 읽는 편이 안전하다. - Wilson gate는 생각보다 느슨하다. Corollary의
s_min = ⌈z²λ/(1−λ)⌉에α = 0.05(z ≈ 1.645),λ = 0.35를 넣어 직접 계산하면s_min = 2다. episode 2개에서 모두 지지되면 promotion된다(W = 2/(2+2.706) ≈ 0.425). λ = 0.25이면 1개, 0.50이면 3개다. “finite-evidence aware”라는 수사에 비해 실제 문턱은 낮다. λ sweep에서 정확도가 거의 변하지 않는 것도, 정확도를 좌우하는 것이 promotion이 아니라 retrieval 쪽의 hard filter와 grounding일 가능성을 시사한다. - Ablation 차이의 크기. 평가는 4개 agent가 각각 통합 test set을 푸는 구조다(Familiar 77 × 4 = 308, Held-out 70 × 4 = 280 episode로 추정). 그러면 1%p는 약 3 episode에 해당한다. Wilson vs
ρ⁺(+2.27 / +1.43%p), facet ablation(0.3–1%p), 특히r = 0control과 full의 차이(0.97 / 0.72%p)는 단일 snapshot·단일 실행의 몇 episode 차이다. “세 facet이 complementary하게 기여한다”는 주장은 이 데이터만으로는 약하다. 오히려 relevance 점수를 0으로 둬도 96–97%가 나온다는 것은 성능 대부분이 hard filter, action binding, role grounding,Δ_ev/Δ_bind같은 다른 항에서 나온다는 신호로 읽힌다. - Baseline을 어떻게 구성했는지가 불명확하다. baseline들이 같은 source partition의 trajectory로 메모리를 만들었는지, A-Mem/MemRL/MemSkill이 agent별 isolated memory인지 전체 pooled memory인지 소스에서 확인하지 못했다. MemCo는 “자기 local + 남의 global”을 받으므로, 비교 조건(접근 가능한 경험의 양)이 같은지가 핵심이다. 또 ALFWorld Qwen3-4B의 거대한 이득(57.74 → 82.84)은 작은 모델일수록 “현재 유효한 action에 binding된 1–2줄짜리 지시”의 가치가 크다는 뜻일 수 있다. 메모리의 “협업”보다 action grounding의 효과일 수 있다는 뜻이다.
- Step 지표의 해석. PDDL step은 모든 방법이 ~29로 몰려 있다(Table 1). 상한 근처에서 잘리고 있을 가능성이 있는데, 소스에서 PDDL step 상한 값을 찾지 못했다. ALFWorld는 budget sweep의 30-step ICL 값(79.72 / 79.69)이 Table 1의 ICL 값과 같으므로, 기본 budget이 30일 것으로 보인다. 이 경우 “step 감소”는 실패 episode(=30 step)가 줄어든 효과와 섞여 있다.
- Familiar ≈ Held-out 현상. Qwen3-32B MemCo는 held-out(97.46)이 familiar(96.62)보다 높다. global record가 role 수준으로 abstract되어 layout에 의존하지 않기 때문이라는 해석은 그럴듯하다. 다만 ALFWorld 성공 대부분이 “올바른 순서 + 유효 action 선택”으로 풀린다는 benchmark 특성(포화)도 함께 고려해야 한다.
- 그래도 가치 있는 지점. (a) 공유 단위를 trajectory가 아니라 type이 있는 conditional record로 잡은 것, (b) source(local/global), record type, support role을 분리한 설계(App. E.3), (c) 같은 outcome이라도 record에 따라 지지/반박이 달라지는 relation-relative evidence 정의, (d) “메모리를 더 넣으면 나빠진다”는 L5+G5 결과. 이 네 가지는 다른 agent memory 연구에도 그대로 가져다 쓸 수 있다.
더 생각해볼 질문
아래는 AI가 정리 과정에서 제안한 후속 질문입니다. 본인이 직접 작성한 의견이나 논문에서 검증한 결과로 표시하지 않습니다.
- Agent Plasticity와의 연결: MemCo는 평가 중 메모리를 freeze한다. 평가 중에도 local/global이 계속 갱신되는 online 버전에서는 plasticity(경험을 통한 개선 속도)가 어떻게 달라질까? 잘못된 workflow가 퍼지는 위험(주석 처리된 Broader Impacts)은 어떻게 측정할 수 있을까?
- Environmental Novelty와의 연결: “성공했던 전략이 새 환경에서 실패”하는 상황에서 MemCo의 hard filter(조건 모순 시 제거)와 failure/repair record가 실제로 stale global workflow를 걸러낼 수 있을까? 환경의 규칙이 바뀌는 경우(단순히 layout이 바뀌는 것 이상)에도 exact-key merge가 버틸 수 있을까?
- Generalization Tax와의 연결: RL로 policy 자체를 cross-domain 학습하는 것과, policy는 고정한 채 cross-domain 메모리를 공유하는 것 중 어느 쪽이 held-out 환경에서 더 싸고 강할까? 둘을 결합하면 어떨까?
- SCDP와의 연결: “무엇을 global로 promote할지”와 “무엇을 context에 넣을지”를 비용이 있는 decision 변수로 모델링하면, λ와
k를 고정 하이퍼파라미터가 아니라 최적화 대상으로 볼 수 있을까? - task-role mapping과 progress 신호를 사람이 정의하지 않고 LLM이 자동으로 유도하게 하면, 성능 중 얼마가 남을까? 이것이 이 방법의 범용성을 가늠하는 핵심 실험일 것이다.
참고자료
용어 정리
| 용어 | 뜻 |
|---|---|
local memory M_i^l | agent i의 환경 고유 메모리. graph G + pattern P + actionable E + case/reflection R |
global memory M^g | 여러 agent의 P ∪ E record를 abstract한 뒤 Wilson 기준으로 promote한 공유 bank |
| episodic graph | 한 episode의 state → action → feedback → next state 전이 그래프. 같은 agent 안에서 merge해 G_i^l이 된다 |
| workflow / precondition / repair / failure pattern | 단계 순서 / 진행으로 이어진 조건–행동 / 실패를 해결한 행동 / 실패·정체로 이어진 행동 |
| actionable knowledge | 실행 가능한 state–action–outcome 관계 (예: “basin으로 soap을 clean할 수 있다”) |
| role-level abstraction | concrete entity(kettle 1, sink 1)를 task role(target_object, water source)로 바꾸고 scene anchor를 지우는 것 |
| exact abstract key | (record type, relation signature). 이것이 정확히 같을 때만 merge한다. embedding이나 LLM은 쓰지 않는다 |
episode-reduced count n⁺, n⁻ | 같은 record에 대해 episode당 최대 1표로 줄인 지지/반박 수. Wilson에만 쓴다 |
Wilson lower bound W | 지지율의 one-sided 하한 신뢰구간. evidence가 적으면 경험적 지지율을 더 깎는다 |
promotion threshold λ | W ≥ λ이면 global로 올린다. 기본값 0.35 |
relevance facet r_x, r_p, r_g | state·action 일관성 / task phase 호환성 / goal role 정렬 |
| bounded selection | facet별 최강 match를 먼저 확보하고 나머지를 rank로 채워 k개 이하로 고르는 것 |
| support role | 선택된 entry의 현재 결정에서의 용도. grounding / workflow / reflection |
| Familiar / Held-out layout | ALFWorld의 official valid_seen / valid_unseen split |
| unseen environment (이 논문) | 평가 대상 agent가 경험을 쌓은 적 없는 환경. agent 기준의 정의다 |