Harness Learning Enables Generalizable Test-Time Adaptation ↗
Alvin Zhang, Xuecheng Liu, Zixuan Wang, Fahim Tajwar, Daman Arora, Ruslan Salakhutdinov, Daniel Khashabi, Yuda Song, Andrea Zanette
arXiv preprint (2026-09-28) · v1
- 문제: 새 task마다 harness를 고치는 시행착오를 줄일 수 있을까?
- 방법: 실행 피드백을 읽고 유용한 코드 수정을 제안하는 proposer를 강화학습으로 학습한다.
- 결과: 수정 능력의 전이가 관찰되지만, 고정 tool-loop baseline보다 항상 우수한 것은 아니다.
문제와 배경
같은 모델도 실행 절차에 따라 다른 시스템이 된다
LLM을 사용해 문제를 푸는 시스템에는 모델의 가중치 외에도 선택할 것이 많습니다. 어떤 정보를 context에 넣을지, 언제 검색할지, Python 실행을 허용할지, 답을 검증하고 재시도할지를 정해야 합니다. 논문이 말하는 harness는 이런 실행 절차를 정의하는 프로그램입니다. 모델 자체를 바꾸지 않아도 harness를 수정하면 모델이 가진 능력을 활용하는 방식이 달라집니다(§1, §3.1).
가령 검색 결과를 바로 답변에 넣는 절차와, 검색한 내용을 요약한 뒤 다음 검색에 사용하는 절차는 같은 모델을 호출하더라도 정보가 흐르는 방식이 다릅니다. 이는 harness의 역할을 이해하기 위한 설명용 예시입니다. 중요한 점은 최종 답변의 품질을 모델 하나의 특성만으로 설명할 수 없다는 것입니다.
매번 다시 탐색하는 것만으로 충분할까
새로운 task에서 실행 결과를 관찰하고 harness를 고쳐볼 수는 있습니다. 하지만 이 과정을 매번 처음부터 반복하면 시행착오가 필요합니다. 한 task에서 효과적이었던 수정이 다른 task에서도 유효한지도 별도로 확인해야 합니다. 따라서 좋은 harness 하나를 찾는 문제와, 새로운 상황에서 좋은 수정안을 만드는 능력을 얻는 문제는 구분됩니다(§1).
이 논문은 후자에 초점을 맞춥니다. 현재 코드와 실패 사례를 보고 무엇을 고칠지 제안하는 모델을 학습하면, 이전에 학습하지 않은 task에서도 그 수정 능력을 사용할 수 있을까? 저자들의 연구 질문은 “다양한 실행 결과를 경험하면서, 새로운 task에서도 잘 작동하는 수정 절차를 배울 수 있는가?”입니다(§1).
질문 하나를 맞히는 것과 task에 적응하는 것
여기서 task는 질문 하나가 아닙니다. Reasoning Gym에서는 maze·sudoku 같은 문제 family, QA에서는 HotpotQA 같은 benchmark가 적응의 단위입니다. 해당 task의 여러 development 질문을 풀며 얻은 피드백으로 harness를 수정한 뒤, 별도의 held-out 질문에서 성능을 측정합니다(§4.1).
따라서 살펴볼 것은 피드백에 등장한 문제의 정답을 반영했는지만이 아닙니다. 수정한 절차가 같은 task의 새로운 질문에서도 유효한지, 더 나아가 수정 능력 자체가 학습에 쓰지 않은 task로 옮겨가는지가 중요합니다. 이 구분을 먼저 잡아야 뒤의 unseen-family 결과와 반복 적응 실험을 해석할 수 있습니다.
핵심 아이디어
정답을 만드는 대신, 정답을 만드는 절차를 수정한다
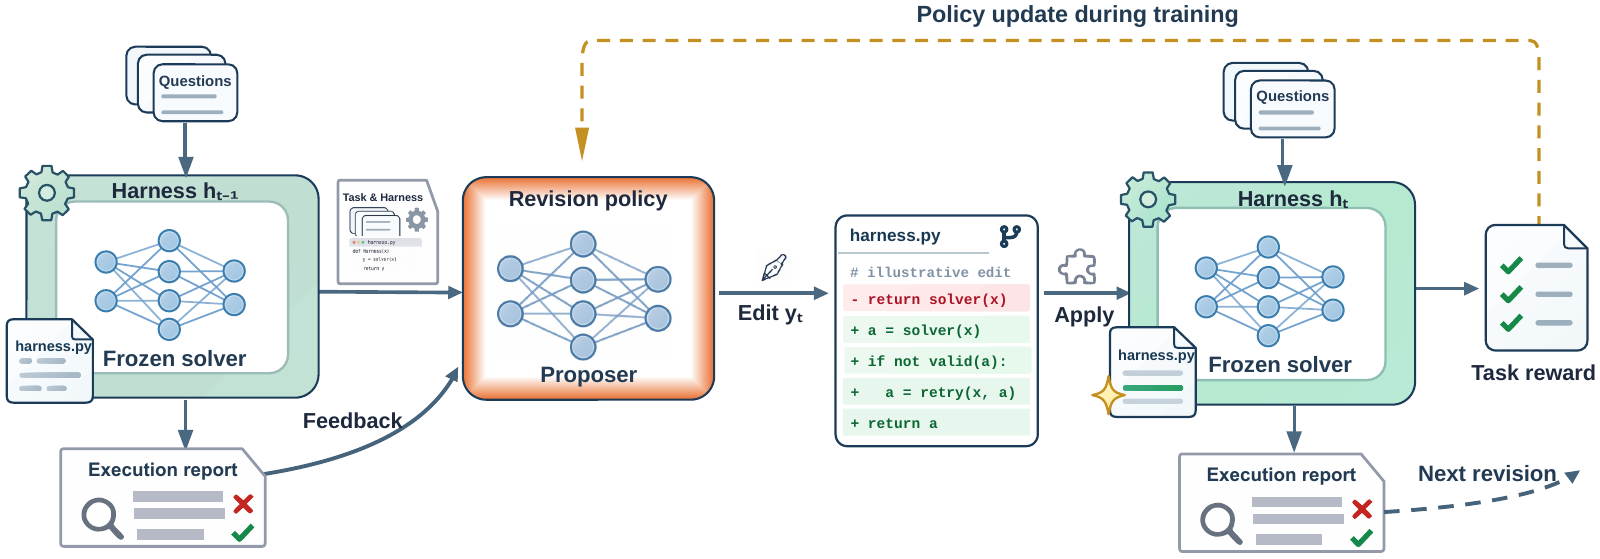
핵심 발상은 문제를 푸는 모델과 풀이 절차를 고치는 모델의 역할을 나누는 것입니다. Solver는 현재 harness의 지시에 따라 추론·답변·코드 생성을 수행합니다. Proposer는 task 설명, 현재 harness 코드, execution report를 입력으로 받아 harness 수정안을 제안합니다. 학습의 대상은 실행 피드백에서 유용한 코드 수정을 만드는 proposer입니다(§4).
이때 proposer의 출력은 최종 정답이 아닙니다. 수정된 프로그램을 실행해 실제 문제 해결 성능을 확인해야 그 제안의 가치를 알 수 있습니다. 방법의 구조는 실행 결과 → 코드 수정 → 다시 실행해 평가로 이어집니다. 보고서에 담긴 실패를 보고 더 유용한 수정안을 내도록 proposer를 학습하는 것입니다.
Solver와 proposer의 역할을 나눈다
| 구성 | 역할 | 학습 중 | 테스트 적응 중 |
|---|---|---|---|
| Solver | Harness가 요청한 추론·답변·코드 생성 | 가중치 고정 | 가중치 고정 |
| Proposer | 현재 코드와 실행 report를 읽고 수정안 생성 | 가중치 학습 | 가중치 고정 |
| Harness | Model call·tool use·정보 흐름을 제어 | 수정 후보 실행 | Round마다 수정 |
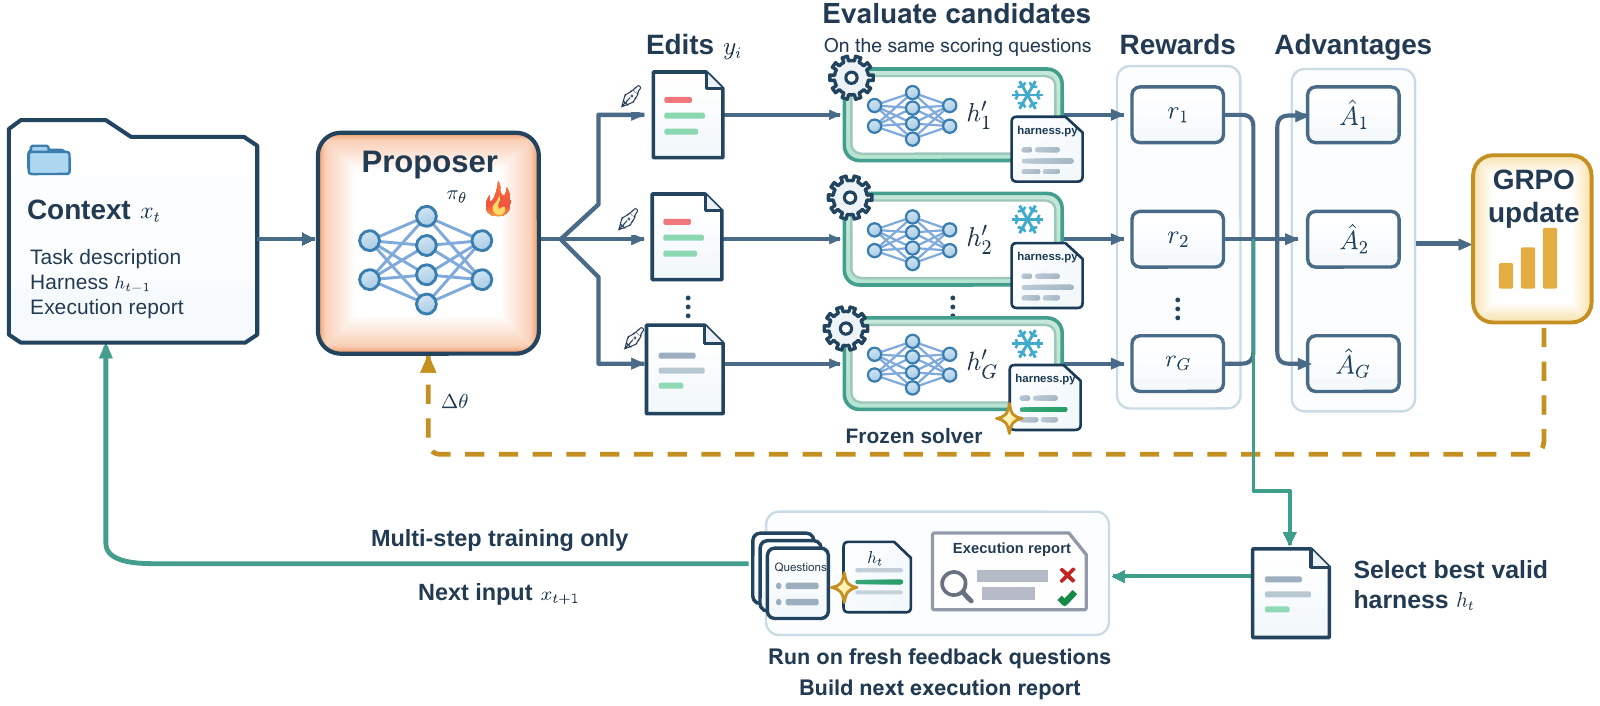
테스트 적응 중에는 solver와 proposer의 가중치가 모두 고정됩니다. Round마다 달라지는 것은 harness 코드입니다. 반면 proposer를 학습하는 동안에는 수정 결과에 대한 보상을 이용해 proposer의 가중치를 갱신합니다. 이 두 시점을 구분해야 “모델을 학습한다”와 “테스트에서 코드를 고친다”가 어떻게 함께 성립하는지 이해할 수 있습니다(§4.2).
한 번의 수정은 어떻게 진행되는가
한 round는 현재 harness를 development 질문에서 실행하는 것으로 시작합니다. 외부 절차가 점수, 실패 사례, 실행 trace, 이전 수정 정보 등을 모아 report를 만듭니다. Proposer는 이 report와 현재 코드를 읽고 수정 후보를 제안합니다(§4.2).
Task + current harness + execution report
                    ↓
           Proposer suggests an edit
                    ↓
          Run and evaluate the harness
                    ↓
           Feedback for the next round
수정 후보는 실제 코드에 적용한 뒤 실행하고 채점합니다. 이때 답을 잘 맞혔는지만큼 수정안이 파싱되고 적용되며 실행을 완료하는지도 중요합니다. 학습 보상에는 task score와 validity가 함께 들어갑니다. Reasoning Gym의 수정 인터페이스는 SEARCH/REPLACE edit와 변경 설명을 받고, QA는 짧은 diagnosis와 Python code block을 받습니다(§4.2, App. D.2, E.1–E.2).
후보를 만들었다고 무조건 다음 round에 채택하는 것은 아닙니다. Reasoning Gym은 dev 점수가 기존 harness보다 높을 때만 수정안을 채택합니다. QA는 scoring 점수가 가장 높은 후보로 진행하며, 그 점수가 기존 harness보다 낮을 수도 있습니다. 그러므로 “반복 수정”이라는 이름이 같아도 다음 harness를 선택하는 규칙은 설정별로 확인해야 합니다(App. B.1, D.3).
또한 이 구현의 proposer가 직접 도구를 선택해 코드를 조사하거나 테스트를 설계하는 것은 아닙니다. 외부 절차가 만들어 준 report를 읽고 수정안을 제출합니다. 자율적인 코딩 에이전트 전체를 학습하는 방법으로 넓혀 해석하면 실제 실험의 범위를 벗어납니다(App. F).
학습하는 능력과 테스트에서 바꾸는 대상을 구분한다
논문은 이 구조를 meta-learning으로 설명합니다. Inner loop는 가중치가 고정된 proposer가 새로운 task의 harness를 반복 수정하는 과정입니다. Outer loop는 그런 수정이 잘 나오도록 proposer의 가중치를 학습하는 과정입니다. 일반적인 gradient 기반 적응에서의 weight update에 harness revision을 대응시키는 관점입니다(§4.2).
Reasoning Gym에서는 teacher가 성공한 첫 수정 432개로 SFT한 뒤 RL을 수행합니다. QA에서는 SFT 없이 base proposer에서 직접 RL합니다. 두 경우 모두 수정의 유용성을 학습하지만 초기 학습 절차는 서로 다릅니다(App. B.2–B.3, D.2).
Single-step RL과 Multistep RL도 구분할 필요가 있습니다. 전자는 개별 수정 context를 학습에 사용하고, 후자는 앞선 수정에서 나온 harness와 report를 다음 학습 입력으로 사용합니다. 둘 다 각 수정의 즉시 보상으로 학습하며, 어느 쪽도 테스트에서 여러 round를 수행할 수 있습니다. Multistep이라는 이름이 전체 수정 경로의 마지막 보상으로 학습한다는 뜻은 아닙니다(§4.3).
수식으로 보면 무엇을 평가하고 선택하는가
질문 집합 $Q$에서 harness $h$의 평균 점수는 다음과 같이 정의합니다. $\operatorname{score}(h,q)$는 harness $h$로 질문 $q$를 풀었을 때의 점수이며, $J$는 그 질문 집합 전체의 평균입니다(§4.1, Eq. 3).
\[J(h;Q)=\frac{1}{|Q|}\sum_{q\in Q}\operatorname{score}(h,q).\]다만 같은 점수 함수라도 어떤 질문 집합에서 계산하느냐에 따라 역할이 다릅니다. $Q^{\mathrm{fb}}$는 report를 만들기 위한 질문, $Q^{\mathrm{score}}$는 수정 후보를 채점하고 선택하기 위한 질문, $Q^{\mathrm{eval}}$는 적응이 끝난 뒤 최종 성능을 측정하기 위한 질문입니다.
학습에서는 feedback과 scoring 질문을 분리합니다. 테스트 적응에서는 Reasoning Gym이 같은 dev 질문으로 feedback과 선택을 수행하고, QA는 round 안에서 두 집합을 나눕니다. 최종 held-out 질문은 어느 쪽에서도 적응에 사용하지 않습니다. 방법을 이해할 때는 무엇이 바뀌는가뿐 아니라, 어떤 피드백이 그 변경을 허용하는지도 함께 봐야 합니다(§4.1, App. B.1, D.3).
원 정리의 방법·수식 상세
전체 loop: Figure 1 — Harness learning, Figure 2 — RL training.
Solver는 문제를 풀고, proposer는 풀이 프로그램을 고친다
| 구성 | 역할 | 학습 중 | 테스트 적응 중 |
|---|---|---|---|
| Solver | harness가 요청한 추론·답변·코드 생성 수행 | 가중치 고정 | 가중치 고정 |
| Proposer | 현재 harness와 report를 읽고 수정안 생성 | 가중치 업데이트 | 가중치 고정 |
| Harness | model call·tool use·정보 흐름을 제어하는 실행 코드 | 후보를 생성하고 실행 | round마다 수정 |
한 round는 현재 harness 실행 → report 작성 → 수정 후보 생성 → 후보 실행·채점 → 다음 harness 선택으로 진행된다. report에는 점수뿐 아니라 실패 사례, 실행 trace, 이전 수정 정보 등이 들어간다. Reasoning Gym의 구조화된 인터페이스는 SEARCH/REPLACE edit와 변경 설명을 받는다. QA는 짧은 diagnosis와 Python code block을 받는다(§4.2, App. D.2, E.1–E.2).
proposer가 직접 tool을 골라 코드를 조사하거나 테스트를 설계하는 agent는 아니다. 현재 구현은 외부 절차가 만들어 주는 report를 읽고 수정안을 제출한다(App. F).
Meta-learning에서 실제로 학습되는 것
Inner loop는 frozen proposer가 새 task의 harness를 반복 수정하는 과정이다. Outer loop는 좋은 수정이 나오도록 proposer의 가중치를 학습하는 과정이다. 논문은 harness revision을 gradient-based adaptation의 weight update에 대응시킨다(§4.2).
Reasoning Gym은 teacher의 성공적인 첫 수정 432개로 SFT한 뒤 RL한다. Teacher는 Qwen3.6-35B-A3B이고, SFT는 21-family에서 수집한다. RL은 5-family의 640-context를 사용하며, 일부 context의 parent는 seed보다 강한 harness다. QA는 SFT 없이 base proposer에서 직접 RL하며, Single-step RL의 parent는 항상 seed다(App. B.2–B.3, D.2).
Single-step RL과 Multistep RL은 학습 입력의 차이다. 전자는 개별 revision context를 사용하고, 후자는 앞선 수정에서 나온 harness·report를 다음 학습 입력으로 사용한다. 둘 다 각 수정의 즉시 reward로 학습하며, 어느 proposer든 테스트에서는 여러 round를 수행할 수 있다. Multistep RL이 긴 revision chain 전체의 최종 reward로 credit assignment를 하는 것은 아니다(§4.3).
정의와 수식
harness의 질문 집합 평균 점수는 다음과 같다(§4.1, Eq. 3). \(J(h;Q)=\frac{1}{|Q|}\sum_{q\in Q}\operatorname{score}(h,q).\) 각 round의 입력을 $x_t=(\text{task},h_{t-1},\text{report})$라 하면 후보를 만들고 선택한다(§4.2, Eq. 4). \(y_i\sim\pi_\theta(\cdot\mid x_t),\qquad h'_i=\operatorname{Apply}(h_{t-1},y_i),\qquad h_t=\operatorname{Select}(h_{t-1},\{h'_i\};Q_t^{\mathrm{score}}).\) outer-loop 목표는 최종 harness의 held-out 성능 $\max_\theta\mathbb E[J(h_T;Q^{\mathrm{eval}})]$다. 실제 training은 이를 개별 후보의 task score + validity reward로 근사하며 GRPO를 사용한다(§4.2–4.3, Eq. 5–6).
Reasoning Gym의 validity term은 response parse 0.05 + edit 적용 0.10 + 실행 완료 비율 × 0.15다. 따라서 모든 문제를 실행했지만 답을 전부 틀린 후보도 reward 0.30을 받는다. QA는 parse·run entry point·200-line 제한·scoring run 완료 조건을 통과하면 EM에 0.1을 더한다(App. B.3, D.2).
질문 집합의 역할도 구분한다. $Q^{\mathrm{fb}}$는 report, $Q^{\mathrm{score}}$는 후보 채점·선택, $Q^{\mathrm{eval}}$는 최종 성능 측정이다. 학습에서는 feedback과 scoring 질문을 분리한다. 테스트 적응에서는 Reasoning Gym이 같은 dev 질문으로 feedback과 선택을 하고, QA는 round 안에서 둘을 분리한다. 최종 held-out 질문은 양쪽 모두 adaptation에 쓰지 않는다(§4.1, App. B.1, D.3).
실험과 핵심 결과
실험 설정
| 항목 | Reasoning Gym | Multi-hop QA |
|---|---|---|
| Proposer / solver | Qwen3.5-4B / Qwen3.5-4B | Qwen3-4B / Qwen3-8B |
| 학습 | 21-family SFT, 5-family RL | HotpotQA 2,000-question pool에서 RL |
| Unseen 평가 | SFT·RL에 없는 family | MuSiQue, 2WikiMultihopQA |
| Seed | solver 한 번 호출 후 답 추출 | 두 hop 검색·요약 후 답변 |
| Feedback / held-out | family당 dev 25 / held-out 75 | dev pool 각 500 / test 300·299·300 |
| 독립 수정 평가 | seed에서 8개 proposal | seed에서 80개 proposal |
| 반복 수정 평가 | 5-round, round당 1개 proposal | 4-run × 10-round, round당 8개 proposal |
| 다음 harness 선택 | dev 점수가 parent보다 높을 때만 채택 | scoring 최고 후보로 진행, parent보다 낮아도 채택 |
근거: Table 1, App. B.1, D.1–D.3. QA 적응의 각 run·round에는 feedback 6문항, scoring 64문항이 쓰인다. 정답 여부·gold answer와 검색한/놓친 supporting document 정보도 report에 포함된다. dev 질문은 round 간 재사용될 수 있다.
HotpotQA는 full-wiki 5.23M abstracts를 검색하지만, MuSiQue·2Wiki는 dev 질문들의 support·distractor paragraph를 모은 21,100 / 54,957 paragraph corpus를 검색한다. 따라서 세 benchmark의 retrieval 난도가 동일한 설정은 아니다(App. D.1, Table 22).
Finding 1 — 새로운 family에서도 평균 수정 품질이 좋아진다
아래는 format-varied, unseen 21-family, 각 family의 8개 proposal 전체에 대한 held-out 점수다. 평균과 oracle best-of-eight를 구분한다(Table 9, Figure 3).
| Proposer / baseline | 평균 | Oracle best-of-eight |
|---|---|---|
| Base proposer | 0.32 | 0.63 |
| SFT | 0.49 | 0.78 |
| Single-step RL | 0.62 | 0.83 |
| Teacher 35B | 0.56 | 0.85 |
| 고정 Python tool-loop harness | 0.69 | 해당 없음 |
RL 후에는 좋은 후보 하나를 운 좋게 뽑는 것뿐 아니라 전체 proposal 평균도 높아진다. 4B proposer가 teacher보다 높은 것은 이 평균이며, teacher는 oracle best-of-eight에서 여전히 높다(§5.2).
대표 21-family는 전체 unseen 26-family에서 knight_swap, letter_jumble, modulo_grid, sokoban, ab를 제외한 것이다. 저자들은 양쪽 proposer와 teacher가 algorithmic harness로 다루기 어려운 family라고 설명한다. 26개 전체 평균도 Base 0.282 → SFT 0.415 → Single-step RL 0.528로 개선되며 teacher는 0.501이다(App. B.1). 제외 후의 0.62를 전체 unseen 평균으로 부르면 안 된다.
Reasoning Gym 평가에서는 적용되지 않은 edit와 명시적 no-change가 parent 점수를 유지한다. 실행 가능한데 점수가 0인 harness는 평균에 포함한다. 별도 19-family 분석에서는 실패 edit를 0으로 처리하거나 제외해도 RL의 teacher 대비 우위가 유지된다. 이 분석 집합은 대표 21-family와 다르다(App. B.1, C.1).
Finding 2 — 한 번의 수정을 학습해도 반복 개선에 사용할 수 있다
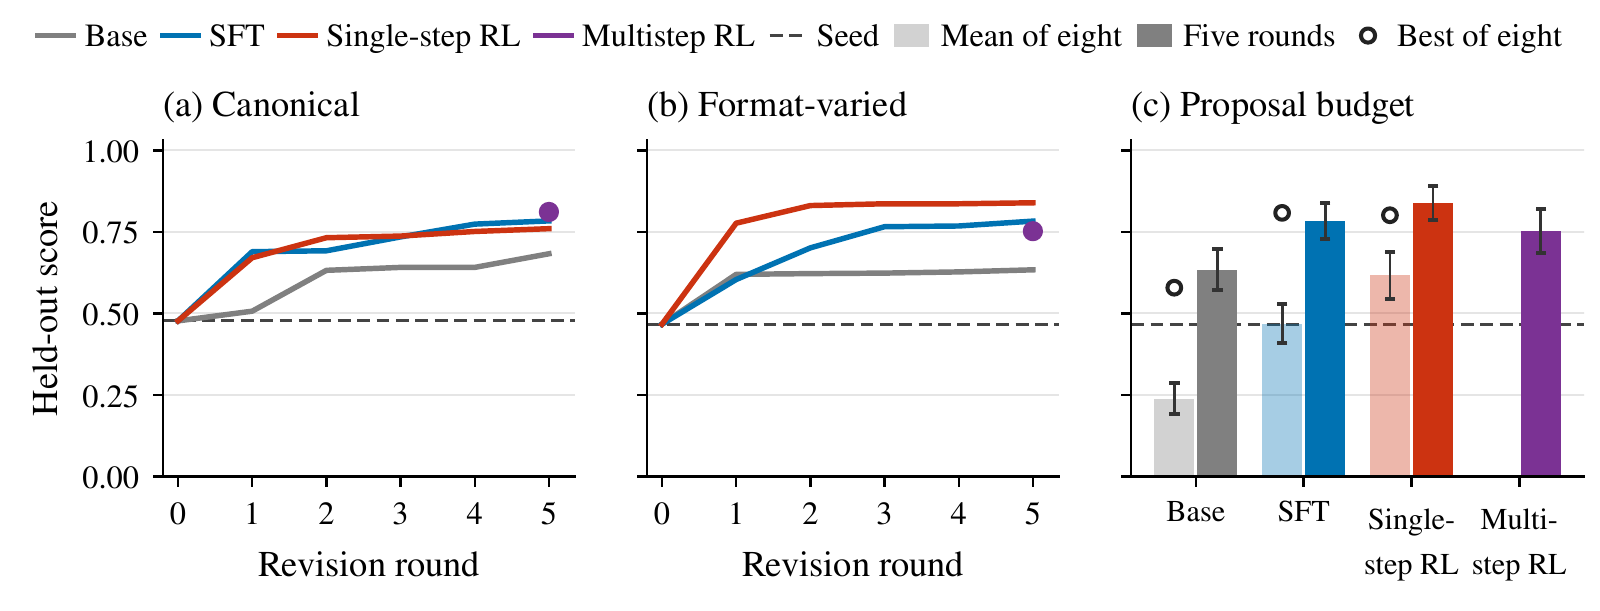
Reasoning Gym의 공통 unseen 15-family 비교에서 5번의 순차 수정으로 얻은 harness는 독립 8개 proposal 평균보다 높고, oracle best-of-eight에 접근하거나 이를 넘는다. Format-varied에서는 Single-step RL의 개선 대부분이 첫 round에 나타나며, 이후 이득은 작다(§5.2, Figure 4).
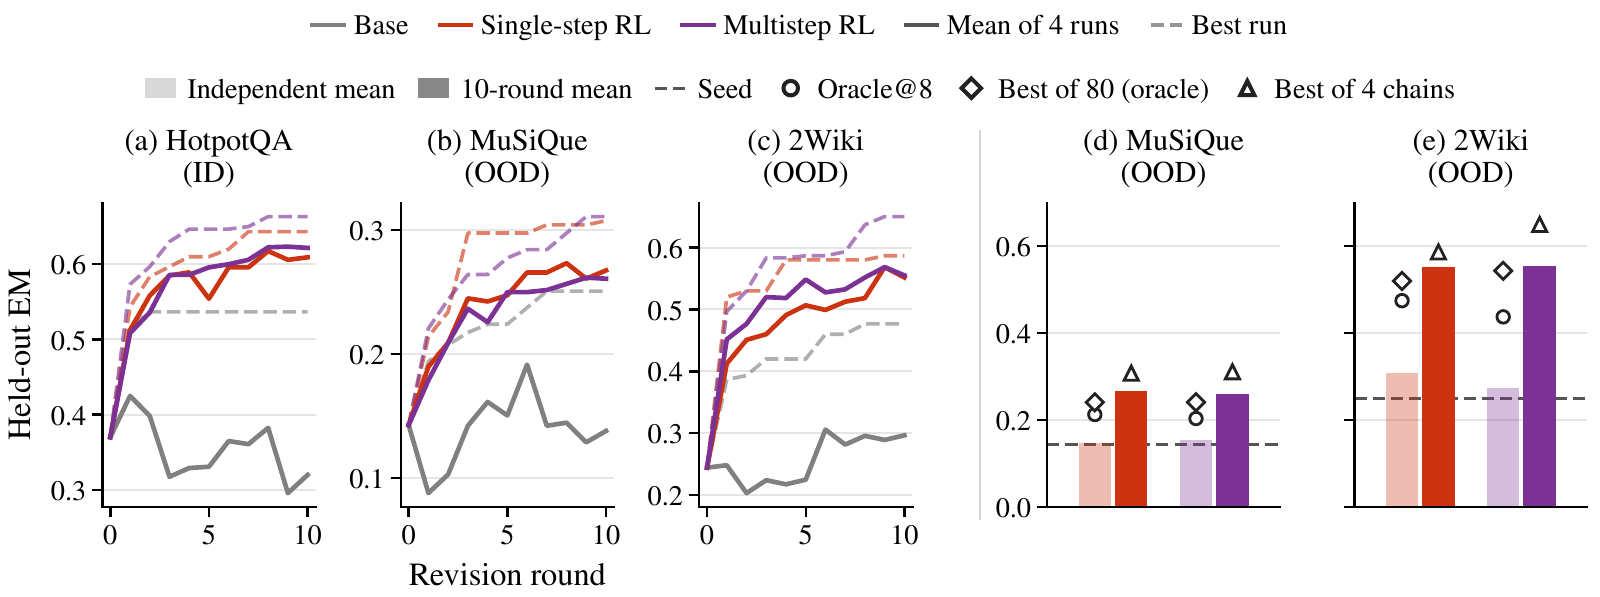
QA에서는 개선이 더 오래 누적된다. MuSiQue의 Single-step RL은 독립 수정 평균 EM이 0.1467로 seed 0.1438과 가깝지만, 10-round 후에는 본문에 0.27로 보고된다. 두 unseen QA benchmark 모두 RL proposer의 마지막 round 평균은 독립 80개 후보의 oracle best보다 높다(§5.3, Figure 5, Table 24).
이 비교는 run당 proposal 수 80개를 맞춘 것이다. 순차 수정은 중간 harness에서 새 feedback을 얻고 후보를 scoring set으로 선택한다. 독립 후보는 seed report 네 개를 공유한다. 총 compute·feedback은 같지 않고, 네 run 중 held-out 최고 성능은 총 320개 proposal을 사용한다. 논문도 best-run과 best-of-80을 같은 예산 비교로 보지 않는다(App. D.4).
그림: Figure 4 — Reasoning Gym 반복 수정, Figure 5 — QA 반복·독립 수정.
Finding 3 — Multistep RL이 Single-step RL을 일관되게 넘지는 않는다
확장 Reasoning Gym format별 24-family 전체에서 5-round 후 retained harness의 held-out 평균은 다음과 같다. canonical과 format-varied의 family 목록은 다르고, seen·unseen이 함께 들어간 평균이다(App. C.2의 held-out summary).
| 학습 설정 | Canonical | Format-varied |
|---|---|---|
| Base | 0.593 | 0.498 |
| SFT | 0.698 | 0.688 |
| Single-step RL | 0.699 | 0.725 |
| Multistep RL | 0.701 | 0.649 |
QA의 두 RL 설정도 최종 점수는 거의 같다. 저자들은 반복 적응이 가능함과 반복 state로 학습하는 것이 더 좋음을 별개로 결론 낸다. 현재 reward는 각 수정에 국소적이므로, 여러 round에 걸친 credit assignment의 효과는 남아 있다(§5.4, §6.3).
추가 multistep family는 앞선 single-step 성능 순서 등을 일부 기준으로 골랐고, 추가 family당 run은 하나다. 무작위로 뽑은 전체 task population을 대표하는 평균으로 읽을 수는 없다(App. C.2).
Finding 4 — 신뢰할 만한 후보가 늘고, 정보 흐름이 바뀐다
별도 unseen 5-family, 40-proposal 분석에서 failed edit 또는 dev 0점의 합계 비율은 Base 38%, SFT 35%, Single-step RL 8%다. 이 수치는 대표 21-family 전체의 failure rate가 아니다. 0점이라는 사실만으로 코드가 invalid하다는 뜻도 아니다(§6.1, Table 10).
Reasoning Gym에서는 solver가 코드를 만들고 runtime이 실행하는 interpreter loop가 흔하다. 기본 지시문하의 unseen-family audit에서 Single-step RL 40개 중 31개가 이 유형이다. helper를 tool loop에 붙이라고 지시한 별도 audit에서는 구조적 composition 12/32개 중 실제 답변에 helper가 기여한 경우가 3/32개였다. 올바른 알고리즘이 있어도 parsing·tool message·answer extraction이 깨지면 효과가 없다(§6.2, Table 18, App. C.4).
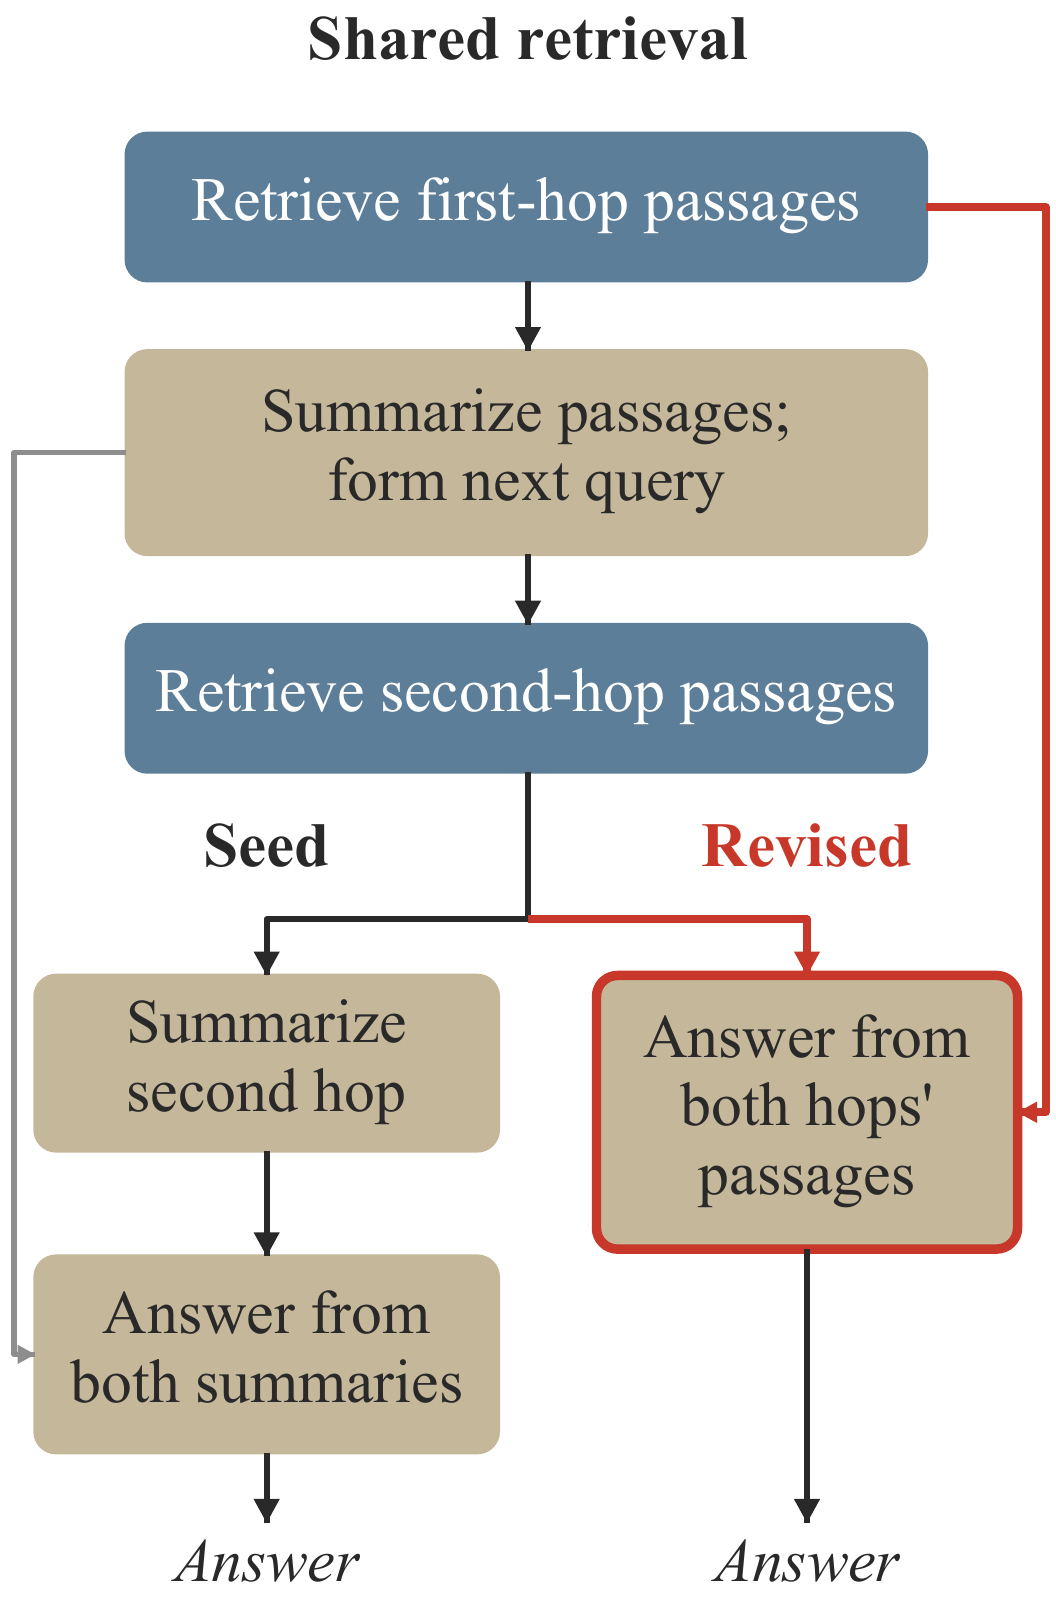
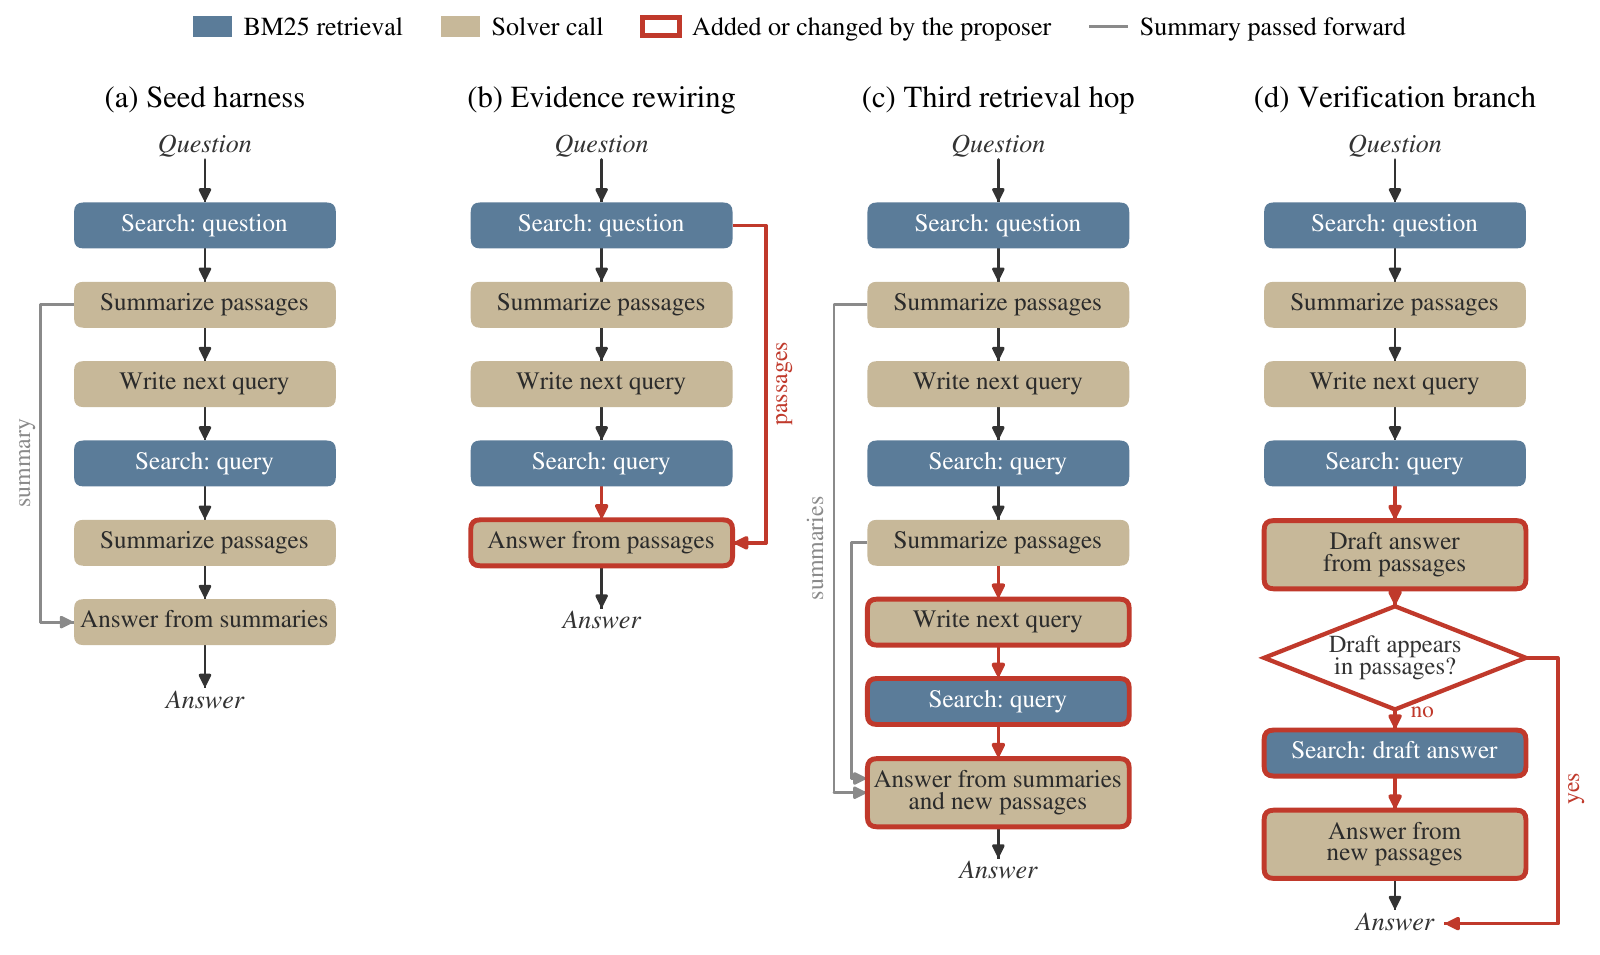
QA의 반복 수정은 더 구체적인 정보 흐름을 바꾼다. seed는 두 hop의 요약으로 최종 답변을 만들지만, 흔한 RL revision은 요약을 다음 검색에 쓰고 최종 답변에는 retrieved passage 원문을 보여 준다. 세 번째 검색을 추가하거나, draft answer가 passage에 없으면 다시 검색하는 수정도 나온다(§6.2).
예시: Figure 7 — 답변에 passage 직접 전달, Figure 15 — Seed와 학습한 QA revision들.
한계와 해석
저자들이 밝힌 한계
- Supervision의 다양성: Reasoning Gym SFT는 단일 teacher의 첫-round 수정이며 interpreter loop·직접 알고리즘에 집중된다. 일부 데이터 수집에는 tool-use 유도 지시문도 쓰였다. 더 강한 teacher나 multistep demonstration의 효과는 남아 있다(App. B.2, F).
- 조사의 자율성: proposer가 직접 code inspection·targeted test·후보 비교 과정을 고르지 않는다. 이를 tool-using agent로 학습하는 방향을 제안한다(App. F).
- Solver 고정: proposer·solver의 joint training이나 solver가 바뀐 뒤 revision skill이 유지되는지는 실험하지 않았다(App. F).
- 반복 개선의 원인 분리: 독립·순차 실험은 feedback뿐 아니라 parent·prompt·선택도 달라 feedback 자체의 기여를 분리하지 못한다. RG·QA의 누적 개선 차이도 seed 하나의 차이로만 돌릴 수 없다(App. B.1, §6.3).
- 긴 horizon: round 전체의 credit assignment와 더 긴 tool-use·decision trajectory로의 전이는 후속 과제다(§6.3, App. F).
AI의 해석
아래는 논문의 주장이 아니라 정리자(Codex)의 해석이다.
- 일반화되는 것은 수정 규칙이다. unseen task에서도 development feedback으로 새 harness를 만든다. 한 번 만든 완성 harness가 모든 task를 바로 푼다는 결과와 구분해야 한다. 이 점이 train family와 test family를 분리한 설계의 핵심이다(§4–5).
- 이 실험의 test-time adaptation은 채점 가능한 development 환경을 전제한다. QA report는 정답·supporting document 정보까지 제공한다. 실제 배포에서 성공 여부를 모를 때의 자기 개선으로 확장하려면, feedback의 정확도·가용성을 바꾼 실험이 필요하다(App. D.3, E.2).
- Tool-loop baseline 0.69는 실용적인 기준점이다. 평균 revision이 teacher를 넘는 결과는 있지만, 대표 family 평균에서는 이미 준비된 고정 Python loop가 더 높다. 학습한 editor의 가치는 정적 baseline을 넘어서는 task·반복 적응·비용 조건에서 더 분명히 검증할 수 있다(Table 9).
- Meta-learning은 프레임과 학습 구현을 나눠 봐야 한다. 최종 adaptation 성능을 목표로 정의하지만 실제 update는 즉시 후보 reward에 기반한다. Multistep RL의 불확실한 이득은 이 데이터·reward·state 구성의 결과이며, 장기 meta-objective 전반의 한계로 확대할 수 없다(§4.2–4.3, §6.3).
- Teacher 초과의 의미는 reliability와 함께 봐야 한다. 평균은 RL이 높고 oracle upper tail은 teacher가 높다. 실행 가능한 후보를 꾸준히 만드는 능력과 가장 강한 설계를 가끔 만드는 능력을 분리해 측정하면 proposer 선택 기준이 더 명확해진다(§5.2, §6.1).
더 생각해볼 질문
아래는 AI가 정리 과정에서 제안한 후속 질문입니다. 본인이 직접 작성한 의견이나 논문에서 검증한 결과로 표시하지 않습니다.
💭 연구 아이디어 — 아래는 이 논문의 검증 결과가 아니다.
- LiteEvo와 연결: 실패를 분석해 component library를 쌓는 절차에, 학습된 proposer를 넣으면 새로운 환경의 적응 비용이 줄까? 단일 frozen editor·learned editor·library 결합을 같은 solver·feedback·총 실행 예산으로 비교할 수 있다.
- Agent Plasticity와 연결: 최고 점수뿐 아니라 feedback 질문 수·실행 token·wall-clock에 따른 개선 곡선을 측정하면 어떤 proposer가 경험을 가장 효율적으로 쓰는가? 순차 수정과 독립 탐색의 비용을 함께 셀 필요가 있다.
- Environmental Novelty와 연결: API나 출력 문법이 바뀐 환경에서는 알고리즘 생성보다 interface repair를 잘하는 proposer가 유리할까? 변화 유형별 recovery 속도와 회귀를 분리할 수 있다.
- 장기 credit assignment: 즉시 점수는 낮추지만 이후 유용한 trace·모듈을 만드는 수정에 가치를 줄 수 있을까? 같은 후보 pool에서 즉시 reward와 여러-round return을 비교하는 실험이 필요하다.
- Feedback ablation: gold answer, support-document 진단, binary correctness, trace-only를 차례로 제거하면 전이 성능은 어디서 무너지는가? 정답 없는 배포 환경으로 가는 데 필요한 정보가 무엇인지 드러날 수 있다.
참고자료
정리 범위와 근거 메모
근거: v1 원문, PDF, LaTeX 진입점. 본문과 부록 A–F의 방법·평가·분석을 읽고, 수치는 본문·표의 명시값을 사용했다. 아래 아래 AI 해석·후속 질문은 정리자 해석과 연구 질문이다.
용어 정리
| 용어 | 이 논문에서의 뜻 |
|---|---|
| Harness | model call·tool use·직접 계산·정보 흐름을 정하는 실행 프로그램 |
| Proposer | harness와 execution feedback으로 수정안을 생성하는 학습 모델 |
| Solver | harness의 지시에 따라 문제를 푸는 frozen 모델 |
| Meta-learning | task 경험으로 새 task의 adaptation 절차를 학습하는 관점 |
| Single-step / Multistep RL | 학습 context의 구성 차이. 테스트 revision round 수와는 별개 |
| Unseen / OOD | proposer의 SFT·RL에서 제외한 family 또는 benchmark |
| Format-varied | 같은 task를 benchmark 표준과 다른 질문 형식으로 제시 |
| Oracle best-of-N | held-out 점수를 보고 N개 후보 중 최고를 고른 통계. 배포 가능한 선택 규칙은 아님 |
| Structural / functional composition | helper가 tool loop에 연결됨 / 실제 답변에 기여함 |
주요 원자료: 방법, Reasoning Gym protocol, family별 점수, 추가 분석, QA protocol, 독립 QA 점수.