EvoHarness-RL: Learning Runtime Harness Coordination for Self-Evolving Agents ↗
Xuying Ning, Dongqi Fu, Tianxin Wei, Yuanchen Bei, Xiyuan Yang, Wujiang Xu, Yueqi Song, Bingxuan Li, Zihao Li, Hanqing Zeng, Xiang Shen, Yajuan Wang, Yifan Wu, Qifan Wang, Jiayi Liu, Hong Li, Yinglong Xia, Xiangjun Fan, Hanghang Tong, Jingrui He
arXiv preprint; Accepted to LLA@COLM 2026 (arXiv comments 기준)
- 문제: 외부 memory와 planner가 있어도 언제 활용할지 고정하면 모델·환경에 맞춰 조절하기 어렵다.
- 방법: Belief·Progress·Experience를 track·commit·recall·note action으로 사용하도록 SFT와 cost-aware GRPO를 수행한다.
- 결과: 여러 환경에서 성공률을 높이면서 harness 호출을 줄이며, 각 meta-action도 interaction 예산을 소비한다.
문제와 배경
배경과 읽는 관점
Agent에 상태 추적기와 메모리를 붙이는 것만으로 그 지원이 언제나 유용해지는 것은 아니다. 매 step 같은 정보를 넣으면 불필요한 조회가 생기고, 필요한 순간에 호출하지 않으면 이미 얻은 정보도 활용하지 못한다. 이 논문은 외부 지원의 존재보다 그 지원과 상호작용하는 policy에 초점을 맞춘다.
기존 접근과 연구 질문
agent가 여러 단계의 작업을 수행하다 보면 물건이 어디 있었는지 잊고, 이미 끝낸 일을 반복하고, 이전 실패에서 배운 절차를 재사용하지 못한다. 이를 보완하는 state tracker·planner·memory는 이미 많지만, 환경마다 표현과 호출 규칙이 다르고 언제 사용할지도 prompt나 heuristic으로 고정되어 있는 경우가 많다(§1–2.1).
저자들의 질문은 다음과 같다. 모델과 task, 학습 단계에 따라 외부 지원의 필요성이 달라진다면, harness와의 상호작용도 학습 가능한 action으로 만들 수 있지 않을까? 같은 정보를 매번 넣는 scaffold에서 출발해, 필요한 순간에 필요한 부분을 이용하는 policy로 옮겨 가는 것이 목표다.
전체 구조: Figure 1 — BPE와 네 meta-action.
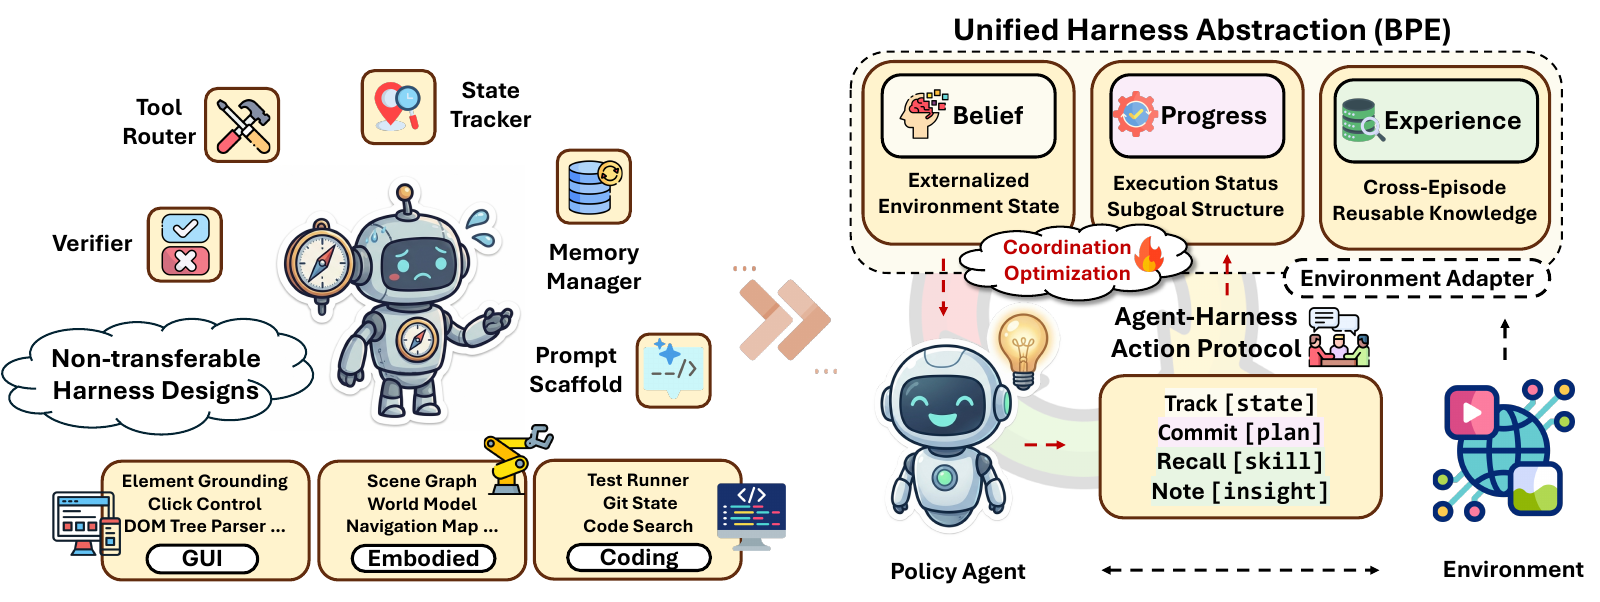
핵심 질문은 환경에서 행동할 것인지, 상태·계획·경험을 조회하거나 갱신할 것인지를 같은 예산 안에서 학습할 수 있는가다. 읽을 때는 policy의 학습과 외부 Experience bank의 갱신을 나누고, episode 안에서 유지되는 상태와 episode 사이에 남는 경험을 구분해야 한다.
핵심 아이디어
먼저 직관으로 이해하기
메모리를 자동으로 항상 보여 주는 대신, 조회와 기록을 명시적인 action으로 만든다. 각 호출이 환경 action과 마찬가지로 한 step을 소비하면, policy는 외부 정보를 이용해 얻는 이익과 interaction 비용을 함께 고려하게 된다. SFT로 인터페이스 사용법을 익힌 뒤 RL로 선택적인 사용을 조정하는 구조다.
BPE: 세 종류의 외부 상태
BPE는 모든 환경에서 동일한 자료구조를 쓰라는 규격이 아니라, policy가 보는 기능적 역할을 통일하는 abstraction이다. 구체적인 저장·갱신 방식은 environment adapter가 맡는다(§2.1, App. I).
| 상태 | 보관하는 것 | 수명 | policy action |
|---|---|---|---|
| Belief | 관찰한 환경 상태. 물건 위치·소지품, 상품 후보·가격, 이전 페이지에서 읽은 값 등 | episode 안 | track [query]: 관련 부분 조회 |
| Progress | 현재 subgoal과 완료·미완료 요구사항 | episode 안 | commit [subgoal]: 진행 기록 갱신 |
| Experience | 재사용할 일반 원칙·task별 절차·실패 교정 | episode 사이에 유지 | recall [query]: 조회; note [insight]: 이후 consolidation의 증거 기록 |
Belief의 기반 store는 환경 interaction마다 갱신된다. adaptive policy의 track은 store를 읽으며 상태 자체를 바꾸지 않는다. note도 persistent bank를 즉시 고치지 않는다. worker-local buffer에 제안·교정 근거를 남기고, 나중에 evolver가 trajectory·결과와 대조한다(App. I).
Base → SFT → RL
| 변형 | agent에게 BPE를 보여 주는 방식 | policy 학습 |
|---|---|---|
| EvoHarness-Base | adapter가 매 step compact BPE를 자동 구성·표시. policy는 환경 action만 선택 | 없음 |
| EvoHarness-SFT | 네 meta-action을 직접 선택해야 해당 내용을 읽거나 갱신 | 성공 teacher trajectory imitation |
| EvoHarness-RL | SFT와 같은 adaptive interface | SFT 이후 cost-aware GRPO |
Base의 자동 BPE 표시는 별도 interaction step을 소비하지 않는다. SFT/RL에서는 각 meta-action이 환경 action과 동일하게 한 step을 소비한다. 외부 지원을 쓸지, 그 한 step으로 환경에서 행동할지가 같은 예산 안의 선택이 된다(§2.2, App. I).
두 학습 단계의 역할은 구분한다(§2.3).
- SFT로 interface 습득: Claude Opus 4.6이 같은 네 action을 사용해 만든 성공 trajectory로 action 문법·의미와 사용 패턴을 익힌다.
- GRPO로 선택적 사용 학습: 성공 여부와 interaction 수를 보고, teacher의 호출 습관을 그대로 따르는 대신 어떤 외부 접근이 현재 상황에서 이득인지 최적화한다.
학습 흐름: Figure 2 — rollout과 reward.
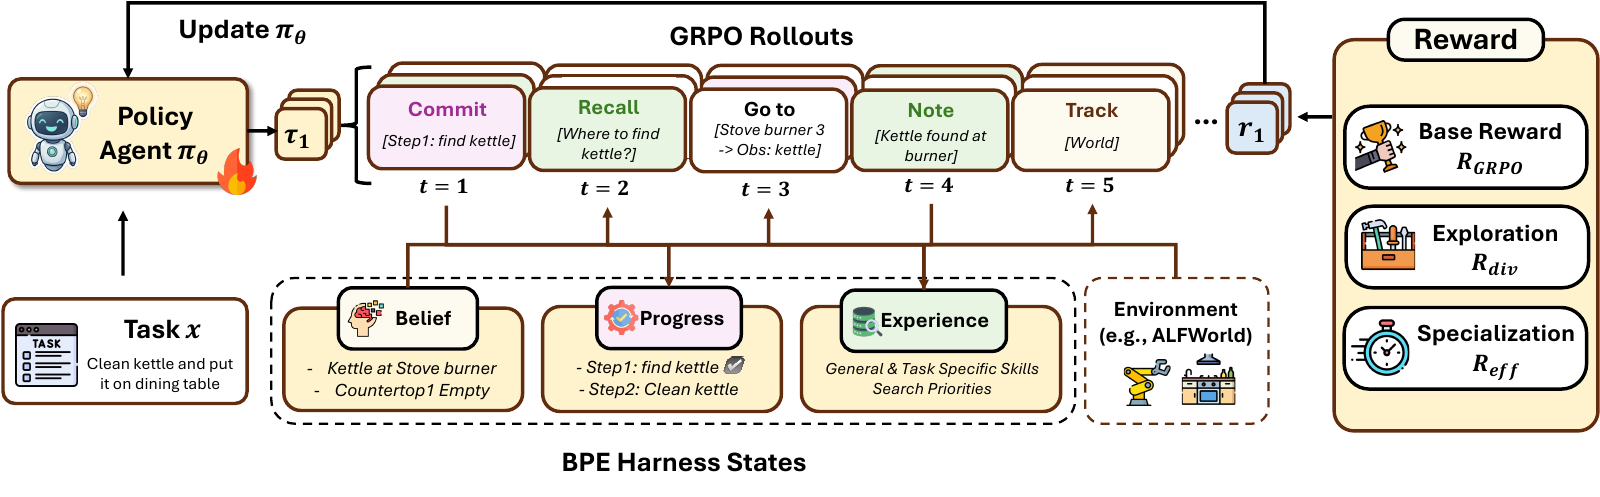
Experience는 batch 사이에서 바뀐다
한 rollout epoch 동안 모든 worker는 같은 고정 Experience snapshot을 쓴다. epoch 끝에 trajectory·성공/실패·note를 모으면 evolver가 general/task-specific 경험을 추출하고, Add / Update / Archive / Skip으로 bank를 정리한다. 새 bank는 다음 epoch부터 쓴다. 각 category 용량은 최대 80개이며 task-specific category 각각에 따로 적용한다(§2.1, App. I, K).
App. H의 kettle 사례를 보자. recall은 kettle이 countertop에 있다고 알려 주지만 실제로는 stoveburner에서 발견된다. agent는 관찰에 맞춰 행동하고 note로 모순을 기록한다. 그 note는 이후 consolidation의 교정 증거가 된다. 현재 관찰과 재사용 경험을 구분하고, 경험도 틀릴 수 있게 설계되어 있다.
정의와 수식
policy는 환경 action과 BPE action을 합친 공간에서 행동한다(§2.2). \(\mathcal H_t=(B_t,P_t,E_t),\qquad \mathcal A=\mathcal A_{\mathrm{env}}\cup\{track,commit,recall,note\}.\) 내부 store 전체인 $\mathcal H_t$와 policy에 현재 노출된 harness context $\mathcal V_t$는 다르다. policy는 관찰 $o_t$, 노출 context $\mathcal V_t$, task context $c_t$를 받아 action을 고른다. \(a_t\sim\pi_\theta(\cdot\mid o_t,\mathcal V_t,c_t).\) trajectory $\tau$, RL epoch $u$에서 reward는 다음과 같다(§2.3, Eq. 5). \(R(\tau;u)=R_{\mathrm{GRPO}}(\tau) +\lambda_{\mathrm{div}}(u)R_{\mathrm{div}}(\tau) +\lambda_{\mathrm{eff}}R_{\mathrm{eff}}(\tau).\) \(R_{\mathrm{div}}(\tau)= \frac{|\{a\in\mathcal A_{\mathrm{bpe}}:a\text{ occurs in }\tau\}|}{4}, \qquad R_{\mathrm{eff}}(\tau)=\mathbf1[\mathrm{succ}(\tau)] \frac{T_{\max}-|\tau|}{T_{\max}}.\)
- Base reward: task 성공과 invalid·degenerate repeated action의 고정 penalty를 포함한다.
- Diversity: 호출 횟수가 아니라 써 본 action 종류의 비율에 보상한다. 네 종류를 한 번씩 쓰면 1이다.
- Efficiency: 성공한 trajectory만 전체 interaction 수를 줄인 만큼 보상한다. 실패를 빨리 끝내는 것에는 이 보상이 붙지 않는다.
diversity 계수는 cosine schedule로 0까지 내리고, efficiency는 학습 내내 유지한다. \(\lambda_{\mathrm{div}}(u)=\frac{\lambda_{\mathrm{div}}^{\max}}2 \left(1+\cos\left(\pi\frac{\min(u,U)}U\right)\right).\) 초기에는 utility를 충분히 시험하기도 전에 새 action을 버리지 않도록 탐색을 돕고, 이후에는 성공과 interaction 효율로 사용 여부를 결정하게 한다. App. F는 이 설명을 조건부로 뒷받침한다. 고정 policy·고정 bank에서 유용한 BPE 정보가 오류·비용을 상쇄하면 성공 trajectory 발견에 필요한 rollout 수가 줄고, bounded diversity bonus의 목적함수 교란은 계수가 0이 되면 사라진다. Neural GRPO의 전역 수렴이나 학습 속도 향상 자체를 증명한 것은 아니다(App. F.3).
실험과 핵심 결과
실험 설정
| 항목 | ALFWorld | WebShop | WebArena |
|---|---|---|---|
| 과제 | 탐색·배치·세척·가열·냉각 등 6종 | 조건에 맞는 상품 탐색·구매 | Shopping·CMS·Maps·GitLab/Reddit workflow |
| 성공 teacher trajectory | 87 | 423 | 187 |
| SFT epoch | 4 | 4 | 3 |
| GRPO update | 150 | 150 | 300 |
| Group size / prompts per update | 8 / 16 | 8 / 16 | 4 / 32 |
| 학습 interaction 한도 | 70 | 20 | 8→10→15 curriculum |
| 평가 interaction 한도 | 50 | 20 | 15 |
| Recall top-k | 3 | 6 | 3 |
주 policy는 Qwen3-8B, 추가 규모 실험은 Qwen3-4B다. SFT는 LoRA rank 64·scaling 128이며 merged checkpoint에서 full-parameter GRPO를 시작한다. update마다 128개 trajectory를 쓴다. RL hardware는 ALFWorld·WebShop 각각 8×H200, WebArena 16×H200이다(App. K).
ALFWorld·WebShop은 SkillRL의 train/validation split을 사용한다. ALFWorld 주 표는 140-task seen split이며 별도로 unseen split을 평가한다. WebArena는 AgentGym-RL의 train 372개·평가 50개 task를 쓰고 backend-edit task는 제외한다(§3.1, App. E).
비교 방법은 ReAct와 frozen memory 방법들(ExpeL, ReasoningBank, MemP, Dynamic Cheatsheet, ACE, SkillOS-base), 학습 방법들(GRPO, SkillOS, SkillRL)이다. ReasoningBank·MemP·SkillOS-base·SkillOS의 ALFWorld/WebShop 값은 SkillOS 논문에서 가져왔고, ALFWorld 평균은 이 논문의 category 구성에 맞게 재계산했다. 나머지는 저자들이 평가했다(App. J).
평가 시 Experience protocol을 구분해야 한다(App. K).
- EvoHarness-RL: 선택된 training checkpoint의 bank를 고정한다. 평가 note는 버리고 consolidation하지 않는다.
- Frontier EvoHarness-Base: bank를 비운 채 시작하고, 평가 중 이미 완료한 episode에서 batch 단위로 경험을 축적한다. policy weights는 고정이다. 미래 episode나 아직 보지 않은 task 정보는 사용하지 않는다.
Finding 1 — Qwen3-8B에서 학습한 coordination이 가장 강하다 (Table 1)
수치는 모두 원문 표의 % 단위다. WebShop Score는 SR와 다른 task 점수다.
| 방법 | ALFWorld seen SR | WebShop SR | WebShop Score | WebArena SR |
|---|---|---|---|---|
| ReAct | 47.8 | 12.0 | 42.9 | 14.0 |
| GRPO | 66.4 | 73.0 | 82.4 | 18.0 |
| SkillRL | 85.0 | 73.2 | 85.5 | 18.0 |
| EvoHarness-Base | 56.4 | 18.6 | 43.7 | 18.0 |
| EvoHarness-SFT | 68.6 | 43.8 | 48.1 | 16.0 |
| EvoHarness-RL | 95.0 | 80.6 | 90.8 | 26.0 |
논문의 +8.5%p는 strongest trainable baseline인 SkillRL에 대한 세 환경 SR 차이의 평균이다. Table 1 맨 오른쪽 Δ는 WebShop Score까지 넣은 네 aggregate metric의 ReAct 대비 평균 차이라서 다른 지표다.
Frontier 모델에 Base만 적용해도 SR가 오른다. ALFWorld / WebShop / WebArena 순으로 Opus 4.6은 96.4→98.6 / 40.2→46.4 / 22.0→34.0, GLM-5는 52.1→77.9 / 46.2→49.6 / 20.0→22.0, GPT-5는 60.7→85.0 / 37.8→46.2 / 20.0→26.0이다. 논문의 평균 +10.0%p는 이 SR 개선을 요약한다. 각 모델의 모든 subdomain이 개선되는 것은 아니다.
Finding 2 — BPE를 주는 것과 선택하도록 학습하는 것 모두 기여한다 (Table 2)
| ALFWorld ablation | Seen SR | Full 대비 하락(%p) |
|---|---|---|
| Full BPE / Full reward | 95.0 | — |
| w/o Belief | 89.3 | 5.7 |
| w/o Progress | 90.7 | 4.3 |
| w/o Experience | 84.3 | 10.7 |
| Always-on BPE | 88.6 | 6.4 |
| w/o SFT | 50.0 | 45.0 |
| Vanilla SFT + GRPO | 87.9 | 7.1 |
| w/o Diversity reward | 92.9 | 2.1 |
| w/o Efficiency reward | 86.4 | 8.6 |
ALFWorld에서는 반복되는 절차·위치 지식 때문에 Experience 제거의 하락이 가장 크다. SFT 없는 RL은 새 action 공간을 탐색하는 데 어려움을 겪고, 같은 supervised-data 예산의 vanilla SFT + GRPO도 full method보다 낮다. Always-on BPE는 별도의 학습 ablation이며, training-free EvoHarness-Base의 56.4와 구분한다(§3.3).
Finding 3 — 호출량이 같아도 action 종류와 선택 방식이 중요하다 (App. G, Table 7)
동일한 최종 checkpoint·고정 bank·decoding을 두고 harness schedule만 바꾼다.
| Schedule | ALFWorld SR |
|---|---|
| Learned | 95.0 |
| Timing Shuffle | 93.6 |
| Type Shuffle | 88.6 |
| Frequency Matched | 90.7 |
호출 빈도를 비슷하게 맞춰도 learned policy를 따라잡지 못한다. 이 실험에서 action 종류를 섞었을 때의 하락은 timing을 섞었을 때보다 크다. 단순히 호출을 많이/적게 하는 것 이상의 coordination을 배웠다는 근거다.
Finding 4 — Unseen에서도 이득이 유지되지만, cross-domain 적응과는 구분한다 (Table 3, App. C)
| Qwen3-8B 방법 | ALFWorld unseen SR |
|---|---|
| ReAct | 50.0 |
| EvoHarness-Base | 77.6 |
| EvoHarness-SFT | 69.4 |
| Vanilla SFT + GRPO | 77.6 |
| Always-on BPE | 90.3 |
| EvoHarness-RL | 94.8 |
94.8은 vanilla SFT + GRPO 77.6보다 17.2%p, 논문 표현으로 22.2% 상대 개선이다. Opus 4.6의 Base는 91.0→97.8로 오른다. 저자들은 state·progress·experience의 externalization이 과적합을 줄일 수 있다고 설명하지만, 본문에서도 가능한 설명으로 제시한다(§3.4).
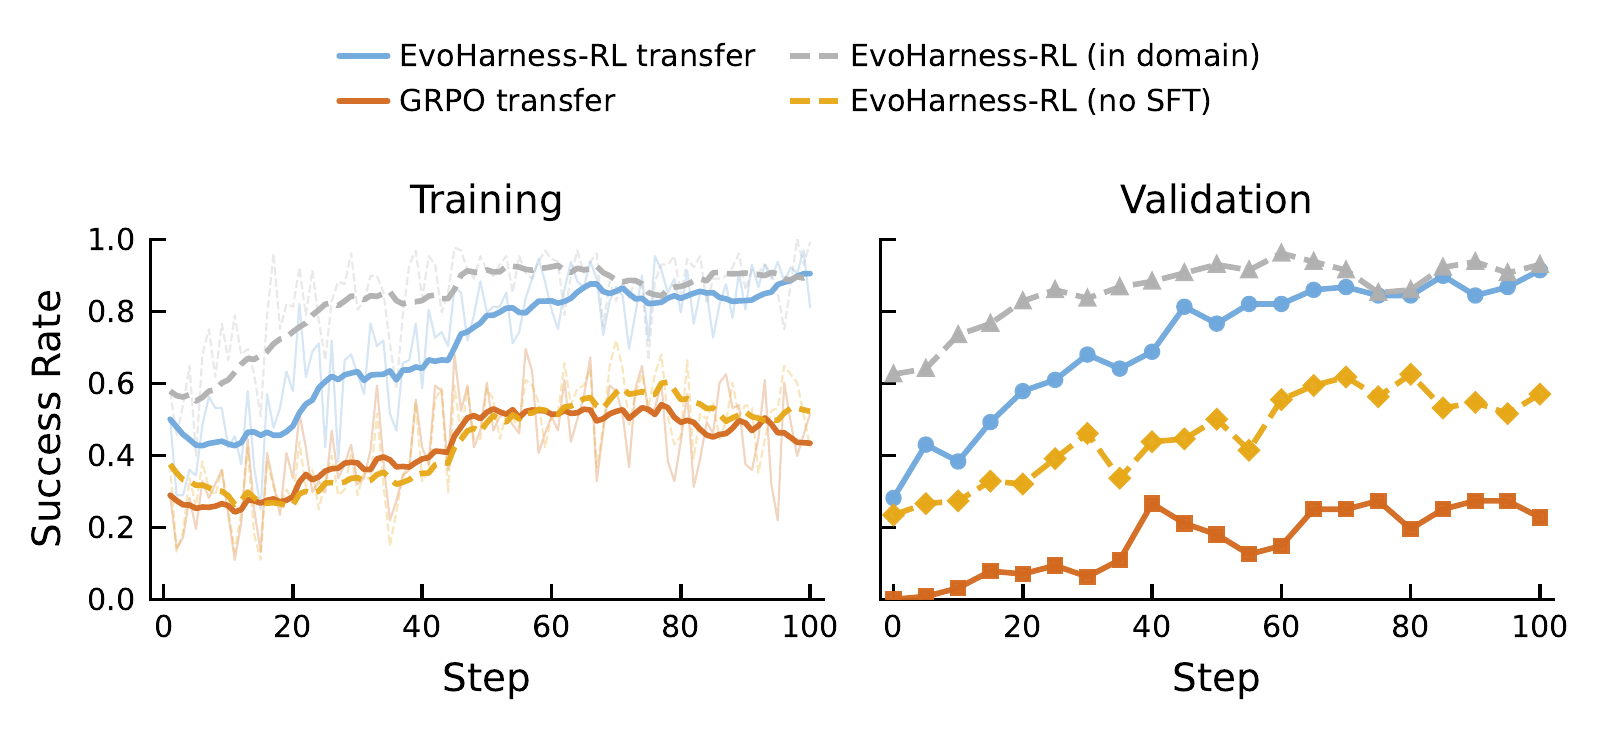
App. C는 WebShop-trained checkpoint에서 시작해 ALFWorld target-side SFT와 100-step 적응 학습을 수행한다. EvoHarness-RL transfer는 in-domain 학습 곡선에 가까워지고, standard GRPO transfer는 강한 negative transfer를 보인다. target-side SFT를 빼면 성능이 내려간다. 이 결과는 새 환경으로 가져간 뒤의 adaptation 근거다.
관련 그림: WebShop→ALFWorld 적응.
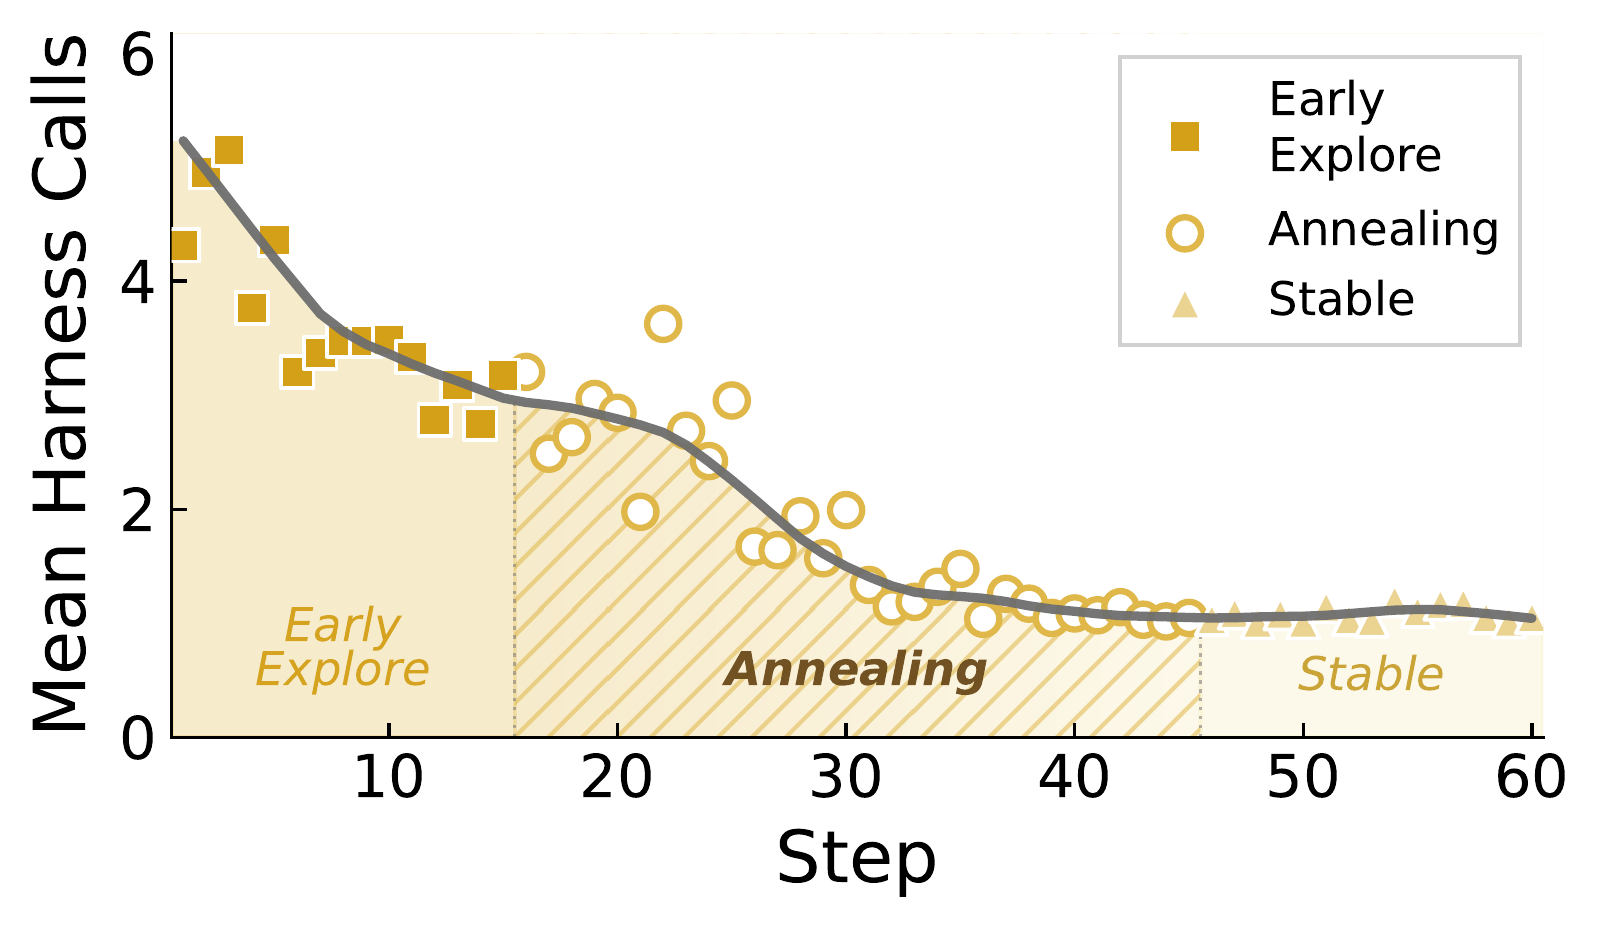
Finding 5 — 호출은 줄어도, 최종적으로 남는 외부 정보가 다르다 (§4.1–4.2, App. B)
학습 초기에는 harness를 자주 쓰고, 이후 호출이 줄어드는 동안 성공률은 오른다. 저자들은 이를 harness annealing / internalization으로 해석한다. 최종 호출 구성은 환경마다 다르다.
- ALFWorld: 반복되는 가사 절차와 물건 위치 prior가 있어
recall이 유용하다. - WebShop: 매 episode의 상품·요구 조건이 달라 current state를 읽는
track이 더 남는다. - WebArena: 여러 사이트와 단계가 섞여 action 구성이 혼합되어 있고 progress 관리의 역할이 커진다.
SFT는 harness 사용량을 늘리며 interface를 익히게 하고, RL은 이를 다시 줄이며 성공률을 높인다. App. B.4 그림의 pretrained Base는 adaptive action interface에 바로 넣은 원래 Qwen3-8B를 뜻하며, 항상 BPE를 보여 주는 EvoHarness-Base와 구분한다.
그림: Figure 3 — 호출 감소 단계, Figure 4 — action별 변화, Figure 5 — 환경별 retention.
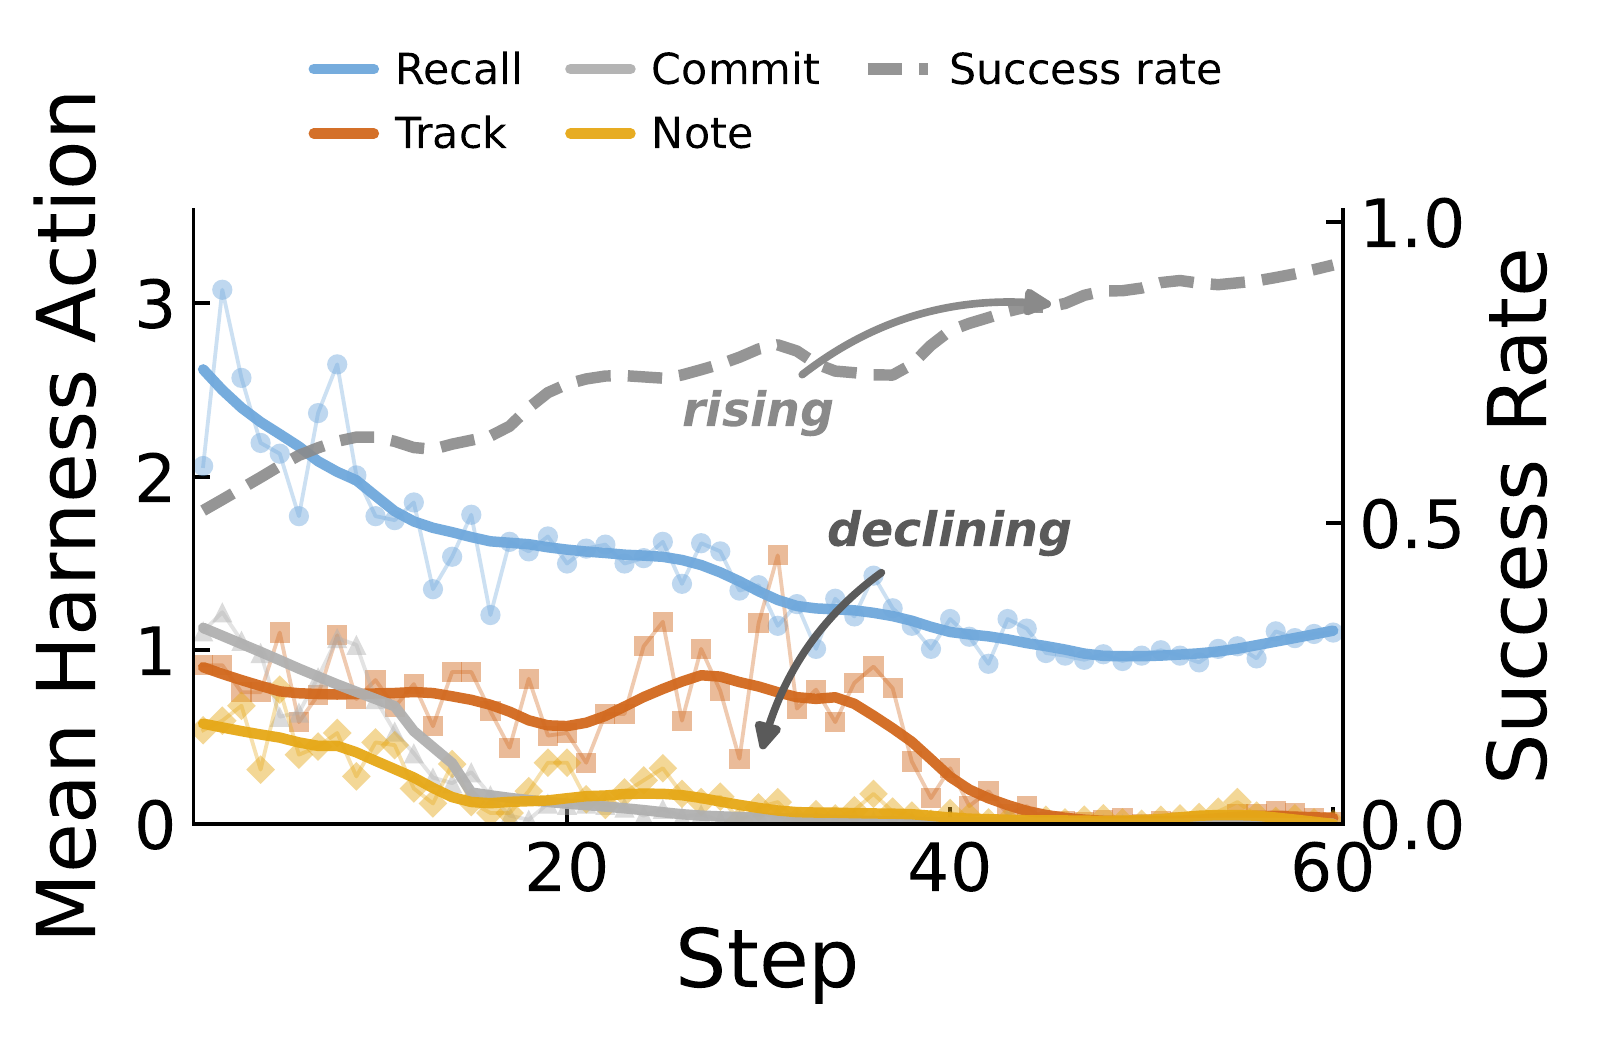
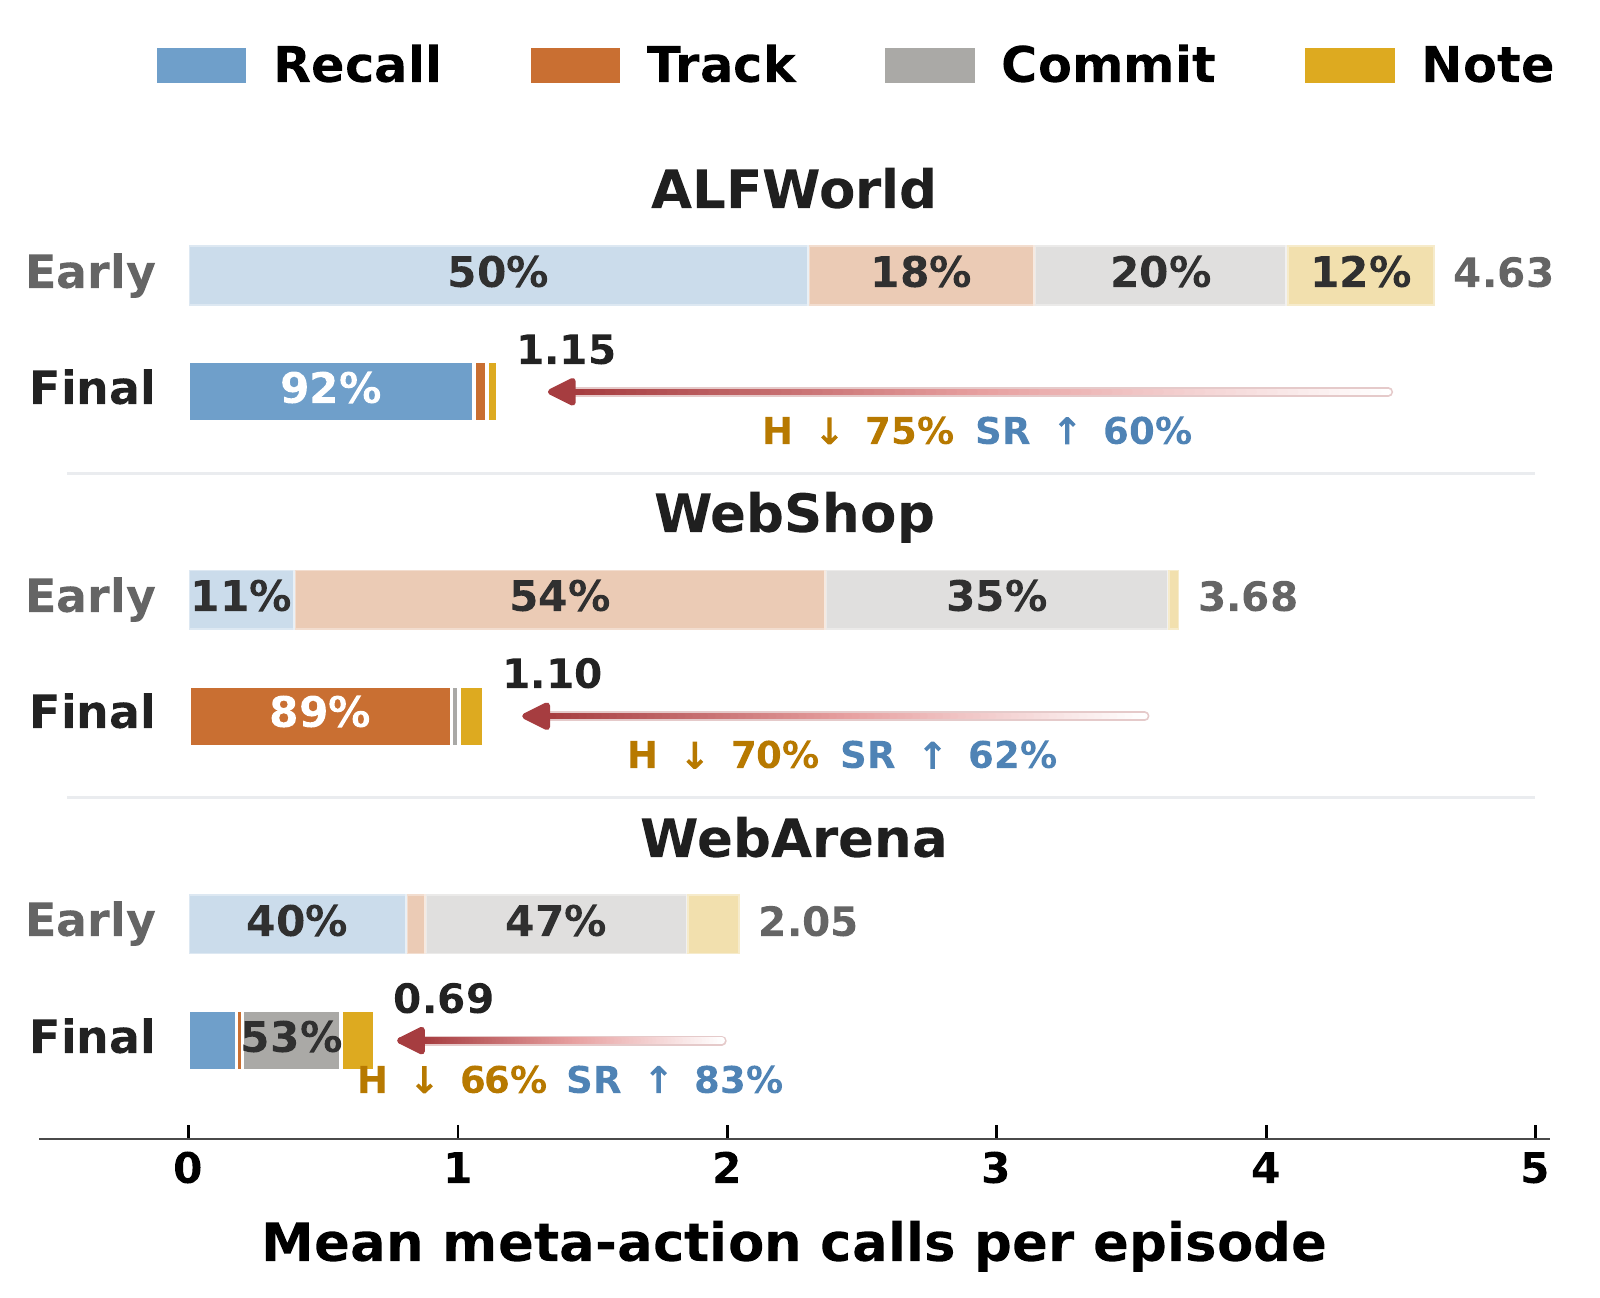
명시적인 harness 사용 지침을 prompt에서 제거하면 SFT는 68.57→59.29, RL은 95.00→92.86으로 내려간다. 저자들은 이를 prompt 지침 의존성이 줄어든 보완 근거로 본다(App. G, Table 9).
Finding 6 — Experience 갱신의 차이는 특히 unseen에서 드러난다 (Table 4)
| Experience mechanism | ALFWorld seen | ALFWorld unseen |
|---|---|---|
| w/o Experience | 84.3 | 84.3 |
| SFT-init bank 고정 | 93.6 | 86.6 |
| Qwen3-8B Self-Consolidate | 94.3 | 88.1 |
| Opus 기반 Evolved bank | 95.0 | 94.8 |
각 mechanism으로 policy를 따로 학습한 결과다. 같은 policy에서 inference bank만 바꾼 실험이 아니다. 초기에 Add가 많다가 이후 Update로 옮겨 간다는 bank 동역학도 보고한다(§4.3).
Self-Consolidate는 frontier consolidator 없이도 작동하지만, 주 결과와의 unseen 차이는 6.7%p다. 모든 variant의 SFT teacher는 Opus이므로 이 실험이 frontier teacher 의존성 전체를 제거한 것은 아니다(App. K).
Finding 7 — RL step 기준 효율과 작은 backbone에서도 이득이 있다 (App. B.2, D–E)
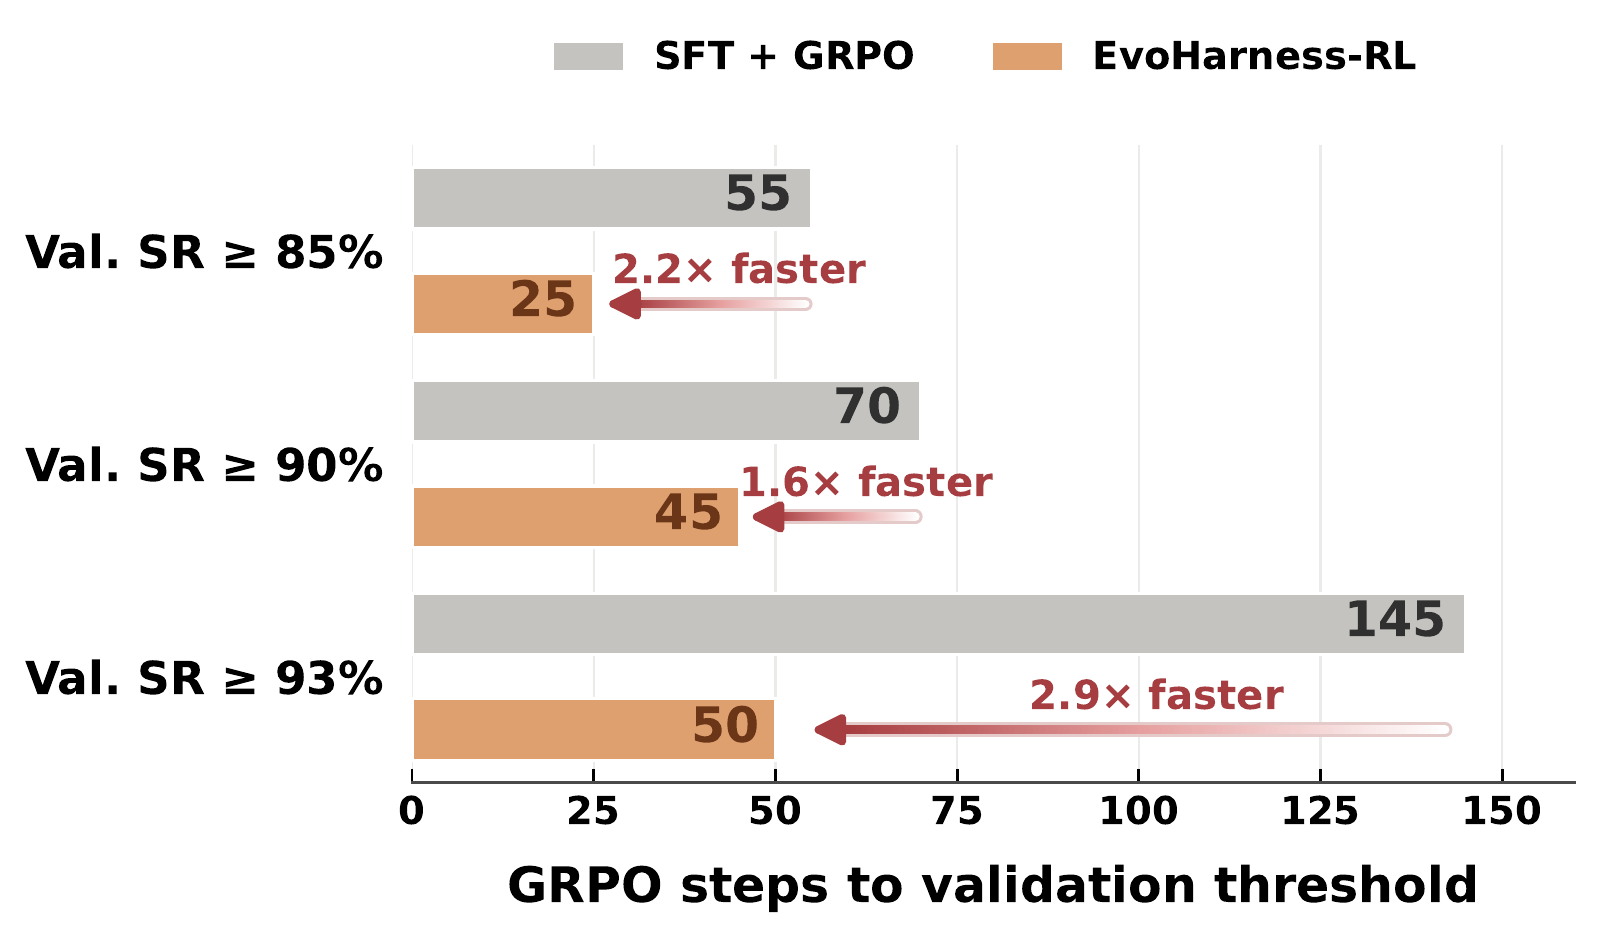
같은 supervised-data 예산의 SFT + GRPO 비교에서 첫 validation은 오히려 baseline이 79.7%, EvoHarness가 57.8%로 앞선다. 이후 EvoHarness가 역전해 validation SR 85 / 90 / 93%에 도달하는 GRPO step 수가 각각 2.2× / 1.6× / 2.9× 빨라진다. validation은 5 step마다 측정한다. 논문 본문에 명시된 값이며 그림을 눈대중으로 읽은 값이 아니다.
효율 그림: validation threshold 도달 step.
4B에서도 EvoHarness-RL은 ALFWorld 87.9, WebShop SR 79.0, WebArena 18.0으로 SkillRL의 85.7 / 74.4 / 16.0보다 높다. 다만 4B의 EvoHarness-SFT는 ALFWorld에서 ReAct보다 낮다(Table 5).
주 표는 single evaluation run이고, App. E에서는 EvoHarness-RL만 3-seed 결과를 추가한다. ALFWorld 95.0±0.0, WebShop SR 80.5±0.7, WebArena 22.7±2.5다(population standard deviation). WebArena의 세 값은 20.0 / 22.0 / 26.0이다. baseline 반복 실험은 없고, 이 절의 기술만으로 training seed와 decoding seed를 완전히 분리한 분산 분석까지 제공되지는 않는다.
한계와 해석
저자들이 밝힌 한계
별도의 일반적 Limitations 절은 없다. 본문·부록에서 밝힌 범위와 조건은 다음과 같다.
- 이론은 조건부다. 성공 발견 분석은 고정 checkpoint·고정 bank의 독립 rollout에 관한 것이며 GRPO training sample complexity가 아니다. 정보가 이미 보이는 context의 결정적 재표현이면 information-value 항으로 이득을 보증할 수 없다(App. F.3).
- Annealing 정리는 최적화 잔차를 없애 주지 않는다. 초기 diversity가 GRPO보다 빨리 학습되게 한다는 rate나 neural parameter의 전역 최적화를 보장하지 않는다. 두 이론 모두 bank를 고정해 note의 미래 bank 개선 효과는 다루지 않는다(App. F.2–F.3).
- WebArena는 평가 task가 50개다. Shopping/CMS 각 15개, Maps 10개, GitLab/Reddit 각 5개라 domain 점수 변동이 크다. CMS·Maps의 이득도 제한적이다(App. E).
- 반복 측정 범위가 제한된다. 시간·compute 제약으로 3-seed 결과는 EvoHarness-RL만 제공하고 baseline은 주 표의 point estimate를 재사용한다(App. E).
- 강한 consolidator의 효과가 남는다. Qwen 자체 consolidation도 유용하지만 Opus 기반 bank가 unseen에서 더 높다. 경험을 추상적인 원칙으로 만드는 능력 차이라는 설명은 저자들의 hypothesis다(App. K).
AI의 해석
아래는 정리자(Codex)의 해석·판단이며 논문의 입증된 주장과 구분한다.
- 가장 직접적인 기여는 runtime coordination의 학습이다. BPE를 갖추는 것, 추가 post-training, 호출량 조절만으로 설명되지 않는 개선을 Always-on·vanilla SFT + GRPO·schedule perturbation으로 살핀 점이 핵심이다. 특히 같은 checkpoint와 bank를 쓰는 Table 7이 action 선택의 가치를 비교적 직접적으로 보여 준다.
- Internalization을 기억 내용의 weights 이전으로 단정하기는 어렵다. 호출 감소와 성공 증가, prompt stripping에 대한 내성은 선택적 사용을 배웠다는 근거다. 효율 보상도 호출 감소를 유도하므로, 어떤 외부 지식이 parameter에 저장되었는지까지 식별한 것은 아니다. 호출 선택의 학습과 지식 자체의 내재화를 나누는 intervention이 필요하다(§4.1, App. G).
- Interface 통일과 adapter 자동화는 다른 주장이다. ALFWorld rule-based tracker, WebShop 상품 state, WebArena accessibility-history store는 환경마다 구현한다(App. I, K). 새 benchmark에서 adapter 설계까지 없어진다고 읽기 어렵다. App. C의 transfer도 target-side 학습을 포함하므로 zero-shot 범용 harness의 증거로 확대할 수 없다.
- Cost-aware의 비용 단위를 제한해서 읽어야 한다. efficiency reward는 interaction 수다.
recall과 환경 action을 같은 한 step으로 세지만 token·latency·GPU 시간·Opus consolidation 비용이 같지는 않다. 2.2× 등의 효율도 GRPO step 기준이다. 전체 비용 절감을 확인하려면 SFT 데이터 생성과 consolidation까지 포함한 계수가 필요하다(§2.3, App. B.2, K). - 두 평가 protocol은 다른 질문에 답한다. RL은 고정 training-acquired bank로 held-out 성능을 보고, frontier Base는 평가 stream의 경험 축적을 포함한다(App. K). “학습 없이 +10.0%p”를 개별 task들이 서로 완전히 독립인 평가로 이해하면 안 된다. online Base는 task 순서·batch 구성 민감도를 추가로 보면 좋다.
- Self-Consolidate는 teacher의 기여를 분리하지 못한다. frontier consolidator 없이도 seen 94.3은 강하지만, SFT teacher는 여전히 Opus이고 unseen 88.1은 full 94.8보다 낮다. teacher·consolidator·policy의 기여를 각각 분리하는 실험이 남는다(Table 4, App. K).
- Note의 장기적 credit assignment는 더 확인할 부분이다. note는 현재 interaction 예산을 쓰지만 미래 bank에 기여한다. 초기 diversity가 note 사용을 돕는다는 분석은 있으나, note만 제거하거나 미래 bank 개선량으로 보상하는 통제 실험은 제시되지 않는다. note의 독립적인 장기 기여를 정량화하기는 어렵다(App. B.3, I).
더 생각해볼 질문
아래는 AI가 정리 과정에서 제안한 후속 질문입니다. 본인이 직접 작성한 의견이나 논문에서 검증한 결과로 표시하지 않습니다.
💭 연구 아이디어 — 아래는 후속 질문이며 이 논문이 검증한 결과가 아니다.
- LiteEvo: prompt·processor를 찾는 evolution과 사용 시점을 배우는 coordination RL을 결합하면, 같은 총 rollout·teacher 예산에서 각각만 쓸 때보다 이득이 있을까?
- MemCo: 여러 agent가 Experience를 공유할 때 누가
note를 남기고 누구의 교정으로 bank를 바꿀지도 학습할 수 있을까? 중복 기록·모순·consolidation 비용이 새 coordination 대상이다. - Environmental Novelty: bank의 위치 prior나 API 절차가 갑자기 틀리면
recall감소·track/note증가로 대응하는가? stale experience 탐지와 교정 지연을 측정하면 어떨까? - Agent Plasticity: weights 고정/bank 갱신, weights 갱신/bank 고정, 둘 다 갱신을 같은 예산으로 비교하면 개선 속도와 포화 수준이 어떻게 달라질까?
- Generalization Tax: 같은 teacher 데이터와 backbone에서 BPE coordination 학습이 unrelated domain 성능 저하도 줄일까? ALFWorld unseen 유지와 cross-domain 능력 보존을 별도로 평가할 수 있다.
- SCDP / resource-rationality: 한 step 대신 latency·token·오류 복구 비용을 넣으면 “기억을 읽을지, 다시 관찰할지, 직접 행동할지”의 경계가 어떻게 달라질까?
참고자료
정리 범위와 근거 메모
원문은 arXiv v2, PDF, LaTeX 본문으로 보관했다. 최초 공개는 2026-08-05, 읽은 버전은 2026-10-05 수정 v2다. 공개 LaTeX의 활성 본문·부록을 1차 근거로 사용하며, 주석이나 \iffalse 안의 미출판 실험은 결과에 포함하지 않는다.
용어 정리
| 용어 | 이 논문에서의 의미 |
|---|---|
| Harness | 모델 실행을 돕는 외부 상태·도구·기억 등의 지원 체계 |
| BPE | Belief·Progress·Experience의 기능적 역할을 묶은 policy-facing abstraction |
| Environment adapter | 공통 BPE 역할을 환경별 상태 표현·도구 동작에 연결하는 구현 |
| Meta-action | 환경 대신 BPE를 읽거나 갱신하는 action. adaptive interface에서는 한 step 소비 |
| Solver / evolver | 현재 bank로 task를 수행하는 policy / batch 증거로 bank를 수정하는 역할 |
| Consolidation | trajectory·결과·note를 재사용 경험으로 추출·검증·수정하는 batch 사이 작업 |
| Harness annealing | 학습이 진행되면서 외부 지원의 호출이 줄고 선택적으로 남는 현상 |
| Internalization | 반복되는 coordination을 policy가 내부에서 처리하게 된다는 저자들의 해석 |
| SR | task success rate. WebShop partial task Score와 구분 |
| %p / relative % | 백분율 차이 / baseline 값으로 나눈 상대 개선율 |
핵심 근거 파일: Method, 실험, 동역학·Experience, 구현·평가 protocol, 환경별 grounding, 이론의 조건, seed 결과.