AutoSaddler: Automatic Harness Optimization with Durable Updates from Agent Execution Traces ↗
Sungho Park, Wonjoong Kim, Rongyuan Tan, Jue Zhang, Wook-Shin Han, Pengfei Gao, Chanyoung Park, Yongqiang Yao, Rao Fu, Elsie Nallipogu, Qingwei Lin, Saravan Rajmohan, Dongmei Zhang
arXiv preprint (2026-08-24); NeurIPS 2026 preprint 양식 사용, 게재 여부는 원문만으로 확정하지 않음 · v1
- 문제: 긴 작업의 harness 결함을 사람이 진단하고 고치는 과정은 비싸며 task별 과적합도 생길 수 있다.
- 방법: trace 진단·patch·검증·reflection을 반복하고 코드 diff와 교훈을 EvoDAG에 축적한다.
- 결과: 세 benchmark의 held-out Pass@1이 개선되며, train batch의 patch 채택과 dev 일반화는 구분해야 한다.
문제와 배경
배경과 읽는 관점
긴 agent 작업에서는 추론이 옳아도 tool 구현이나 실행 제어의 작은 결함 때문에 마지막 결과가 실패할 수 있다. 이때 실패한 한 task만 고치는 patch가 다른 task에서도 유효한지는 알 수 없다. AutoSaddler는 harness를 수정하는 과정과 그 수정이 개발·평가에서 검증되는 과정을 함께 조직한다.
기존 접근과 연구 질문
저자들이 출발하는 현상은 jagged intelligence다. LLM은 어떤 어려운 작업은 잘하지만 비슷하거나 쉬워 보이는 작업에서 실패한다. 여러 결정을 연속해서 맞혀야 하는 long-horizon agent에서는 이런 불균일성이 신뢰성 문제로 이어진다(§1).
Harness는 agent의 외부 실행 장치다. 이 논문은 system prompt·지시문, tools와 interface, middleware와 agent loop를 최적화한다. 작은 로그 오류를 보고 문장 하나를 추가하는 것부터 새로운 tool 구현까지 포함하므로, 탐색 공간과 평가 비용이 크다(§3).
목표는 실패한 한 episode를 재개해 끝내는 hot fix가 아니다. 개발 단계에서 harness를 개선하고, 이후의 unseen task group에도 효과가 남도록 하는 것이다. 각 task는 독립적으로 실행되며, task 사이의 memory·skill curation은 최적화 대상에서 제외한다. 다만 optimizer 자체는 EvoDAG에 탐색 이력을 보관한다(§2–4).
중심 질문은 당장 실행 중인 episode를 복구하는 방법이 아니라, 다음에 만날 task에서도 실패가 덜 생기게 하는 harness를 만드는 방법이다. 특히 작은 train batch의 성공, dev 성능, 최종 held-out 결과를 구분해야 각 단계의 검증이 뜻하는 바를 이해할 수 있다.
핵심 아이디어
먼저 직관으로 이해하기
현재 harness를 실행해 trace를 얻고, 그 맥락을 유지한 채 진단과 patch를 수행한다. 같은 batch에서 효과를 확인한 후 dev로 넘기며, 성공한 변경뿐 아니라 회귀와 불확실한 결과의 교훈도 EvoDAG에 남긴다. 다음 탐색은 최신 코드에서만 이어지는 대신 과거 버전과 유용한 diff를 다시 조합할 수 있다.
전체 흐름은 Figure 2 — AutoSaddler overview에 있다.
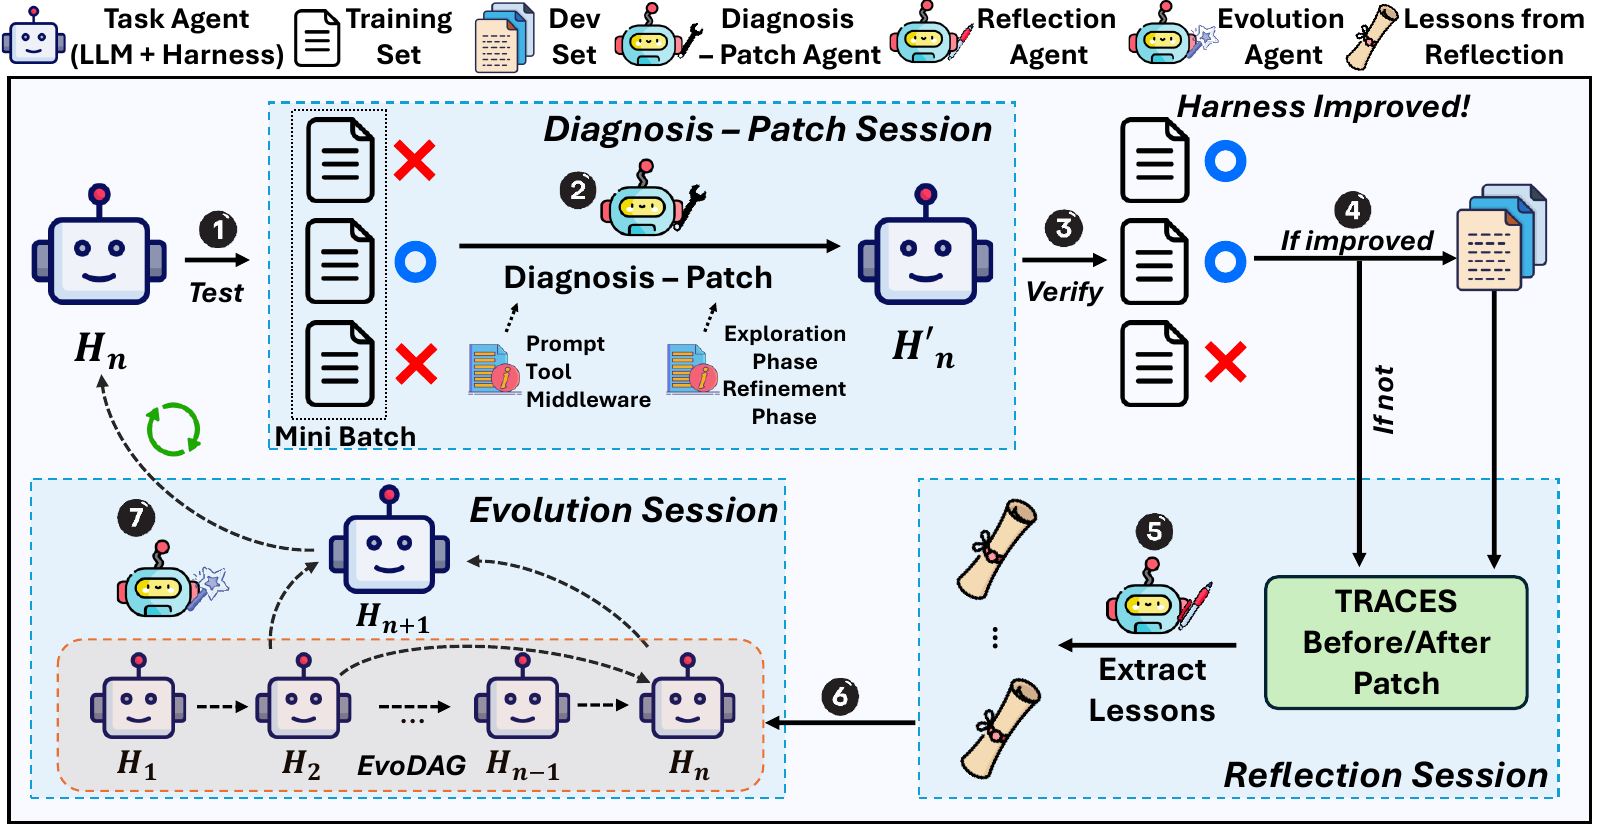
실행 → 진단·수정 → 검증 → reflection → 다음 후보 (§4)
- 현재 harness
H_n으로 train mini-batchB_n을 실행한다. - Diagnosis-Patch Session이 성공·실패 trace와 harness codebase를 조사해
H'_n을 만든다. 진단과 구현을 같은 session에 두어 조사한 맥락을 유지한다. H'_n을 같은 mini-batch에 재실행한다. 점수가 엄격히 높아진 후보만 dev 평가로 보낸다.- Reflection Session은 수락 여부와 관계없이 결과를 분석한다.
fixed,regressed,still-failing,still-passing으로 나누어 원인과 다음 지침을 기록한다. - Evolution Session이 이력에서 부모를 고르거나, 좋은 diff를 가져오거나, 해로운 변경을 되돌려 다음 후보를 준비한다.
- 예산이 끝나면 dev score가 가장 높았던 harness를 반환한다. test feedback으로 추가 수정하지 않는다.
여기서 mini-batch accept는 그 batch의 점수가 올랐다는 뜻이다. dev에서도 기존 best를 반드시 이겼다는 뜻은 아니다. 낮은 dev 점수를 받은 후보도 탐색 이력에 남고, evolution이 이를 참고해 다음 출발점을 고른다. 따라서 매 iteration의 점수가 단조롭게 오르는 방식은 아니다(§4, App. J, P).
무엇을 수정할 수 있나? (Table 1)
| Harness 부분 | Capability: 실행 코드·기능 변경 | Steering: 텍스트로 행동 유도 |
|---|---|---|
| Prompt | — | 규칙 추가·수정 |
| Tool | 새 tool, parameter 변경, 구현 수정 | tool description 수정 |
| Middleware | infrastructure·설정, agent-loop 변경 | tool 호출 직전 reminder |
평가 코드와 benchmark data 관련 코드는 patch 대상에서 제외한다. 이것이 학습 시 평가 결과를 보지 못한다는 뜻은 아니다. 진단은 train의 score·judge rationale과 trace를 사용하며, 사례 분석에는 oracle의 기대 동작도 등장한다(§4, App. K, P).
Phased Patch Scheduling은 먼저 Capability를, 이후 Steering을 탐색한다. GAIA2에서는 iteration 1–25가 Capability, 26–50이 Steering이다. 기본 전환 시점은 Capability phase로 train을 한 epoch 본 뒤다. 저자들은 이를 learning-rate schedule에 비유하지만, 텍스트 변경도 큰 행동 변화를 낼 수 있으므로 효과 크기를 보장하는 구분은 아니라고 명시한다(App. A, L).
EvoDAG는 버전 이력과 교훈을 함께 보관한다 (§4, App. B, J)
각 node는 탐색한 harness와 점수·교훈을, edge는 부모에서 자식으로의 code diff를 나타낸다. evo-dag CLI로 전체 요약, node, edge, scenario 이력, lessons를 필요할 때 조회한다. DAG 전체를 항상 한 prompt에 넣는 방식은 아니다.
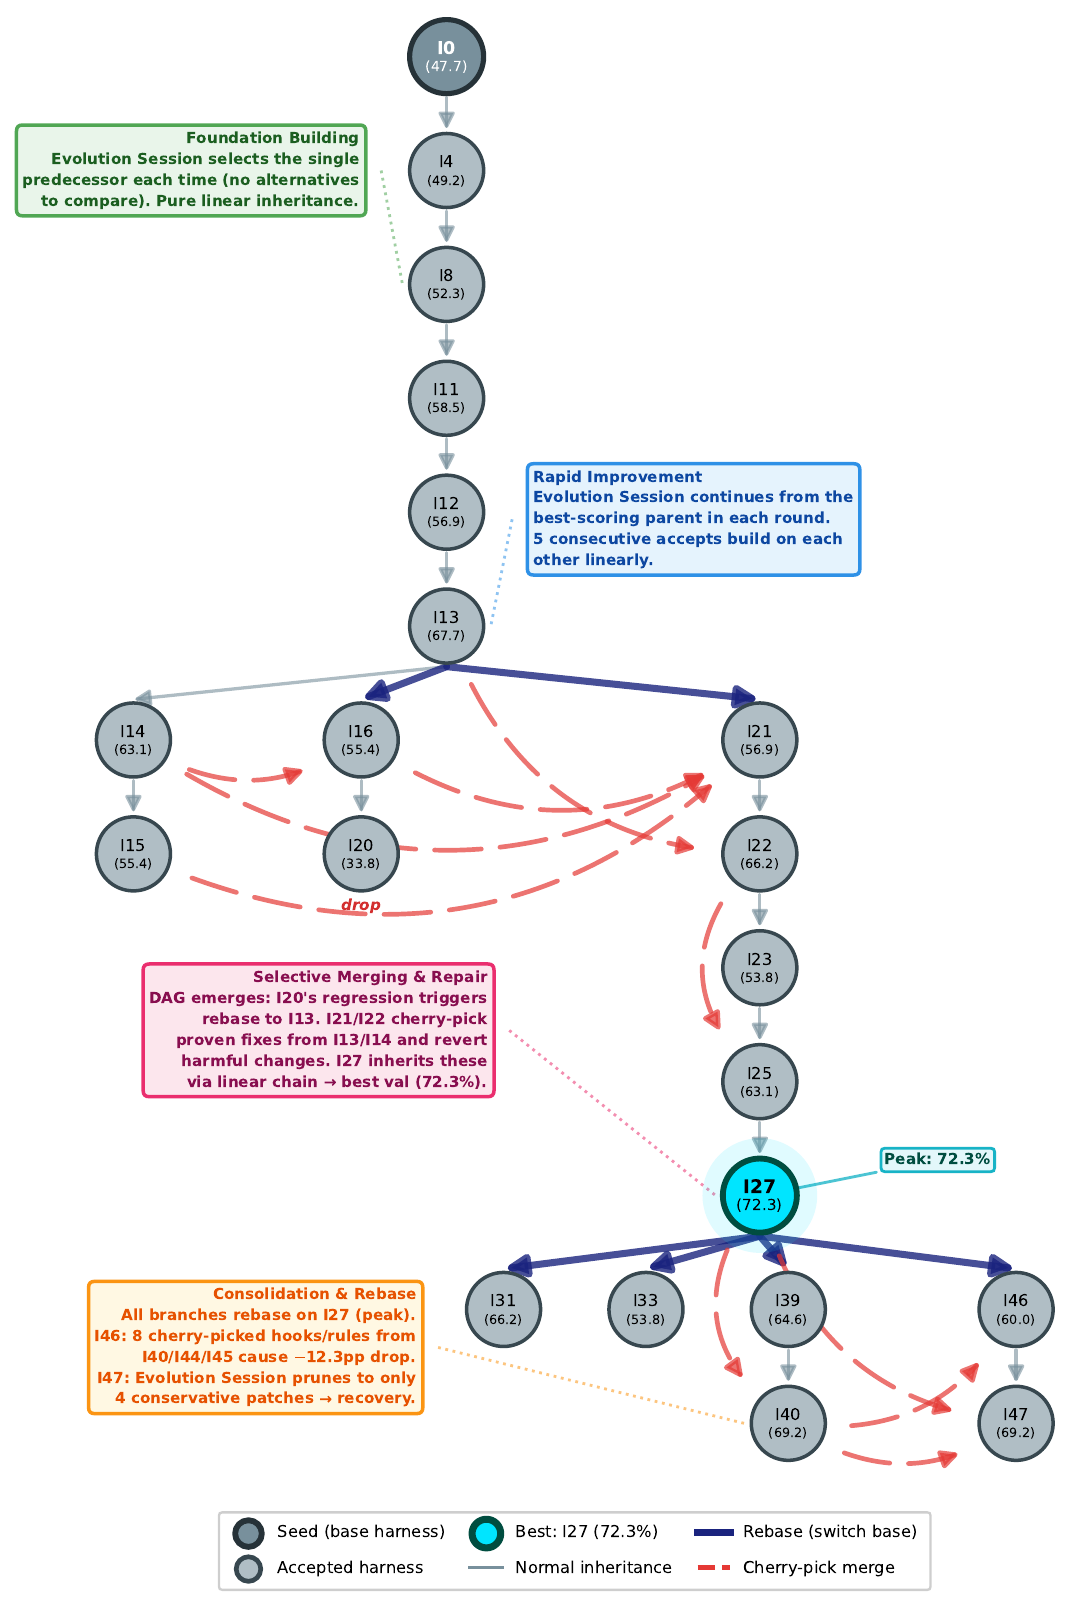
Evolution agent는 최신 후보를 계속 수정할 의무가 없다. 더 좋은 과거 후보로 rebase하거나, 다른 branch의 좋은 diff만 cherry-pick할 수 있다. GAIA2에서는 iteration 20의 dev 33.8% 회귀 뒤 iteration 13으로 돌아가 좋은 변경을 가져오고, iteration 27에서 72.3%에 도달한다. iteration 46에는 여덟 개 hook·rule을 모은 뒤 성능이 하락했고, 다음 iteration에서 네 개의 보수적인 patch로 줄여 69.2%를 회복한다(App. J).
탐색 그림: EvoDAG trajectory.
Reflection은 우연한 성공과 실제 수정 효과를 구별하려 한다 (App. P)
변경 전후 결과가 달라도 patch 때문이라고 바로 기록하지 않는다. trace의 행동이 갈린 지점, 해당 code path·prompt·hook이 diff에 포함되는지, 결과를 설명하는 연결이 있는지 확인하도록 요구한다. true fix/regression, stochastic, uncertain을 구별한다.
Reflection 지시문은 dev raw trace를 읽지 않고 aggregate accuracy만 사용하도록 제한한다. 이 점은 train trace를 깊이 조사하는 진단과 다르다. 다만 논문에 지시문이 있다는 사실 자체가 인과 판정의 정확도를 입증하는 것은 아니며, 이 해석은 아래 AI 해석에서 다룬다.
정의와 수식
최적화 변수는 모델 weight가 아니라 외부 harness다(§3). \(\theta=(\theta_{\mathrm{prompt}},\theta_{\mathrm{tool}},\theta_{\mathrm{middleware}}).\) 목표는 task 분포와 실행의 확률성을 평균한 성능을 높이는 것이다. \(J(\theta)=\mathbb{E}_{(x,y^*)\sim\mathcal T} \mathbb{E}_{(\tau,\hat y)\sim P_\theta(\cdot\mid x)} [\mu(\hat y,y^*)].\) 실제로는 rollout budget 안에서 탐색한 후보 중 dev score가 가장 높은 것을 고른다. \(\hat\theta_{\mathrm{AS}} =\arg\max_{\theta\in\mathcal V_{K,\mathrm{dev}}} \widehat J_{D_{\mathrm{dev}}}(\theta).\) 저자들은 rollout → score·trace → diagnosis·patch·verification → dev → reflection·EvoDAG·evolution을 mini-batch learning에 대응시킨다. 미분이나 numerical gradient를 계산하는 알고리즘은 아니다. “Textual gradient”는 실패 원인 가설을 만들고 patch라는 개입으로 검증하는 절차의 비유다(App. A).
실험과 핵심 결과
실험 설정
기본 task agent와 optimizer는 Claude Opus 4.6이며, 세 optimizer session은 Claude Agent SDK로 구현한다. 주요 평가는 optimizer run 한 번에서 고른 harness를 test에서 세 번 실행한 Pass@1 평균·표준편차다. 세 번의 독립 evolution 평균과 구별한다(§5.1).
| Benchmark / base harness | Train | Dev | Test | 분리 기준 |
|---|---|---|---|---|
| GAIA2 / default ReAct agent | Universe 29, 75 tasks | Universe 30, 65 | Universes 21/22/27, 107/112/81 | persona·simulated environment |
| SWE-Bench Pro / SWE-agent | qutebrowser, 79 | Vuls/NodeBB, 각 40 | Ansible/Flipt/Element-web, 96/85/56 | repository |
| Terminal-Bench 2.0 / Terminus 2 | 30 | 19 | 40 | 89개 task의 random partition |
GAIA2와 SWE-Bench Pro는 group 수준 held-out, TB2는 task 수준 random held-out이다. 모두 새로운 benchmark 자체로의 직접 전이를 시험한 것은 아니다(App. B).
비교 방법은 prompt를 최적화하는 GEPA, harness를 code로 바꾸는 Meta-Harness다. GAIA2의 분산된 prompt는 GEPA용으로 합쳤다가 다시 분리하고, Meta-Harness는 단일 파일 편집에서 repository 편집으로 확장한다. Meta-Harness에는 train+dev 합집합을 제공한다. AutoSaddler·GEPA는 GAIA2/SBP 2 epochs, TB2 4 epochs이며, full-batch 방식인 Meta-Harness는 총 task execution이 그보다 적지 않도록 별도 반복 수를 사용한다(App. B).
성공 판정은 GAIA2의 Llama-3.3-70B-Instruct judge, SBP의 fail-to-pass·pass-to-pass unit tests, TB2의 container 상태 test script를 따른다. TB2 점수는 전체 89개가 아닌 test subset 40개의 점수다(App. B).
Finding 1 — 세 종류의 held-out 작업에서 base harness를 개선한다 (Tables 2–3)
수치는 논문이 보고한 평균 Pass@1 (%)다. 증가폭 열만 표의 점수로 계산했다.
| Benchmark | Base | GEPA | Meta-Harness | AutoSaddler | Base 대비 | 최고 자동 baseline 대비 |
|---|---|---|---|---|---|---|
| GAIA2 | 53.0 | 54.6 | 53.2 | 62.0 | +9.0%p | +7.4%p |
| SWE-Bench Pro | 37.3 | 42.5 | 35.3 | 46.9 | +9.6%p | +4.4%p |
| Terminal-Bench 2.0 | 40.0 | 42.5 | 43.3 | 50.0 | +10.0%p | +6.7%p |
세 benchmark 모두 평균은 가장 높지만 모든 subgroup에서 가장 높은 것은 아니다. SBP의 Element-web에서는 GEPA 45.2%, AutoSaddler 43.5%다. TB2의 수작업 Terminus KIRA 47.5%보다 AutoSaddler는 2.5%p 높다.
Finding 2 — 가장 큰 ablation 손실은 generalization-aware selection 제거다 (Table 2, App. F)
| GAIA2 전체 test 평균 | Pass@1 (%) |
|---|---|
| Full AutoSaddler | 62.0 |
| In-depth diagnosis 제거 | 57.8 |
| Structured intervention 제거 | 56.9 |
| Generalization-aware selection 제거 | 50.6 |
| Default agent | 53.0 |
얕은 진단 조건은 단일 LLM 호출로 trace·평가 결과를 보고 실패 이유를 추정한 다음 patch agent에 전달한다. 구조화 제거는 patch taxonomy와 phase schedule을 함께 없앤다. generalization-aware selection 제거는 dev 평가와 Reflection/EvoDAG를 함께 없앤다.
더 세밀한 ablation은 Universe 22만 평가한다(App. F). Full 60.7%에서 schedule만 제거하면 54.8%, 구조화 전체를 제거하면 53.3%다. Full 60.7%에서 dev filtering만 제거하면 50.0%, reflection까지 제거하면 44.9%다. 이 수치를 위의 전체 평균 62.0%와 섞지 않는다.
§5.3의 dev 분석에서는 두 조건의 fix rate가 비슷한 반면 regression 추세가 갈린다. 저자들은 Full의 regression trend −0.24%p/iteration, ablation +0.16%p/iteration을 보고한다. 빈번한 message tool을 광범위한 hook으로 다른 tool에 강제 연결한 patch가 무관한 task까지 망가뜨리는 사례를 제시한다.
Finding 3 — 탐색을 구조화하면 텍스트 수정에 쏠리는 경향이 줄어든다 (§5.3, App. G)
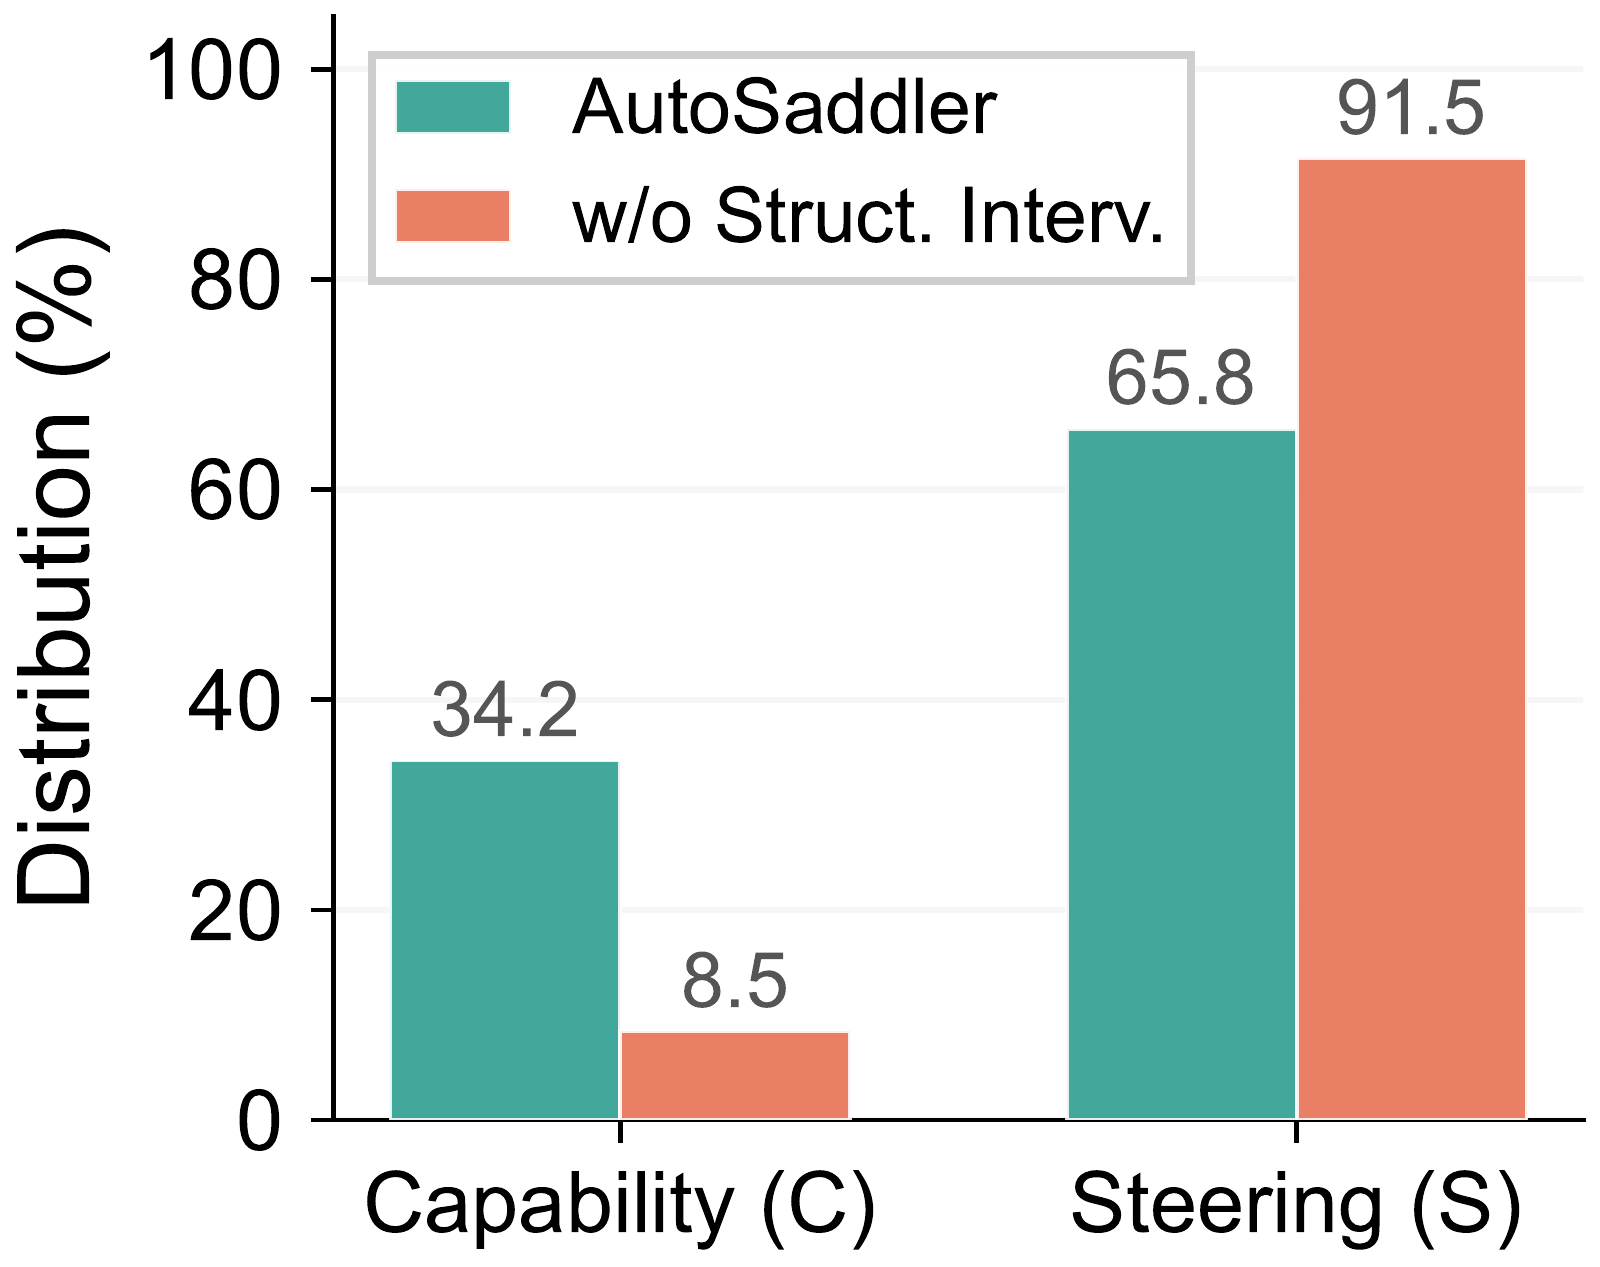
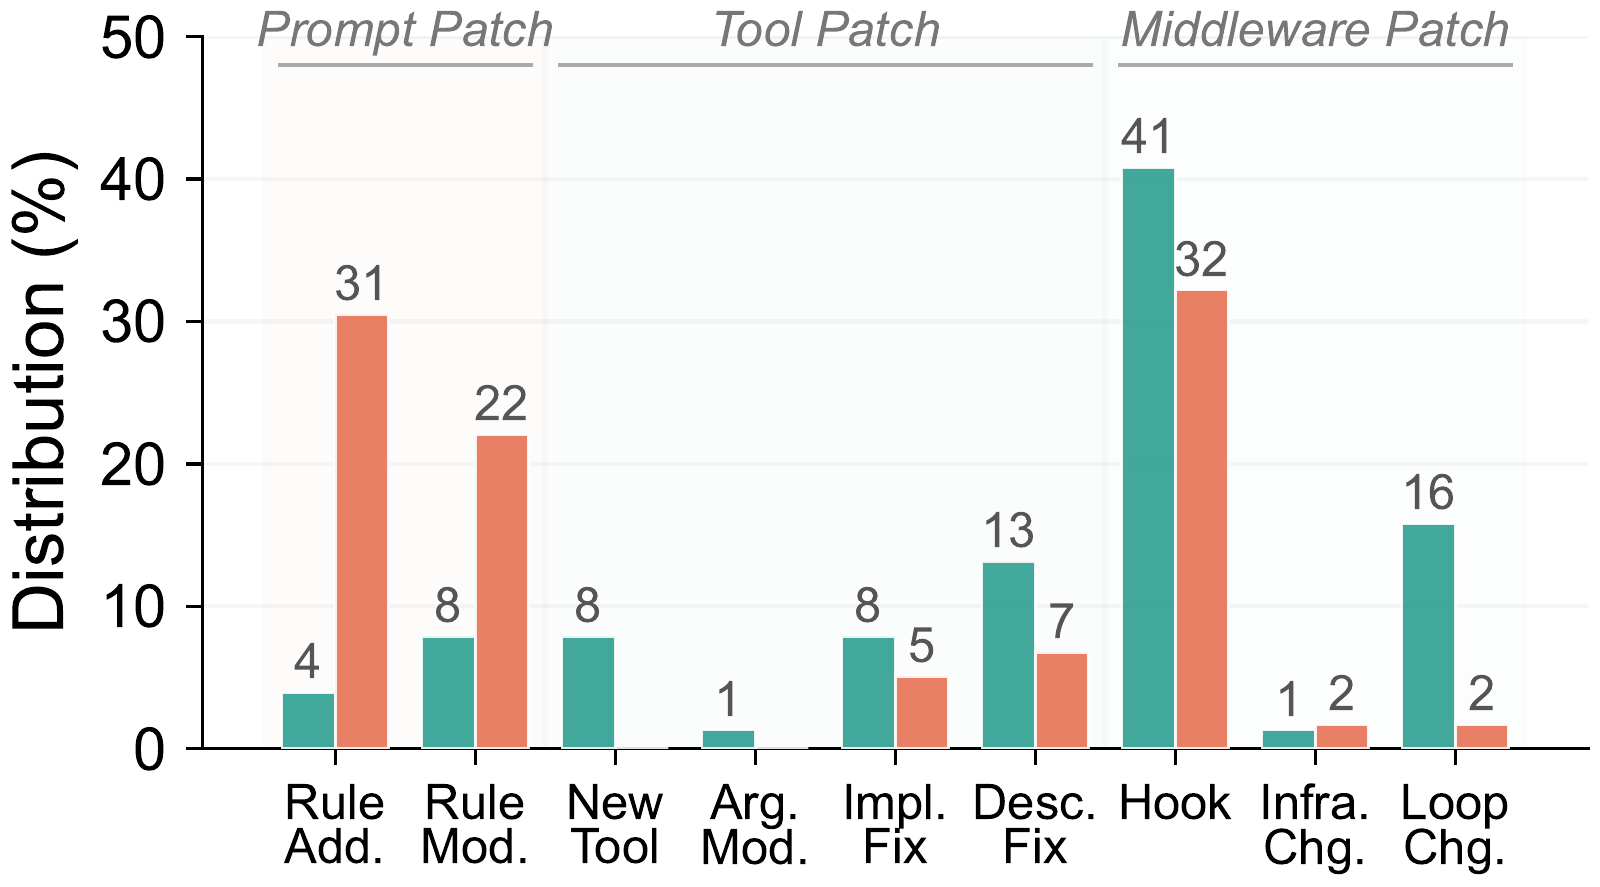
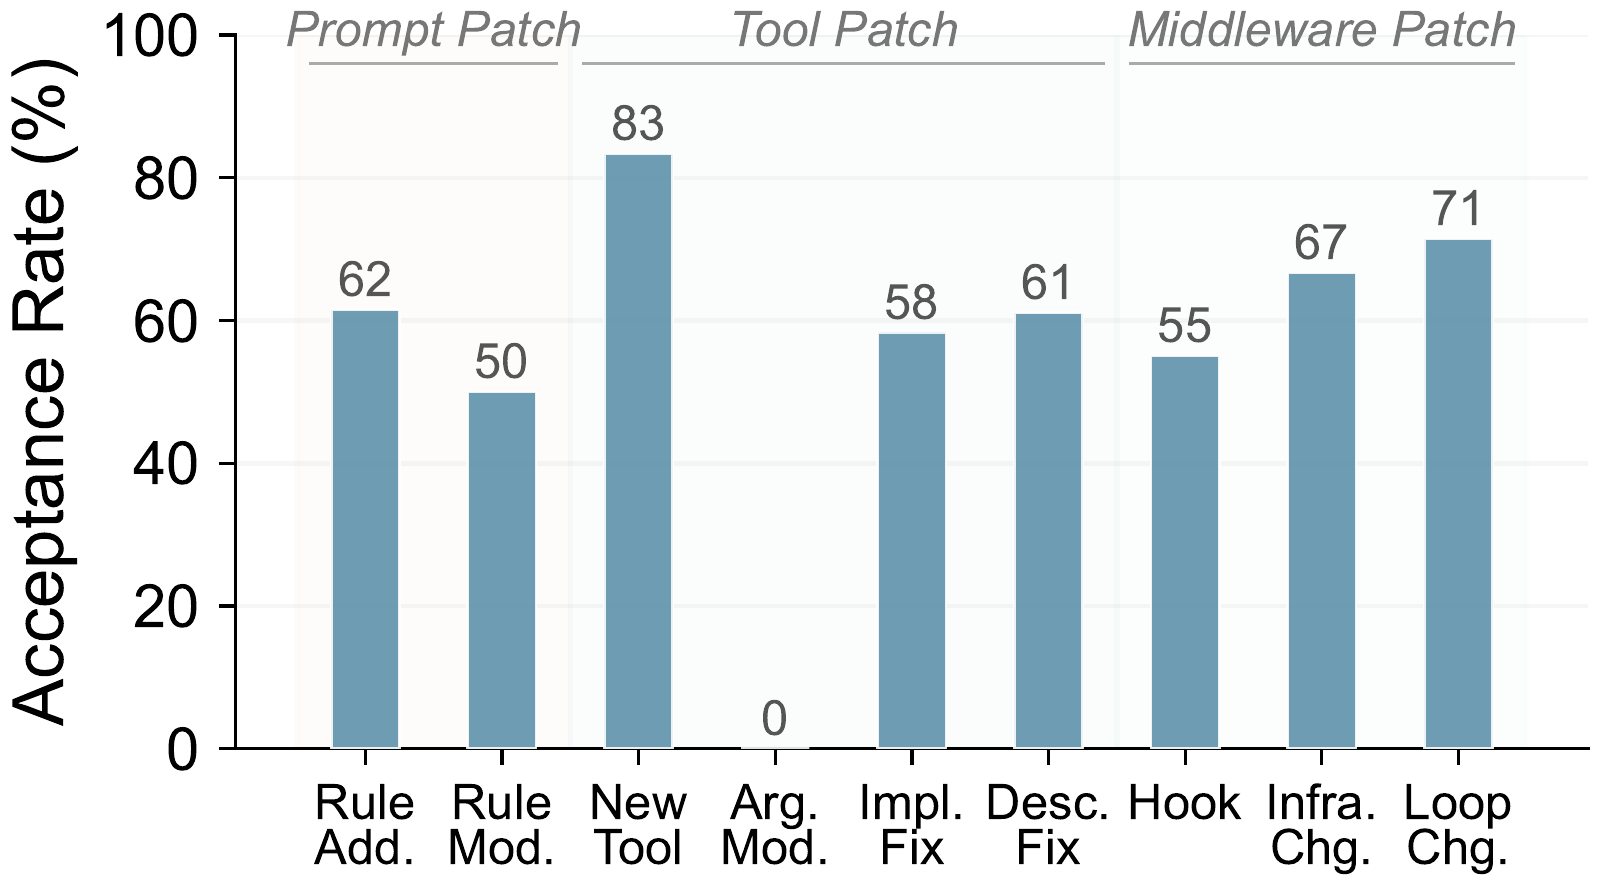
구조화가 없으면 patch의 91.5%가 Steering에 몰린다. 새 tool·loop·infrastructure 변경은 수락률이 각각 83%, 71%, 67%로 높지만, 비구조화 조건에서는 생성 patch의 4%뿐이다. AutoSaddler는 이 세 유형의 비중을 25% 이상으로 높인다. 수락은 같은 mini-batch의 점수 개선 기준이다.
Patch durability 분석도 범위를 구분해야 한다. 같은 train mini-batch의 변경 전후를 비교한 결과다(App. G).
| Patch mechanism | 이전 실패를 고친 비율 | 이전 성공을 망가뜨린 비율 |
|---|---|---|
| Steering | 58% | 17% |
| Capability | 55% | 8% |
저자들은 Capability가 비슷한 local repair와 더 낮은 회귀를 보인다고 해석한다. Prompt/Tool/Middleware로만 묶으면 fix rate는 57–59%, regression은 각각 14/19/14%로 구분이 덜 뚜렷하다.
그림: Capability/Steering 비율, patch subtype, 수락률.
Finding 4 — 효율성의 핵심은 비싼 평가를 선택적으로 실행하는 데 있다 (Figure 1, App. I)
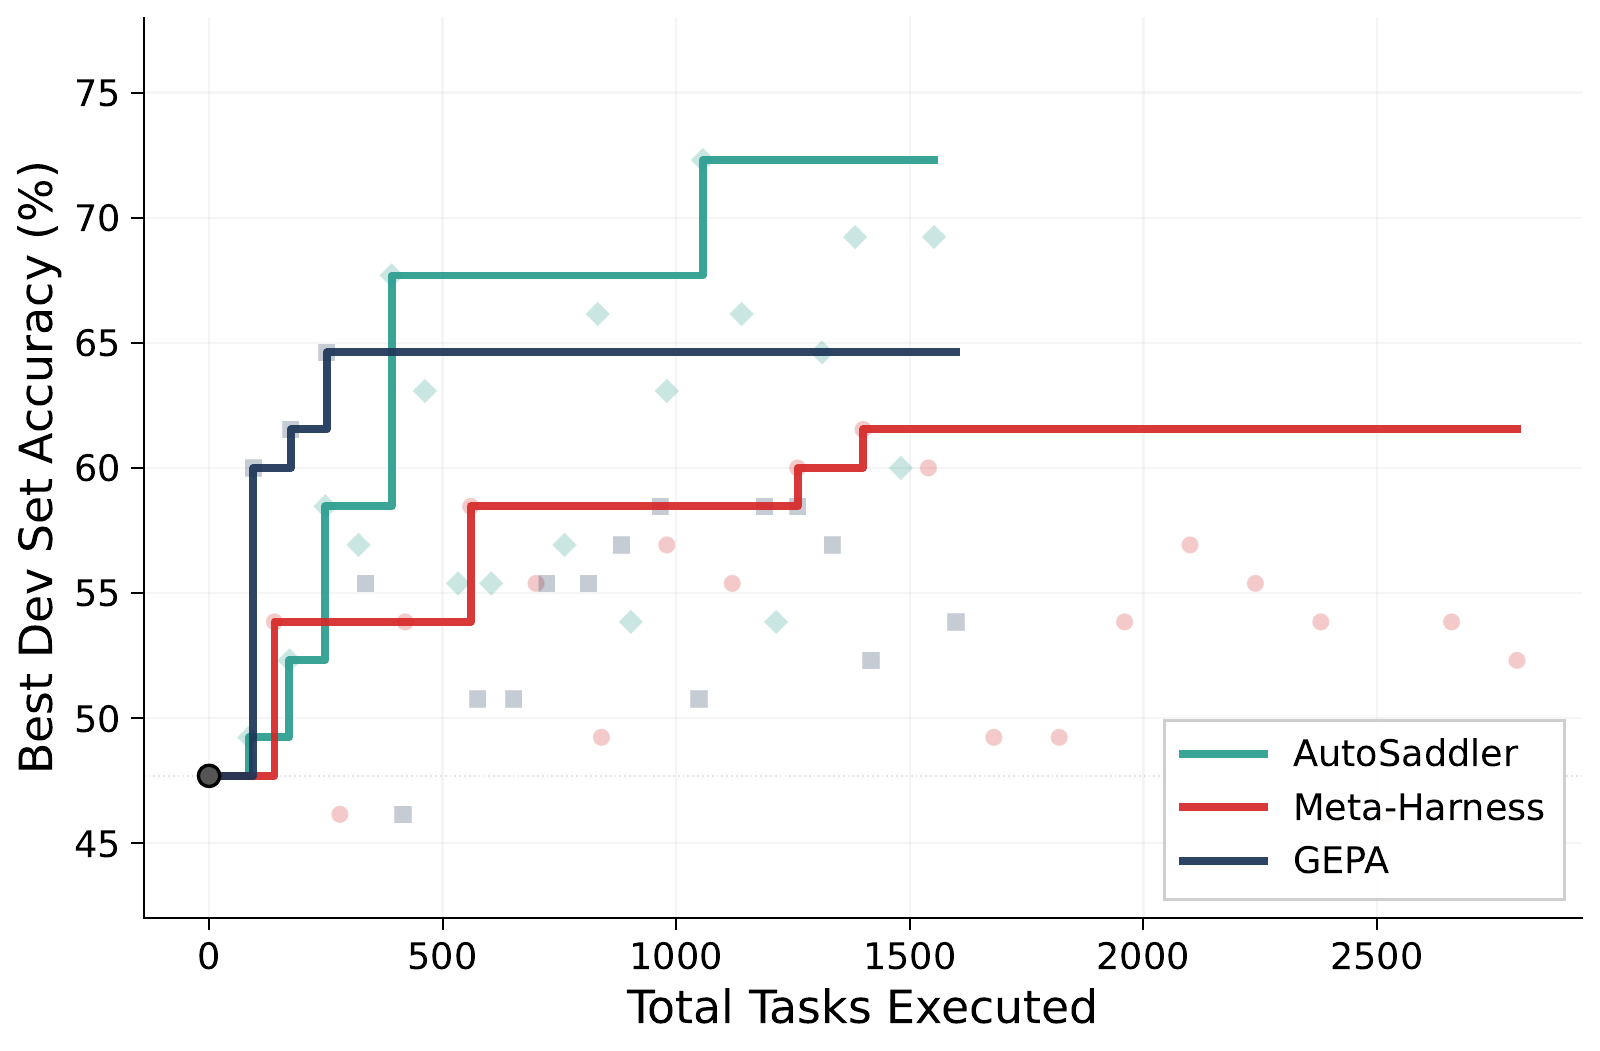
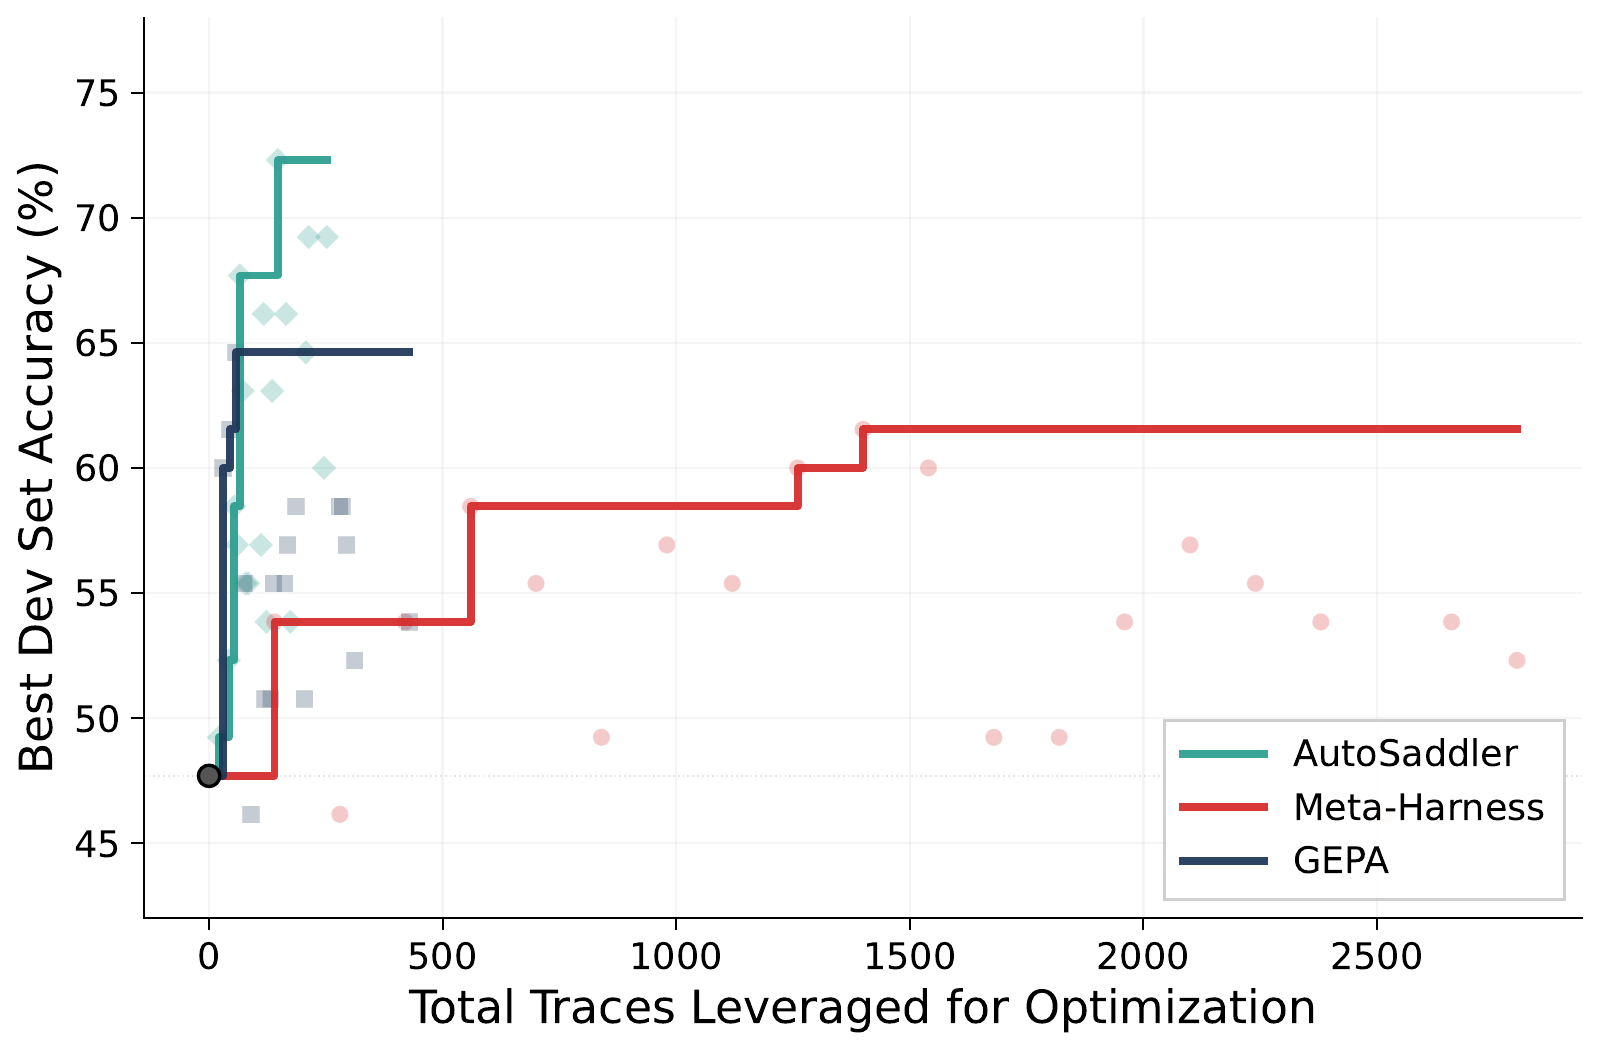
GAIA2에서 AutoSaddler는 약 1,000 total task executions로 dev 72.3%에 도달한다. GEPA·Meta-Harness는 약 2,800회를 쓰고 각각 64.6%, 61.5%에서 정체한다. 별도로 학습에 활용한 trace 수로 세면 AutoSaddler 147, Meta-Harness 1,400이다. 147이 전체 실행 횟수라는 뜻은 아니다.
그림: total executions 기준, 활용 trace 기준.
Optimizer 자체는 patch 하나당 더 비쌀 수 있다. 아래는 논문 당시 GAIA2 run의 optimizer-side 평균이며 현재 API 가격을 조사한 값이 아니다(App. I).
| Method | $ / generated patch | seconds / patch | LLM calls / patch |
|---|---|---|---|
| GEPA | 5.50 | 386 | 21.3 |
| Meta-Harness | 12.65 | 883 | 66.9 |
| AutoSaddler | 14.56 | 533 | 76.1 |
대신 Meta-Harness는 매 후보 train+dev 140 scenarios를 평가하고, AutoSaddler는 train mini-batch 개선 때만 65-scenario dev를 실행한다. AutoSaddler는 391 rollouts에서 dev 67.7%로 Meta-Harness의 1,400회 peak 61.5%를 넘는다. task rollout 하나의 평균은 203.9초, LLM calls 20.2회다. 이는 서로 다른 비용 단위를 보여 주며, 전체 dollar 비용이 10배 절감됐다는 결과로 읽으면 안 된다.
Finding 5 — optimizer 재실행·train 교체·모델 교체에서도 일부 이득이 유지된다 (App. C–E)
- 독립 evolution 재실행: GAIA2 Universe 22에서 1차 60.7%, 2차 58.6%, base 51.5%. 두 trajectory만으로 optimizer 변동성을 충분히 추정할 수 없다고 저자들도 적는다.
- 다른 train Universe: Universe 29 대신 24에서 최적화하면 같은 test Universe 22에서 57.4%, base 대비 +5.9%p다.
- 모델 교체: Opus 4.6으로 만든 harness를 그대로 Haiku 4.5에 적용하면 GAIA2 전체 test 평균이 base 30.0%→35.6%, +5.6%p다. 같은 모델 family 내부의 한 방향 전이 실험이다.
Finding 6 — 실제 patch에는 기능 추가와 실행 환경 개선이 포함된다 (App. K, N–O)
| 실패 양상 | 발견한 harness 변경 | 근거 |
|---|---|---|
| 여러 우편번호의 범죄율을 순차 조회하다 step budget 소진 | get_crime_rates_batch로 묶음 조회 | App. L, N |
| ride history의 뒤쪽 후보를 놓쳐 모호함을 발견하지 못함 | 날짜·출발지·도착지로 전체 history를 검색하는 tool 추가 | App. K, N |
실제 Documents/benchmarks를 찾지 않고 root에 동명 폴더 생성 | mkdir·mv 전에 기존 parent 경로를 찾는 resolution 추가 | App. K, N |
| 지연 상태를 확인할 시점까지 agent loop가 진행되지 않음 | turn 사이 wait_for_notification(timeout=300)으로 simulated time 전진 | App. N |
| terminal 출력이 잘려 중요 정보 누락 | output limit 10KB→30KB | App. O |
| 설치된 라이브러리를 모른 채 취약한 직접 구현 선택 | loop 시작 전에 pip list --format=columns 실행 | App. O |
TB2에는 완료 전 검증, 다른 입력으로 재시험, 불필요한 build artifact 정리 등의 prompt·completion reminder도 들어간다. 이 표는 발견한 변경의 예이며 각 patch의 독립적인 test 성능 기여를 측정한 ablation은 아니다.
한계와 해석
저자들이 밝힌 한계
Appendix R의 명시적 한계는 다음과 같다.
- Supervision이 필요하다. gold answer와 task-level 성공 metric을 가정한다. 실제 운영에서는 이런 정답·평가를 대량 확보하기 어렵고 비쌀 수 있다.
- Task 사이 지속 상태를 다루지 않는다. stateless·independent task 설정이며, stateful 환경과 memory·skill curation으로의 확장은 남아 있다. 개별 episode 안에서 여러 turn과 환경 상태 변화가 있다는 사실과는 양립한다.
- 더 넓은 모델 family 검증이 필요하다. 다양한 backbone에서의 효과는 후속 과제다.
- 실제 배포 전 검토가 필요하다. 저자들은 초기에 자동 수정된 harness를 사람이 검토하거나 추가 security validation을 거칠 것을 제안한다.
Weak supervision 후보로 trace inconsistency, tool-call error, rollout 간 self-consistency를, 데이터 확보 방법으로 환경에서의 synthetic task bootstrapping을 제안한다. 이들은 본 논문의 검증된 결과가 아닌 future work다.
AI의 해석
아래는 논문의 주장이 아니라 정리자(Codex)의 해석이다.
- 좋은 수정의 발견과 해로운 수정의 제거를 함께 설계한 것이 핵심으로 보인다. 같은 batch를 고치는 것만으로 충분하다면 selection 제거가 base 아래로 떨어질 이유를 설명하기 어렵다. Tables 2와 App. F, J는 regression 탐지·rebase·선택을 포함한 전체 절차의 가치를 뒷받침한다. 다만 Reflection·EvoDAG·merge 각각의 효과가 완전히 분리된 것은 아니다.
- Durable의 직접 측정 범위는 제한적이다. App. G의 8% vs 17% regression은 동일 train batch의 전후 관찰이다. 장기간 배포, API 변경, 환경 drift 후의 수명을 측정한 결과는 아니다. Capability와 Steering은 phase도 다르고 선택된 문제도 달라, 이 비교만으로 code patch가 본질적으로 더 안전하다고 인과 결론을 내리기는 어렵다.
- Trace와 diff를 맞춰 보는 것은 인과 가설을 개선하지만 실험적 인과 추정은 아니다. Reflection 지시문은 우연을 점검하도록 잘 구성되어 있다(App. P). 그러나 seed를 통제한 반복 전후 비교나 전문가 라벨로 causal attribution 정확도를 검증한 결과는 찾지 못했다. 특히 prompt의 영향은 직접 tool path가 바뀌지 않아도 넓게 퍼질 수 있다.
- 일반화 범위를 benchmark마다 따로 읽어야 한다. GAIA2는 persona, SBP는 repository가 달라지는 테스트라 단순 task 분리보다 강하다. TB2는 random split이다. Opus→Haiku도 모델 family를 가로지르는 전이는 아니다. 새로운 benchmark·새 tool 체계에 기존 harness를 그대로 적용하는 범용 전이는 입증하지 않았다(App. B–E).
- 비용 비교는 rollout·분석 trace·optimizer API를 나누어 봐야 한다. 147 vs 1,400은 활용 trace 수이며 모든 evaluation을 포함하지 않는다. App. I가 optimizer overhead를 따로 공개한 것은 유용하지만, 해당 표만으로 전체 비용의 배수나 wall-clock speedup을 확정할 수는 없다. 예산도 정확히 같은 수로 고정하기보다 baseline이 더 적지 않도록 맞춘 비교다.
- 원문에 정리되지 않은 계수 차이가 있다. §5.2의 증가폭 오류는 표를 기준으로 교정할 수 있다. 추가로 GAIA2는 App. J에서 50 iterations·51 candidates를, App. I 비용 표에서는 39 generated patches를 센다. App. I는 iteration당 train scenarios를 여섯 개로 표현하지만 App. A·J의 epoch/iteration 서술과 연결되는 batch 계수는 명확하지 않다. 평가 전후 실행을 어떻게 세는지, 무변경 iteration을 제외했는지 등은 공개 구현 확인이 필요하며 여기서는 단정하지 않는다.
- 재현에는 prompt 밖의 skill 절차도 필요하다. App. P는
history-analysis,diagnose,capability-patch,steering-patch,patch-verification의 SKILL.md를 필수로 읽게 한다. 내려받은 e-print에는 해당 skill 파일과 실행 코드가 포함되지 않았다. 따라서 공개된 세 prompt만으로 실제 optimizer의 모든 동작을 재현할 수 있다고 보기는 어렵다. 외부 project repository의 현재 공개 상태는 이번 정리에서 확인하지 않았다. - 학습 시 oracle 신호와 수정 가능한 환경의 경계를 명시하면 비교가 더 선명해진다. 평가·benchmark data를 수정하지 않는다는 제한과, train oracle·judge rationale을 진단에 쓰는 것은 다른 문제다. 또한 GAIA2에서는 tool 구현과 simulation loop도 바꾼다(App. K, N). 다른 시스템과 비교할 때는 어느 runtime 파일까지 바꿀 수 있는지와 진단에 주는 supervision을 함께 맞춰야 한다.
더 생각해볼 질문
아래는 AI가 정리 과정에서 제안한 후속 질문입니다. 본인이 직접 작성한 의견이나 논문에서 검증한 결과로 표시하지 않습니다.
💭 연구 아이디어 — 기존 아카이브 주제와 연결한 후속 질문이다. 본 논문이 검증한 결과는 아니다.
- LiteEvo: 동일 train trace·backbone·총 실행 예산으로 component library 재조립과 EvoDAG의 diff 재조합을 비교하면, 재사용 단위가 generalization과 비용에 어떤 차이를 만들까? 이전 LiteEvo 노트의 비교 후보이며 이 논문과의 직접 실험은 아니다.
- Agent Plasticity: peak score 외에 경험량당 개선과 regression 누적을 함께 측정하면 어떨까?
fix rate − regression cost로 학습 곡선을 만들면 실패를 빨리 고치지만 기존 능력을 잃는 optimizer를 구분할 수 있을까? - Environmental Novelty: API·output format이 바뀐 뒤 오래된 Capability patch와 Steering rule 중 무엇이 먼저 깨질까? patch의 durability를 환경 변화 후 회복 시간까지 확장해 측정할 수 있을까?
- MemCo: 실제 사용자 정답이 없는 환경에서 여러 agent의 불일치를 진단 후보로 삼고, 실행 가능한 local invariant로 확인하면 gold-label 의존성을 줄일 수 있을까? 합의가 잘못된 경우를 별도로 검증해야 한다.
- SCDP: 다음 batch 실행, dev 평가, 진단 심화, 과거 후보로 rebase 중 무엇을 할지 계산 비용과 정보 가치로 선택할 수 있을까? 현재의 “train 개선 때 dev 실행” 규칙보다 효율적일까?
- Generalization Tax / LoGRA: 같은 총 예산에서 weight update와 harness update를 비교하고 결합하면, domain adaptation과 기존 task regression 사이의 tradeoff가 어떻게 달라질까?
참고자료
정리 범위와 근거 메모
읽은 범위: v1 LaTeX 본문과 부록 A–R, 표·수식·그림 caption, Appendix P의 세 session 지시문. 근거는 원문 PDF, LaTeX 본문, 실험, 부록. 그래프를 눈대중으로 읽은 수치는 사용하지 않았다. 논문 내용과 아래 AI 해석·후속 질문의 정리자 해석을 구분한다.
수치 주의: v1의 §5.2에는 표와 맞지 않는 증가폭이 있다. 이 노트는 표의 점수를 그대로 옮기고 차이는 별도로 계산했다. SWE-Bench Pro의 46.9−37.3=9.6%p인데 해당 문장은 +8.4%p로 적는다. strongest automated baseline 대비 차이도 SWE-Bench Pro는 4.4%p, Terminal-Bench 2.0은 6.7%p인데 본문은 각각 +6.2, +4.4로 적는다. Abstract·Introduction·Conclusion의 요약값은 이 표 기반 차이와 맞는다.
용어 정리
| 용어 | 이 논문에서의 뜻 |
|---|---|
| Harness | prompt·tool·middleware로 이루어진 agent 외부 실행 장치 |
| Offline optimization | 배포 전에 train/dev에서 harness를 개선하는 단계. 저장된 고정 로그만 쓰는 방식은 아니며 새 rollout을 생성함 |
| Capability patch | executable code·tool 기능·orchestration 변경 |
| Steering patch | 실행 기능을 유지하며 prompt·docstring·hook text를 변경 |
| Same-batch verification | 수정 전후를 같은 train task batch에서 재실행해 비교 |
| Regression | 원래 통과한 task가 변경 후 실패하는 현상 |
| EvoDAG | harness 버전·diff·평가·교훈을 보관하는 optimizer 이력 |
| Rebase / cherry-pick | 다른 후보를 기반으로 다시 시작 / 특정한 좋은 diff만 가져오기 |
| Textual gradient | trace로 원인을 추론하고 개입을 시험하는 업데이트 신호의 비유 |
| Pass@1 | 한 번의 task 시도에서 성공할 확률. 여기서는 고른 harness를 반복 평가해 추정 |
| Stateful / stateless | 이 문맥에서는 task 사이 상태·경험이 지속되는지의 구분 |
| %p / pp | 두 백분율 점수의 차이. 상대 증가율과 구분 |